1. 课程导入
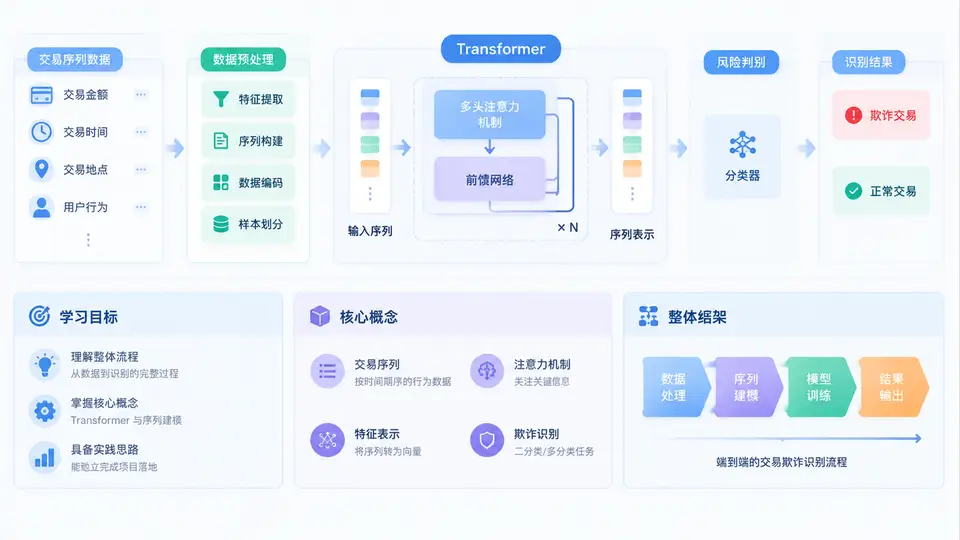
欢迎进入《Transformer交易序列欺诈识别实战》。在金融风控与反欺诈场景中,交易数据天然具有时序性、事件性、强关联性:一笔欺诈往往不是孤立发生的,而是由注册、登录、绑卡、转账、提现、退款等多个事件在时间轴上串联形成。传统基于单条交易的特征工程与树模型,擅长处理静态表格特征,却难以充分刻画“行为序列中的异常模式”。本课程的核心,就是使用Transformer及其序列建模思想,把交易事件序列转化为可学习、可解释、可上线的欺诈识别能力。
本章不涉及复杂模型推导,而是帮助你建立全局认知:这门课要解决什么问题、需要哪些前置知识、30章内容如何组织、最终你能交付什么。请把本章当作一张“作战地图”,后续每一章都会在这张地图上落位。
一、学习目标:从会调用到能落地
完成本课程后,你应当能够独立完成一条从数据到模型的交易欺诈识别流水线,并具备工程化与复盘能力。具体目标分为四层:
- 概念层:理解交易序列、事件、位置编码、自注意力、掩码、序列分类与序列标注等核心概念,能区分它们与普通表格建模的差异。
- 方法层:掌握交易序列的构造、特征工程、词表/嵌入设计、Transformer编码器搭建、训练目标选择与类别不平衡处理。
- 实战层:能够使用PyTorch实现一个可训练的Transformer欺诈识别模型,完成数据加载、训练、验证、推理与指标评估。
- 工程层:理解离线评估与在线推理的差异,掌握模型导出、阈值选择、漂移监控、可解释性分析与常见故障排查。
课程定位:本课程不是“Transformer论文精读课”,也不是“风控业务概论课”,而是一门以交易序列欺诈识别为目标的实战课。所有模型知识都服务于一个明确任务:在大量正常交易中,尽可能早、尽可能准地识别出欺诈行为,并控制误杀。
二、核心概念:先建立正确的“语言体系”
在进入代码之前,必须先统一术语。交易欺诈识别中的Transformer,并不是直接处理“金额、时间、商户号”这些原始字段,而是先把每笔交易或每个事件转化为一个,再把用户一段时间内的行为组织成序列,最后让模型学习序列中的上下文依赖。
| 概念 | 在本课程中的含义 | 常见误区 |
|---|---|---|
| 交易序列 | 按时间排序的用户行为事件集合,如登录→浏览→下单→支付→退款 | 把无序交易集合直接当作序列,忽略时间顺序 |
| 事件 | 将一笔交易或一个行为编码为向量,包含类型、金额、渠道、设备等字段 | 只做ID嵌入,丢失数值特征的连续信息 |
| 位置编码 | 向模型注入事件发生的先后顺序与时间间隔信息 | 认为Transformer自带顺序感知,忽略位置编码 |
| 自注意力 | 让序列中每个事件与其他事件交互,捕捉长距离依赖 | 把注意力权重直接等同于业务因果解释 |
| 掩码 | 训练时遮住未来事件,防止信息泄漏;或屏蔽填充位置 | 训练集和验证集构造方式不一致,导致指标虚高 |
| 序列分类 | 输出整个序列是否欺诈的概率,适合账户级/会话级判断 | 与序列标注混淆,标注是给每个事件打标签 |
其中,位置编码和掩码机制是交易序列建模中最容易出错的两个点。交易数据的时间间隔并不均匀:两笔交易可能相隔1秒,也可能相隔3天。如果只用简单的顺序位置编码,模型无法感知真实时间跨度。因此本课程会专门讨论时间感知的位置编码与时间差特征。
学习建议:每学完一个概念,都问自己三个问题:它在交易场景中对应什么?如果去掉它会怎样?它可能引入什么偏差?这三个问题能帮你避免“只会调包、不会排错”。
三、整体框架:30章如何组织
课程按照“认知—数据—模型—训练—评估—工程—复盘”的路径展开,共30章。你可以把它理解为一条逐步加压的实战路线,而不是零散知识点堆叠。
- 导入与问题定义(第1—3章):建立学习目标、核心概念、欺诈识别任务定义与评价指标。
- 数据与特征(第4—9章):交易数据解析、序列构造、时间特征、类别特征、数值特征、词表与嵌入设计。
- 模型原理与实现(第10—17章):自注意力、多头注意力、位置编码、编码器堆叠、序列分类头、损失函数与不平衡处理。
- 训练与调优(第18—23章):数据划分、训练循环、学习率调度、正则化、早停、超参数搜索与消融实验。
- 评估与解释(第24—27章):离线指标、阈值选择、注意力可视化、特征重要性、误杀与漏杀分析。
- 工程落地与复盘(第28—30章):模型导出、在线推理、漂移监控、A/B测试、故障排查与课程总结。
为了让你更直观地看到整体结构,下面给出一个简化的课程框架图。它不涉及具体代码,只表达从原始交易到欺诈决策的主链路。
这张图强调了两个关键点:第一,Transformer只是链路中的一环,前面的序列构造和特征嵌入决定了模型上限;第二,欺诈识别不是“训练完就结束”,训练与评估闭环、阈值选择和监控同样决定业务效果。
四、案例场景:一个典型的交易欺诈序列
假设某用户账户在短时间内出现如下事件序列:
时间        事件类型     金额      设备ID     地理位置
10:00:01   登录         -         D-8812     城市A
10:00:15   修改密码     -         D-8812     城市A
10:01:02   绑定新卡     -         D-8812     城市A
10:02:10   转账         9800      D-8812     城市A
10:02:40   转账         9900      D-8812     城市A
10:03:05   提现         5000      D-8812     城市A
如果只看单笔转账,金额可能并未超过风控阈值;但把整个序列输入Transformer后,模型可以捕捉到“登录→改密→绑卡→连续转账→提现”这一高风险模式。自注意力会让“修改密码”和“绑定新卡”对后续转账事件产生较高关联权重,从而提升整段序列的欺诈概率。
与之相对,一个正常用户的序列可能是:登录→浏览→下单→支付→确认收货,事件类型分布、时间间隔、金额分布都与欺诈序列存在差异。课程后续会使用类似结构的数据集进行实战演练。
重要提醒:交易数据涉及隐私与合规。实战中必须使用脱敏数据或公开模拟数据,禁止将真实用户敏感信息上传到第三方平台。课程示例数据均为构造数据,仅用于教学。
五、常见误区与复盘:初学者最容易踩的坑
在正式进入后续章节前,先列出几个高频误区。它们看似基础,却直接影响模型是否可信。
- 误区一:把序列当表格。直接把每笔交易的特征拼接成宽表,丢失事件顺序和上下文,Transformer的优势无法发挥。
- 误区二:忽视时间泄漏。构造训练样本时使用了未来事件的信息,导致离线指标很高,上线后效果骤降。
- 误区三:只看准确率。欺诈样本通常极少,准确率会被正常样本主导。应重点关注召回率、精确率、F1、AUC与PR-AUC。
- 误区四:注意力权重等于解释。注意力高不代表因果强,解释性分析需要结合梯度、遮挡实验和业务规则。
- 误区五:忽略阈值选择。模型输出概率后,阈值决定误杀与漏杀的平衡,必须结合业务成本确定。
复盘方法:每完成一个实验,记录四件事——数据版本、特征版本、模型配置、评估指标。没有记录的实验等于没有发生,后续无法复现,也无法定位问题。
本章建立了课程的整体认知:学习目标聚焦“能落地”,核心概念围绕“序列、、位置、注意力、掩码、分类”,整体框架覆盖数据、模型、训练、评估与工程,案例场景展示了交易序列欺诈识别的典型形态,误区复盘则提前标出了高风险区域。接下来,你将进入任务定义与评价指标的学习,把“识别欺诈”这一模糊目标转化为可计算、可优化的具体问题。