3. 代价敏感学习核心概念
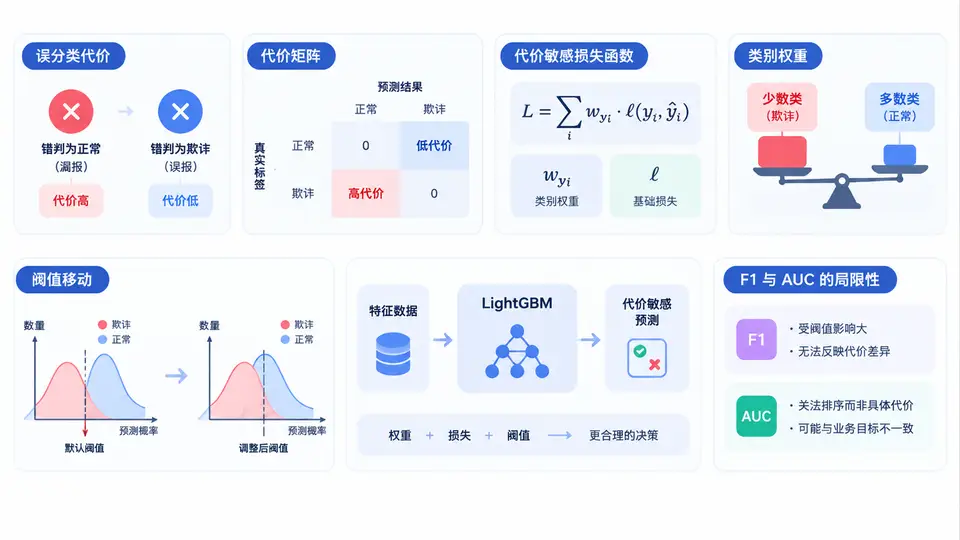
在交易欺诈检测中,把一笔正常交易误判为欺诈,通常只是让用户多一次验证;而把一笔欺诈交易误判为正常,可能直接造成资金损失。两者错误并不等价,这正是代价敏感学习要解决的核心问题。本节围绕误分类代价、代价矩阵、代价敏感损失函数、类别权重、阈值移动,以及F1与AUC等评估指标的局限性展开,帮助你建立“按业务代价优化模型”的思维框架。
一、误分类代价与代价矩阵
传统分类器默认所有错误代价相同,目标是最大化准确率。但在欺诈场景中,不同错误的代价差异巨大。我们用误分类代价量化这种差异:把负类判为正类的代价记为 C(0,1),把正类判为负类的代价记为 C(1,0)。在欺诈检测里,正类通常是欺诈,负类是正常交易,因此 C(1,0) 往往远大于 C(0,1)。
把这些代价组织成表格,就是代价矩阵。它明确告诉模型:哪些错误更不可接受。下面是一个典型的欺诈检测代价矩阵示例。
| 真实类别 \ 预测类别 | 预测为正常 | 预测为欺诈 |
|---|---|---|
| 真实为正常 | 0(正确) | 1(误报,用户打扰) |
| 真实为欺诈 | 20(漏报,资金损失) | 0(正确) |
矩阵中的数值不必是真实金额,可以是相对权重。关键是让模型知道:漏掉一笔欺诈的代价,是误报一笔正常交易的20倍。代价矩阵一旦确定,后续的损失函数、类别权重和阈值选择都应围绕它展开。
二、代价敏感损失函数与类别权重
标准交叉熵损失对每个样本一视同仁。代价敏感损失函数则给不同样本或不同类别加权,使模型在训练时更关注高代价错误。常见做法有两种:一是直接在损失中乘以代价系数;二是通过类别权重调整正负样本的贡献。
在LightGBM中,最直接的实现方式是设置 scale_pos_weight 或使用 class_weight。例如,当欺诈样本占比极低且漏报代价高时,可以这样配置:
params = {
    "objective": "binary",
    "metric": "auc",
    "scale_pos_weight": 20,   # 正类权重,近似漏报代价/误报代价
    "learning_rate": 0.05,
    "num_leaves": 31,
    "feature_fraction": 0.8,
    "bagging_fraction": 0.8,
    "bagging_freq": 5
}
这里的 scale_pos_weight=20 表示正类样本在损失中被放大20倍,与代价矩阵中“漏报代价是误报20倍”形成对应。需要注意的是,类别权重改变的是训练时的优化方向,并不直接等于最终业务代价;它只是让模型更倾向于把可疑样本判为欺诈。
提示:类别权重不是越大越好。权重过高会导致大量误报,用户体验和人工审核成本急剧上升。建议从代价矩阵的比例出发,再通过验证集上的业务代价曲线微调。
三、阈值移动:从概率到决策
LightGBM输出的是概率,而业务需要的是“是否拦截”的决策。默认阈值0.5并不适用于代价敏感场景。当漏报代价远高于误报代价时,应降低阈值,让更多可疑交易被拦截。
阈值移动的本质是:在概率排序不变的前提下,改变决策边界,从而在误报和漏报之间重新分配代价。我们可以遍历不同阈值,计算总业务代价,选择代价最小的阈值。
import numpy as np
from sklearn.metrics import confusion_matrix

def total_cost(y_true, y_prob, threshold, c_fp=1, c_fn=20):
    y_pred = (y_prob >= threshold).astype(int)
    tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()
    return fp * c_fp + fn * c_fn

thresholds = np.arange(0.05, 0.95, 0.01)
costs = [total_cost(y_val, prob_val, t) for t in thresholds]
best_threshold = thresholds[np.argmin(costs)]
print("最佳阈值:", best_threshold, "最小总代价:", min(costs))
这段代码展示了代价敏感决策的完整流程:先得到概率,再按业务代价选择阈值。它比单纯调整类别权重更贴近最终目标,因为阈值直接作用于决策结果。
四、F1与AUC等评估指标的局限性
F1和AUC是欺诈检测中常用的指标,但在代价敏感场景下,它们存在明显局限。
- F1假设精确率和召回率同等重要,无法体现“漏报比误报贵20倍”这一业务事实。
- AUC衡量的是排序能力,与具体阈值无关,因此无法反映某个决策阈值下的真实业务代价。
- 准确率在极不平衡数据中几乎失效,把所有样本判为正常也能获得很高准确率。
更合理的做法是引入代价敏感指标,例如总业务代价、单位样本平均代价,或代价曲线。下面是一个对比清单,帮助你在不同阶段选择评估方式。
| 评估指标 | 适用阶段 | 主要局限 |
|---|---|---|
| AUC | 模型排序能力初筛 | 与阈值无关,不反映业务代价 |
| F1 | 类别相对均衡时 | 假设误报与漏报同等重要 |
| 总业务代价 | 最终决策与阈值选择 | 依赖代价矩阵的准确性 |
| 代价曲线 | 多阈值对比与汇报 | 需要业务方参与定义代价 |
误区:很多团队在离线阶段只盯着AUC提升,上线后却发现欺诈损失没有下降。原因往往是AUC提升来自排序微调,而决策阈值仍固定在0.5,没有按代价矩阵移动。评估指标必须与业务代价对齐,否则模型优化方向可能完全偏离。
五、案例复盘:一次阈值调整带来的代价下降
某支付团队最初使用默认0.5阈值,AUC为0.93,但每月欺诈损失较高。引入代价矩阵后,他们发现漏报代价约为误报代价的25倍。于是将阈值从0.5下调至0.18,并重新计算验证集上的总代价。
阈值=0.50  误报=1200  漏报=85   总代价=1200*1 + 85*25 = 3325
阈值=0.18  误报=4300  漏报=21   总代价=4300*1 + 21*25 = 4825
阈值=0.12 误报=6800 漏报=9 总代价=6800*1 + 9*25 = 7025结果显示,阈值0.18虽然误报增加,但漏报大幅减少,总代价反而低于0.5。这个案例说明:最优模型不等于最优决策,代价敏感学习必须把损失函数、类别权重和阈值移动串联起来,才能把模型概率转化为业务价值。
核心结论:代价矩阵定义“什么错更贵”,代价敏感损失和类别权重让模型在训练时关注高代价错误,阈值移动把概率转化为代价最小化的决策,而评估指标必须从AUC/F1转向总业务代价。四者缺一不可。