1. 课程导入
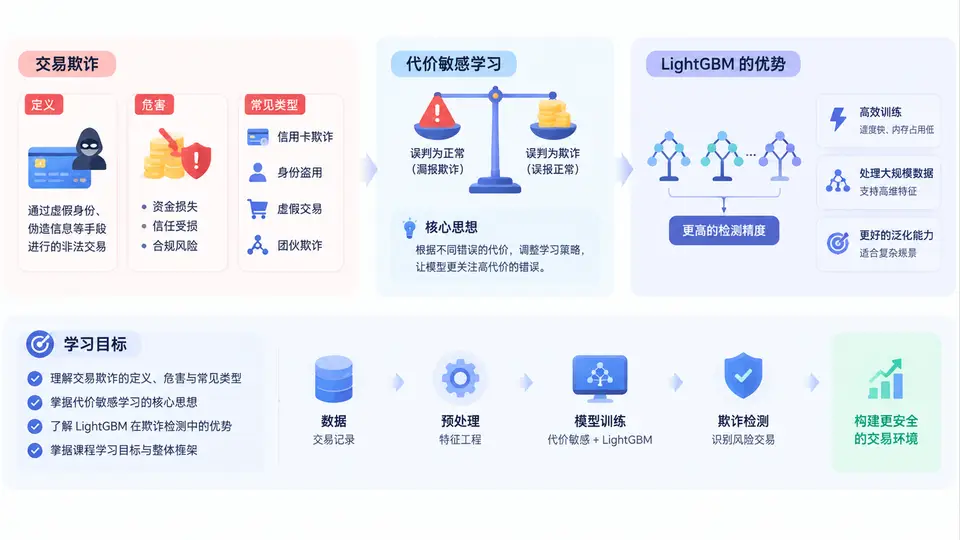
1.1 交易欺诈的定义与危害
交易欺诈是指个人或组织在交易过程中,通过虚构事实、隐瞒真相、冒用身份、篡改数据等手段,非法获取资金、商品或服务的行为。在数字化支付、电商、信贷、保险等场景中,交易欺诈已成为企业风控体系面临的核心威胁之一。
其危害体现在多个层面:直接资金损失,如盗刷、拒付、虚假交易导致商户和收单机构承担退款;运营成本上升,人工审核、客服处理、争议仲裁消耗大量资源;用户体验受损,过度拦截正常交易会造成误杀,导致客户流失;合规与声誉风险,反洗钱、数据安全等监管要求日趋严格,欺诈事件可能引发处罚与信任危机。
1.2 常见交易欺诈类型
理解欺诈类型是构建检测模型的前提。常见类型包括:
- 盗卡盗刷:攻击者窃取银行卡信息后发起未经授权的消费或转账。
- 账户接管:通过撞库、钓鱼等方式获取用户账户权限,转移资金或下单。
- 虚假申请:使用伪造身份或虚假资料申请信贷、补贴,骗取授信额度。
- 商户合谋:商户与持卡人串通,制造虚假交易套取银行资金或奖励。
- 退款欺诈:用户收到商品后谎称未收到,发起拒付并保留商品。
- 洗钱型交易:通过高频、小额、多账户交易掩盖资金来源。
这些类型在数据分布、行为模式、标签获取难度上差异显著,单一规则难以覆盖,需要机器学习模型进行动态识别。
1.3 代价敏感学习的核心思想
在欺诈检测中,两类错误的代价极不对称。将正常交易误判为欺诈(假阳性,FP),通常只带来一次人工复核或用户打扰;而将欺诈交易误判为正常(假阴性,FN),则可能造成直接资金损失,且金额可能远高于审核成本。传统分类模型默认两类错误代价相同,以准确率为优化目标,容易在极度不平衡数据中偏向多数类,导致欺诈召回率偏低。
代价敏感学习的核心思想是:在模型训练或决策阶段显式引入不同错误的代价权重,使模型更关注高代价错误。常见实现方式包括:
- 样本加权:为欺诈样本赋予更高权重,让损失函数对漏判更敏感。
- 阈值调整:在预测概率上选择使总代价最小的分类阈值,而非默认0.5。
- 代价敏感损失:直接修改损失函数,如加权交叉熵、Focal Loss等。
- 后处理决策:结合业务规则与代价矩阵,对模型输出进行二次决策。
1.4 LightGBM在欺诈检测中的优势
LightGBM是基于梯度提升决策树(GBDT)的高效实现,在欺诈检测任务中具有显著优势:
- 处理类别不平衡:通过
scale_pos_weight、is_unbalance等参数直接支持样本加权。 - 训练速度快:基于直方图算法和Leaf-wise生长策略,适合大规模交易数据。
- 内存占用低:对高维稀疏特征和类别特征支持良好,减少特征工程负担。
- 可解释性较强:提供特征重要性、SHAP值等工具,便于风控人员理解模型决策。
- 灵活的自定义损失:支持自定义目标函数和评估函数,便于实现代价敏感学习。
相比逻辑回归和随机森林,LightGBM在保持高精度的同时,更适合实时或准实时风控场景。
1.5 方法流程:从数据到代价敏感决策
本课程将围绕以下流程展开实战:
| 阶段 | 关键任务 | 产出 |
|---|---|---|
| 数据理解 | 分析交易字段、标签分布、欺诈类型 | 数据字典与分布报告 |
| 特征工程 | 构造行为、时序、聚合、设备等特征 | 训练集与验证集 |
| 代价定义 | 估算FP与FN的业务代价,构建代价矩阵 | 代价权重与阈值策略 |
| 模型训练 | 使用LightGBM加权训练与调参 | 代价敏感模型 |
| 评估决策 | 基于总代价、召回率、精确率选择阈值 | 上线决策规则 |
在代码层面,核心训练片段通常如下:
import lightgbm as lgb

params = {
    'objective': 'binary',
    'metric': 'auc',
    'scale_pos_weight': 50,   # 欺诈样本权重
    'learning_rate': 0.05,
    'num_leaves': 63,
    'feature_fraction': 0.8,
    'bagging_fraction': 0.8,
    'bagging_freq': 5,
    'verbose': -1
}

train_data = lgb.Dataset(X_train, label=y_train)
valid_data = lgb.Dataset(X_valid, label=y_valid, reference=train_data)

model = lgb.train(
    params,
    train_data,
    num_boost_round=500,
    valid_sets=[valid_data],
    callbacks=[lgb.early_stopping(50)]
)
scale_pos_weight不应简单设为负正样本比,而应结合代价矩阵进行校准,避免过度偏向欺诈类导致误杀率飙升。
1.6 案例场景:电商支付风控
假设某电商平台日均交易100万笔,欺诈交易占比约0.2%。若模型漏判一笔欺诈,平均损失500元;若误判一笔正常交易,人工复核成本约5元。此时FN代价是FP代价的100倍。若直接使用默认阈值,模型可能只召回60%的欺诈,造成大量漏判。通过引入代价敏感学习,将欺诈样本权重提高,并在验证集上以“总代价最小”为目标搜索阈值,可将召回率提升至85%以上,同时将误杀率控制在可接受范围。
1.7 常见误区与复盘
- 误区一:把代价敏感等同于简单加权。加权只是手段之一,阈值决策和后处理同样关键。
- 误区二:忽略标签延迟。欺诈标签往往在拒付发生后才能确认,训练时需考虑标签成熟度。
- 误区三:用测试集反复调阈值。阈值应在验证集上确定,测试集仅用于最终评估。
- 误区四:忽视特征穿越。使用未来信息构造特征会导致离线指标虚高,上线后失效。
复盘时,应同时关注总代价、召回率、精确率、误杀率四个指标,并结合业务反馈持续迭代。
1.8 课程学习目标与整体框架
通过本课程,你将掌握:
- 交易欺诈的业务背景与数据特点;
- 代价敏感学习的原理与实现方式;
- LightGBM在欺诈检测中的建模流程与调参技巧;
- 基于代价矩阵的阈值优化与模型评估;
- 从离线实验到线上部署的完整实战能力。
课程整体框架分为四个模块:业务与数据基础、代价敏感理论、LightGBM实战、评估与部署。每章均配有代码示例、参数说明和业务复盘,帮助你在真实场景中落地代价敏感学习。