3. Kafka核心概念
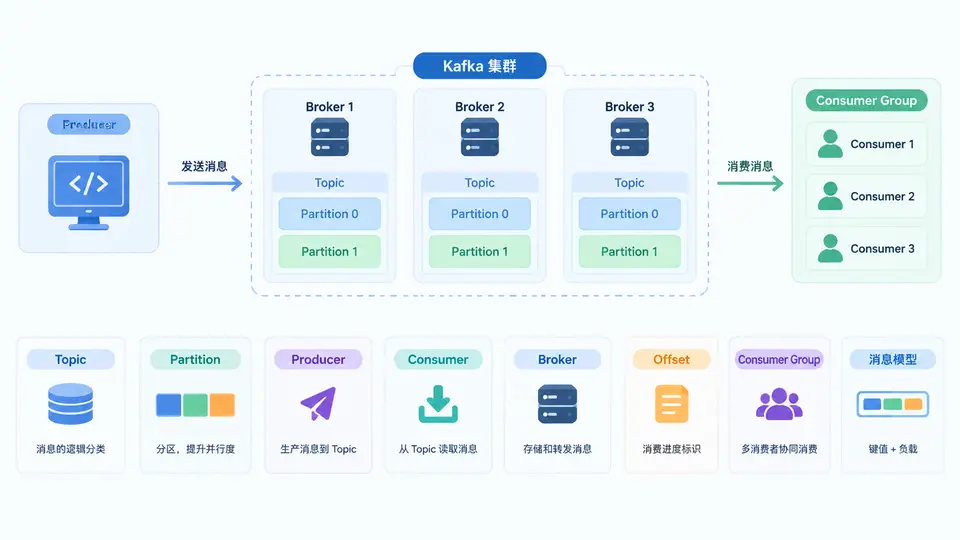
在实时交易风控链路中,Kafka承担的是“高吞吐、可回放、可水平扩展”的事件总线角色。要把它用好,不能只停留在“发消息、收消息”的层面,而必须理解它背后的分区日志模型。本节围绕八个核心概念展开,并结合风控场景说明它们如何协同工作。
一、核心原理:Kafka本质是分布式提交日志
Kafka的消息不是“队列里的一条记录”这么简单,它更准确的抽象是分区内的追加日志。每条消息被追加到某个Partition末尾,并分配一个单调递增的编号,这个编号就是Offset。消费者不删除消息,只记录自己消费到哪个Offset,因此消息可以被重复读取,这对风控规则回放、模型回溯验证非常关键。
- Topic:逻辑上的消息分类,例如
trade-events、risk-alerts。它是业务命名的边界,不是物理存储单元。 - Partition:Topic的物理分片,是并行与顺序的基本单位。同一Partition内严格有序,不同Partition之间不保证顺序。
- Broker:Kafka服务节点,负责存储Partition副本并处理读写请求。多个Broker组成集群,Partition的Leader分布在不同的Broker上。
- Producer:消息生产者,决定消息写入哪个Partition,并可通过acks、重试、幂等性控制可靠性。
- Consumer:消息消费者,按Offset拉取消息,自行控制消费进度。
- Consumer Group:消费者组,组内每个Partition同一时刻只被一个Consumer消费,从而实现并行消费与故障转移。
- Offset:消息在Partition中的位置编号,也是消费进度的游标。
关键结论:Kafka的并行度上限由Partition数量决定;消费顺序只在Partition内成立。风控中若要求“同一账户的交易严格有序”,就必须让同一账户的消息进入同一Partition。
二、方法流程:一条交易消息的完整旅程
以实时交易风控为例,一笔支付交易产生后,会经历如下链路:
- 交易系统作为Producer,将交易事件序列化后发送到Topic
trade-events。 - Producer根据消息Key(通常是账户ID或卡号)计算分区:
hash(key) % partitionNum,确保同一账户进入同一Partition。 - Broker将消息追加到对应Partition的Leader副本,并按配置同步到Follower副本。
- 风控引擎作为Consumer Group
risk-engine的成员,拉取消息并执行规则计算。 - Consumer处理成功后提交Offset,表示“这条消息已消费完成”。
- 若命中高风险规则,风控引擎再向Topic
risk-alerts发送告警事件,供下游处置系统消费。
# 创建交易事件Topic:6个分区,副本因子2
kafka-topics.sh --create \
  --topic trade-events \
  --partitions 6 \
  --replication-factor 2 \
  --bootstrap-server kafka1:9092

# 查看Topic详情
kafka-topics.sh --describe \
  --topic trade-events \
  --bootstrap-server kafka1:9092

# 消费组进度查看
kafka-consumer-groups.sh --describe \
  --group risk-engine \
  --bootstrap-server kafka1:9092
执行消费组查看命令后,典型输出如下,其中 CURRENT-OFFSET 与 LOG-END-OFFSET 的差值就是消费积压:
GROUP        TOPIC        PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
risk-engine  trade-events 0          152340          152340          0
risk-engine  trade-events 1          148221          150002          1781
risk-engine  trade-events 2          160011          160011          0
三、场景案例:风控链路中的分区与消费组设计
假设交易峰值每秒5万笔,风控规则需要按账户维度做滑动窗口统计。设计要点如下:
| 设计项 | 选择 | 原因 |
|---|---|---|
| 消息Key | 账户ID | 保证同一账户交易进入同一Partition,窗口统计不乱序 |
| Partition数量 | 12 | 支撑并行消费,同时避免过多分区增加元数据与再平衡成本 |
| Consumer Group | risk-engine,6个实例 | 每个实例消费2个Partition,实现水平扩展 |
| Offset提交 | 处理成功后手动提交 | 避免“先提交后处理”导致消息丢失 |
| 副本因子 | 2或3 | Broker故障时Partition仍可切换Leader继续读写 |
当某个风控实例宕机时,Consumer Group会触发再平衡,原本由它负责的Partition会分配给组内其他实例。此时Offset机制保证新实例从上次提交的位置继续消费,而不是从头开始。
四、误区与复盘:常见理解偏差
误区一:认为Topic分区越多越好。分区过多会导致文件句柄、内存和再平衡时间上升,且并非所有场景都需要极高并行度。
- 误区:Consumer数量可以超过Partition数量。 实际上,同一Consumer Group内多余的Consumer会处于空闲状态,因为一个Partition只能被组内一个Consumer消费。
- 误区:Kafka保证全局有序。 Kafka只保证单Partition内有序。若业务要求全局有序,只能使用单Partition,但这会牺牲并行能力。
- 误区:Offset提交越频繁越好。 频繁提交会增加Broker压力;提交间隔过大则故障时重复消费更多。风控场景通常选择“处理成功后批量提交”。
- 误区:消息被消费后就删除。 Kafka按保留策略删除,例如按时间或大小,与是否消费无关。这正是可回放能力的基础。
复盘建议:在风控链路中,优先确认三件事——消息Key是否保证账户级顺序、Partition数量是否匹配消费并行度、Offset提交策略是否与“至少一次”语义匹配。这三点决定了链路的正确性与可恢复性。
五、消息模型:发布订阅与消费组语义
Kafka同时支持两种消费模型:
- 发布订阅模型:不同Consumer Group各自独立消费同一Topic,互不影响。例如风控组和审计组都订阅
trade-events,各自维护Offset。 - 队列模型:同一Consumer Group内多个Consumer分摊Partition,实现并行处理与负载均衡。
因此,Kafka的消费语义可以概括为:组间广播、组内竞争。理解这一点,就能正确设计风控、告警、审计等多条下游链路,而不会误以为“一个消息只能被消费一次”。
把上述概念串起来看:Producer决定消息进入哪个Partition,Broker负责持久化与副本,Consumer Group负责并行消费与故障转移,Offset负责进度与回放。四者共同构成Kafka在实时交易风控中可靠、可扩展、可追溯的数据链路基础。