1. 课程导入
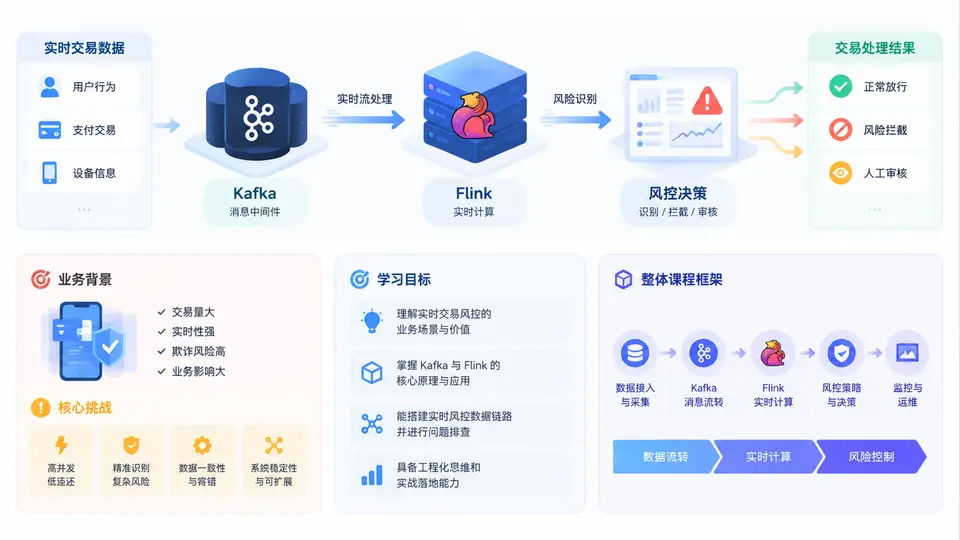
一、业务背景:为什么交易风控必须走向实时
在支付、电商、证券、消费金融等场景中,交易风控的核心任务是在一笔交易发生前后,快速判断它是否存在欺诈、盗刷、套现、洗钱、营销作弊等风险,并给出放行、拦截、二次验证或人工审核等决策。传统风控系统多以T+1离线批处理为主:白天交易数据落库,夜间跑规则和模型,第二天产出风险名单。这种模式适合事后审计,却无法应对“毫秒级盗刷”“秒杀羊毛党”“团伙集中套现”等实时攻击。
实时交易风控的目标,是把风险识别从“事后发现”前移到“事中拦截”。当用户点击支付的一瞬间,系统需要在几十毫秒到几百毫秒内完成:读取用户历史行为、计算近1分钟交易频次、判断设备与位置异常、匹配黑名单、调用模型评分,并返回决策结果。这要求数据链路具备低延迟、高吞吐、可回溯、可扩展的能力。Kafka与Flink正是构建这条链路的核心技术组合:Kafka承担高吞吐事件缓冲与解耦,Flink承担有状态流式计算与实时特征加工。
二、核心挑战:实时风控链路难在哪里
实时风控不是简单地把离线规则搬到流上,它面临一组相互制约的工程挑战。理解这些挑战,才能理解后续章节为什么这样设计。
- 低延迟与高吞吐的矛盾:大促峰值每秒数十万笔交易,单笔决策却要求百毫秒内完成。链路中任何一次同步远程调用、一次磁盘随机写、一次数据倾斜,都可能拖垮整体延迟。
- 状态与事件时间乱序:风控规则大量依赖“过去5分钟交易次数”“过去1小时不同设备数”等窗口统计。但网络抖动、分区并行、上游重试会导致事件乱序到达,必须用事件时间、水位线和允许迟到机制保证结果正确。
- 规则与特征的实时一致性:离线训练用的特征若与在线计算口径不一致,会导致模型线上效果骤降。特征口径、时间窗口、过滤条件必须在批流之间统一。
- Exactly-Once与资金安全:风控决策不能重复扣款、不能漏拦。Kafka事务、Flink检查点与幂等写入必须协同设计。
- 可观测与可回溯:一笔交易被拦截后,需要能还原当时用了哪些特征、命中了哪条规则、模型分数是多少。日志、指标、链路追踪缺一不可。
常见误区:很多团队一开始只关注“规则能不能跑通”,忽略了背压、检查点超时、Kafka分区倾斜和状态过大。结果上线后在大促峰值出现消费延迟飙升,风控决策从百毫秒退化到数秒,等于失效。实时链路的稳定性设计必须与业务规则同步规划。
三、核心原理:Kafka + Flink 在风控链路中的分工
Kafka在链路中扮演“实时数据总线”的角色:交易网关、用户行为、设备指纹、黑名单变更等数据源统一写入Kafka主题,下游Flink作业按需订阅。Kafka的分区机制提供水平扩展能力,副本机制提供容错,持久化日志支持回溯消费。Flink则扮演“有状态流处理引擎”的角色:它从Kafka消费事件,按事件时间开窗,维护用户、设备、IP等维度的状态,执行规则匹配、特征计算和模型调用,最终把决策结果写回Kafka或下游决策服务。
一个典型的实时风控数据链路可以概括为:数据源 → Kafka采集层 → Flink实时计算层 → 规则/模型决策层 → 决策结果输出 → 监控与回溯。其中Flink作业通常拆分为多个算子链:解析与清洗、维度关联、窗口聚合、规则匹配、模型打分、结果封装。每个环节都要考虑并行度、状态后端、检查点间隔和反压监控。
| 链路环节 | 核心技术 | 关键目标 | 典型风险 |
|---|---|---|---|
| 数据采集 | Kafka Producer、分区键设计 | 高吞吐、顺序性、可扩展 | 分区倾斜、消息丢失 |
| 实时计算 | Flink DataStream、窗口、状态 | 低延迟、事件时间正确性 | 乱序、状态膨胀、背压 |
| 规则决策 | 规则引擎、广播状态、模型服务 | 毫秒级匹配、动态更新 | 规则热更新不一致、远程调用超时 |
| 结果输出 | Kafka Sink、幂等写入 | 不重不漏、可追溯 | 重复决策、下游写入失败 |
| 监控回溯 | Metrics、日志、链路追踪 | 可观测、可复盘 | 指标缺失、日志无上下文 |
四、方法流程:从交易事件到风控决策
为了让后续章节有统一的心智模型,这里先给出端到端流程的简化版本。实际项目中会有更多分支,但主干一致。
- 事件接入:交易系统将支付请求封装为JSON消息,写入Kafka的
trade-events主题,分区键通常选择用户ID或商户ID,保证同一用户事件有序。 - 实时清洗与补全:Flink作业消费原始事件,过滤无效字段,关联用户画像、设备信息、商户黑名单等维度数据。
- 窗口特征计算:基于事件时间,计算近1分钟交易次数、近5分钟不同设备数、近1小时累计金额等特征,写入状态或特征存储。
- 规则匹配与模型打分:将实时特征与规则集匹配,命中高风险规则则直接拦截;否则调用模型服务获取风险分数。
- 决策输出:将决策结果写入
risk-decisions主题,下游决策服务消费后执行放行、拦截或二次验证。 - 监控与回溯:记录每笔决策的特征快照、规则命中情况和模型分数,供事后审计和模型迭代。
# 示例:创建风控链路核心Kafka主题
kafka-topics.sh --create \
  --bootstrap-server localhost:9092 \
  --topic trade-events \
  --partitions 12 \
  --replication-factor 3

kafka-topics.sh --create \
  --bootstrap-server localhost:9092 \
  --topic risk-decisions \
  --partitions 12 \
--replication-factor 3实践提示:分区数不是越多越好。分区过多会增加Flink算子状态分片和检查点开销;分区过少则限制吞吐。一般从峰值吞吐除以单分区处理能力估算,再预留30%余量。分区键要选择高基数且业务上需要保序的字段,例如用户ID,而不是交易ID。
五、案例场景:一笔可疑交易的实时拦截
假设用户A在10秒内连续发起5笔大额支付,且设备指纹从未出现过。交易事件进入Kafka后,Flink作业在1分钟滚动窗口内统计到该用户交易次数为5,累计金额超过阈值,同时设备维度特征显示“新设备+高频交易”。规则引擎命中“短时高频大额新设备”规则,直接输出拦截决策。整个过程从事件产生到决策输出约80毫秒。若采用离线T+1,这5笔交易可能已经完成,资金损失难以追回。
这个案例说明:实时风控的价值不仅在于“快”,更在于把多个维度的实时特征组合起来,形成离线难以捕捉的瞬时风险模式。Kafka保证事件不丢且可回放,Flink保证窗口计算和状态管理正确,两者结合才能支撑这种场景。
六、学习目标与整体课程框架
本课程围绕“能设计、能开发、能调优、能排障”四个目标展开。学完后,你应该能够独立搭建一条基于Kafka与Flink的实时交易风控数据链路,并具备在生产环境中定位延迟、状态、数据一致性问题的能力。
- 目标一:理解实时风控的业务模型与技术选型逻辑,能画出端到端链路架构。
- 目标二:掌握Kafka主题设计、分区策略、生产者与消费者调优。
- 目标三:掌握Flink DataStream API、事件时间、窗口、状态、检查点与Exactly-Once语义。
- 目标四:能实现规则匹配、实时特征计算、模型调用与决策输出,并完成监控与排障。
课程整体分为六个模块:基础与架构、Kafka采集层、Flink计算层、规则与模型决策层、性能与稳定性调优、综合实战与复盘。每个模块都会结合代码、配置和真实问题展开,避免只讲概念。本章作为导入,重点是建立全局视角:知道链路长什么样、难点在哪里、后续每一章解决什么问题。
本章小结:实时交易风控的核心矛盾是“低延迟决策”与“高吞吐、乱序、有状态计算”之间的工程平衡。Kafka解决数据缓冲与解耦,Flink解决有状态流式计算,二者共同构成实时风控数据链路的骨架。后续章节将逐层拆解采集、计算、决策、调优与排障,最终让你具备独立交付生产级链路的能力。