3. 交易数据认知
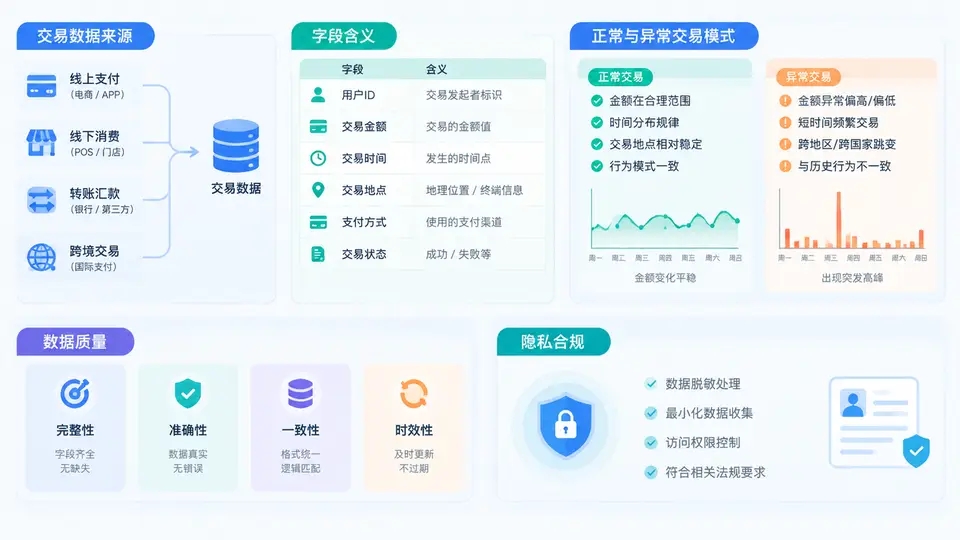
Isolation Forest 的检测效果,七成取决于你对交易数据的理解深度,三成才取决于模型参数。很多初学者拿到一份交易流水后,直接丢进模型跑出异常分数,结果发现排名靠前的全是"大额正常消费"或"凌晨系统批处理",而真正的盗刷、洗钱、薅羊毛却排在几百名开外。根本原因不是算法不行,而是没有先建立对交易数据的"业务认知"。本节从数据来源、字段语义、正常与异常模式、质量与合规四个维度,帮你把原始交易表变成模型可用的、有业务含义的特征空间。
一、交易数据的四类来源与采集边界
异常交易检测的数据通常来自以下四类系统,它们的字段结构、更新频率和可信度差异很大,直接决定了后续特征工程的策略。
| 数据来源 | 典型字段 | 更新频率 | 在异常检测中的作用 |
|---|---|---|---|
| 核心交易系统 | 交易号、账号、金额、时间、渠道、状态 | 实时/准实时 | 主表,提供行为主体与金额时间基线 |
| 支付网关/清算 | 商户号、MCC、卡BIN、响应码 | 分钟级 | 识别商户风险、拒付与异常授权 |
| 设备与终端 | 设备指纹、IP、GPS、操作系统 | 实时 | 识别异地登录、设备农场、模拟器 |
| 客户与账户 | 开户时间、KYC等级、风险评级 | 日级 | 提供账户画像,做分层基线 |
采集时要明确边界:只取检测必需字段,避免把身份证号、完整卡号、明文手机号等敏感信息带入特征表。实践中推荐在采集层就完成脱敏与哈希,让下游模型只接触不可逆的标识。
二、字段含义:从"列名"到"业务语义"
字段理解不能停留在字面。以最常见的交易表为例,几个关键字段需要特别澄清:
- 交易金额 amount:要区分"交易金额"与"结算金额",退款、冲正会产生负值或成对记录,直接取绝对值会掩盖异常。
- 交易时间 trans_time:注意时区与系统时间偏差,跨时区业务必须统一到 UTC 或业务主时区,否则"凌晨异常"会变成误报。
- 交易状态 status:成功、失败、处理中、已冲正。异常检测通常只对"成功"交易建模,但失败率突增本身也是强异常信号。
- 渠道 channel:APP、网银、柜面、API。不同渠道的正常金额分布差异极大,必须分渠道建立基线。
- 对手方 counterparty:收款账号或商户。同一账号短时间内对多个陌生对手方转账,是典型的洗钱/盗刷模式。
三、正常与异常交易模式:建立可对比的基线
Isolation Forest 的核心假设是"异常点更容易被随机切分孤立"。要让这个假设成立,前提是你能说清楚"正常长什么样"。正常交易通常具备以下特征:金额分布集中、时间符合用户作息、设备与地点稳定、对手方相对固定、频率平稳。异常则往往在某个或某几个维度上偏离基线。
常见的异常模式可以归纳为几类:
- 金额异常:单笔金额远超该账户历史分位数,或出现大量接近限额的整数金额。
- 时间异常:在用户从不活跃的时段(如凌晨3点)发生交易。
- 频率异常:短时间内高频小额交易,典型的"试探性盗刷"或"薅羊毛"。
- 地点/设备异常:异地登录后立即大额转账,或同一设备关联大量账户。
- 对手方异常:首次交易即向陌生账户大额转账,或对手方本身是高危名单。
下面是一段构造账户级行为特征的示例代码,把原始流水聚合成模型可用的向量:
import pandas as pd

# 假设 df 为原始交易流水,已按 account_id 分组
feat = df.groupby('account_id').agg(
    txn_count=('trans_id', 'count'),
    amount_mean=('amount', 'mean'),
    amount_std=('amount', 'std'),
    amount_max=('amount', 'max'),
    night_ratio=('hour', lambda s: ((s >= 0) & (s < 6)).mean()),
    distinct_counterparty=('counterparty', 'nunique'),
    distinct_device=('device_id', 'nunique'),
).reset_index()

# 缺失值处理:标准差为 NaN 说明只有一笔交易
feat['amount_std'] = feat['amount_std'].fillna(0)
print(feat.head())
这段代码把"每笔交易"聚合为"每个账户的行为画像",是异常检测中最常见的特征粒度。注意 night_ratio 这类比例特征比原始小时数更能表达"作息偏离"。
四、数据质量与隐私合规:不可跳过的前置关卡
数据质量问题会直接污染异常分数。常见问题包括:金额字段存在负值和零值、时间戳缺失或乱序、账号标识不统一(同一用户多个ID)、重复交易记录。建议在建模前执行一份质量清单:
- 检查关键字段缺失率,超过阈值的字段要么补齐要么剔除。
- 检查金额分布,识别异常极值和单位错误(元/分混用)。
- 检查时间范围,确认无未来数据泄漏。
- 检查账号唯一性,统一主键口径。
- 检查重复记录,按交易号去重。
一个实用的做法是建立"数据契约":上游系统承诺字段含义与更新频率,下游模型明确依赖哪些字段、容忍多大延迟。当上游字段变更时,异常检测的基线会漂移,必须触发重新评估。很多线上误报的根因,不是模型退化,而是上游悄悄改了字段口径。
五、常见误区与复盘要点
在本节结束前,复盘三个高频误区。第一,把"异常"等同于"欺诈":Isolation Forest 找的是统计意义上的离群点,大额正常消费、系统批处理、促销活动都会成为离群点,必须结合业务规则二次过滤。第二,忽略分层:不区分渠道、账户等级、地区就统一建模,会导致高活跃用户的正常行为被误判。第三,特征泄漏:把"是否已标记欺诈"这类标签字段误入特征,模型会给出虚高效果,上线后迅速失效。
建立正确的数据认知,本质上是把业务语言翻译成模型语言的过程。当你能清晰回答"这笔交易为什么正常、那笔为什么异常"时,Isolation Forest 才真正开始为你工作。