1. 课程导入
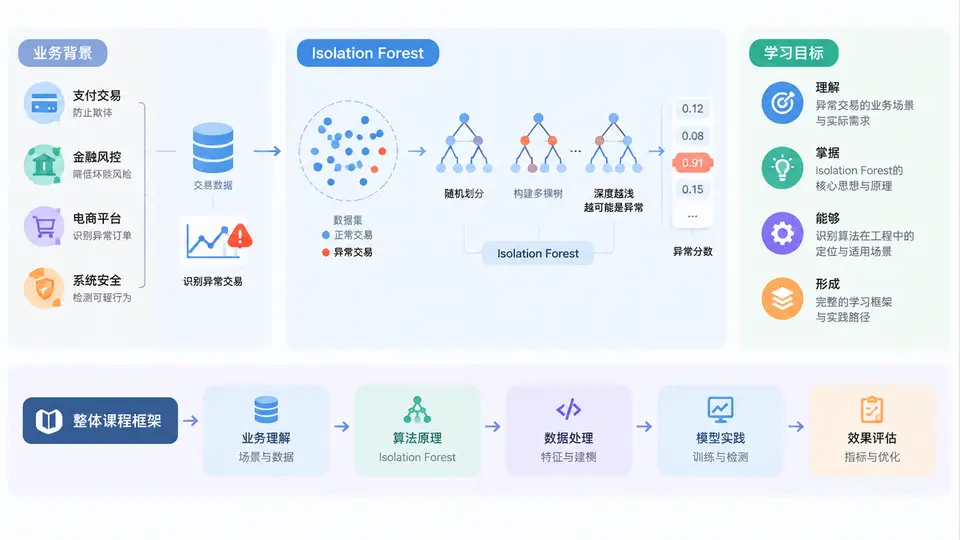
在支付、清算、风控与反欺诈系统中,异常交易检测是一项持续运行、直接影响资金安全与用户体验的核心任务。它要回答的问题很具体:在每天数百万甚至上亿笔交易里,哪些交易值得被拦截、复核或进一步调查?传统规则引擎擅长处理已知模式,例如“单笔金额超过 5 万元且收款方为高风险地区”,但面对新型欺诈、团伙化小额试探、账号盗用后的正常金额消费,规则往往滞后、维护成本高,且误报率难以控制。Isolation Forest(孤立森林)正是在这种“高维、无标签、异常稀少、需要快速响应”的场景中,成为异常交易检测的重要基线模型。
异常交易检测的业务背景
异常交易并不等同于欺诈交易。从业务视角看,它至少包含三类:第一类是欺诈型异常,如盗刷、伪卡、洗钱拆分;第二类是操作型异常,如商户误操作、系统重复扣款、汇率配置错误;第三类是行为型异常,如用户突然在异地大额消费、短时间高频下单。三类异常的共性是“偏离大多数正常样本的分布”,但它们的标签往往缺失或严重滞后。因此,风控团队通常先做无监督异常检测,再把高可疑名单交给人工审核或下游模型,而不是一开始就依赖有监督分类。
从工程约束看,异常交易检测还面临几个现实条件:
- 样本极度不平衡:异常占比可能低于 0.1%,有监督模型容易偏向多数类。
- 标签获取成本高:确认一笔欺诈需要人工调查、客诉核实甚至警方介入,周期长。
- 概念漂移明显:黑产手法、促销活动、节假日消费模式都会改变“正常”的边界。
- 响应时效要求高:支付链路通常要求毫秒级或秒级返回风险分,不能依赖离线批处理。
这些约束决定了:我们需要一个无需标签、训练快、对高维稀疏特征友好、能输出连续异常分的模型。Isolation Forest 恰好满足这些条件,并且实现简单、可解释性适中,适合作为异常交易检测的第一道无监督防线。
学习目标
完成本章及后续课程后,你应当能够达到以下目标:
- 理解异常交易检测的业务目标、数据形态与常见评估难点。
- 掌握 Isolation Forest 的核心思想:为什么“容易被孤立的点”更可能是异常。
- 能够独立完成从特征工程、模型训练、异常分输出到阈值选择的完整流程。
- 能够识别并处理实际落地中的误区,例如特征泄漏、阈值漂移、类别不平衡评估失真。
- 能够把 Isolation Forest 嵌入到风控系统中,与规则引擎、有监督模型和人工审核协同工作。
Isolation Forest 的定位
Isolation Forest 是一种基于树集成的无监督异常检测算法。它的核心假设非常直观:异常点是少数且与众不同的,因此在随机切分特征空间时,它们更容易被“孤立”出来,即需要更少的分裂次数就能被单独划分到一个叶子节点。相反,正常点密度高,需要更多次切分才能被隔离。基于这个假设,模型用“平均路径长度”衡量样本的异常程度,路径越短,异常分越高。
在异常交易检测的技术栈中,Isolation Forest 通常位于以下位置:
| 层级 | 典型方法 | 作用 | 与 Isolation Forest 的关系 |
|---|---|---|---|
| 规则层 | 黑白名单、限额、频控 | 拦截已知高风险行为 | 前置过滤,减少模型输入噪声 |
| 无监督层 | Isolation Forest、LOF、One-Class SVM | 发现未知异常模式 | 本课程核心,作为基线检测器 |
| 有监督层 | XGBoost、LightGBM、深度模型 | 利用历史标签精确分类 | 用 Isolation Forest 输出作为特征或候选筛选 |
| 决策层 | 人工审核、案件管理 | 确认与处置 | 消费异常分,形成闭环反馈 |
需要强调的是,Isolation Forest 不是“万能欺诈检测器”。它擅长发现全局稀疏区域的点,对局部密度异常、时间序列突变、团伙关联异常的捕捉能力有限。因此,本课程会把它放在“快速基线 + 候选生成”的位置,而不是替代全部风控逻辑。
学习建议:把 Isolation Forest 理解为一个“异常打分器”,而不是“欺诈分类器”。它的输出是连续分数,业务侧需要根据成本、收益和审核能力选择阈值。阈值不是模型参数,而是业务决策参数。
整体课程框架
本课程共 30 章,围绕“业务问题 → 算法原理 → 特征工程 → 模型训练 → 评估调优 → 工程落地”的主线展开。第 1 章建立业务背景与算法定位;后续章节会逐步深入:
- 原理篇:孤立树、路径长度、异常分公式、子采样与集成机制。
- 数据篇:交易流水字段解析、时间窗口特征、金额统计特征、类别编码与缺失值处理。
- 实战篇:使用 Python 与 scikit-learn 训练 Isolation Forest,输出异常分并做阈值分析。
- 评估篇:在无标签与少标签条件下,如何用业务指标、人工审核命中率和稳定性指标评估模型。
- 进阶篇:与规则引擎、有监督模型、流式计算和在线学习结合。
为了让读者对整体流程有直观认识,下面给出一个最小可运行的训练代码骨架。后续章节会逐行解释并扩展。
from sklearn.ensemble import IsolationForest
import pandas as pd

# 假设 df 为交易特征表,已去除主键与时间戳
X = df.select_dtypes(include=["number"]).fillna(0)

model = IsolationForest(
    n_estimators=200,
    max_samples="auto",
    contamination=0.01,
    random_state=42,
    n_jobs=-1
)

model.fit(X)
df["anomaly_score"] = -model.score_samples(X)  # 分数越高越异常
df["is_anomaly"] = model.predict(X)            # -1 表示异常,1 表示正常

print(df[["anomaly_score", "is_anomaly"]].describe())
常见误区预警:不要直接把 contamination 设为真实异常比例。真实异常比例通常未知且随时间变化,建议先用业务规则或人工审核样本估计一个范围,再通过阈值扫描确定最终决策边界。后续评估章节会详细展开。
一个典型场景:支付交易异常检测
假设你在一家支付公司负责风控算法。系统每天处理 500 万笔交易,字段包括用户 ID、商户 ID、金额、币种、设备指纹、IP 归属地、交易时间、历史成功率和近 1 小时交易频次。业务方希望在不增加太多人工审核量的前提下,发现“看起来不像该用户正常行为”的交易。
你可以先用 Isolation Forest 对数值型特征做无监督打分,把异常分最高的 0.5% 交易推送到审核队列。审核结果再回流为标签,用于后续有监督模型。这个过程中,Isolation Forest 的价值不是“直接判定欺诈”,而是用较低成本把可疑样本从海量交易中筛出来,让有限的人工审核资源集中在最值得看的部分。
本章的核心任务,就是帮助你建立这种“业务—算法—工程”三位一体的视角。接下来,我们会从孤立树的基本结构开始,逐步拆解 Isolation Forest 为什么有效、在什么条件下失效,以及如何把它真正用到异常交易检测的生产流程中。