3. 无监督学习概览
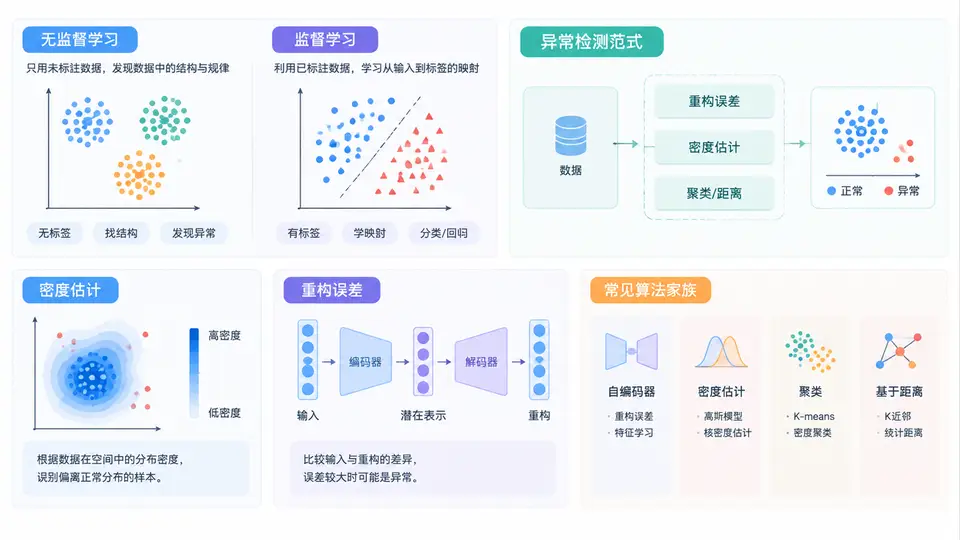
在交易反欺诈场景中,我们最常遇到的困境是:有标签的正常样本很多,但异常样本极少,甚至根本没有标签。监督学习需要大量标注好的“正常/异常”样本才能训练分类器,而现实中欺诈手法不断演化,昨天的异常标签对今天的新骗局往往失效。无监督学习正是为解决这类问题而生——它不依赖标签,而是从数据自身的分布结构中寻找“不合群”的样本。
一、无监督学习与监督学习的本质对比
监督学习的核心是学习一个映射函数 f(x) → y,其中 y 是人工标注的标签。模型通过最小化预测值与真实标签之间的损失来拟合决策边界。而无监督学习没有 y,它学习的是数据的内在结构:聚类、密度、低维流形或重构关系。异常检测通常被建模为“偏离正常结构”的问题,而非“分类正确与否”的问题。
| 维度 | 监督学习 | 无监督学习 |
|---|---|---|
| 输入数据 | 特征 + 标签 (x, y) | 仅特征 x |
| 学习目标 | 拟合决策边界或回归函数 | 刻画数据分布、聚类结构或重构模式 |
| 异常判定 | 分类器输出异常类别 | 偏离正常分布/高重构误差/低密度 |
| 标签依赖 | 强依赖,标注成本高 | 无标签依赖,适应新异常类型 |
| 典型算法 | 逻辑回归、XGBoost、随机森林 | AutoEncoder、Isolation Forest、LOF、One-Class SVM |
| 交易场景适用性 | 已知欺诈模式、标签充足时 | 新型欺诈、标签稀缺、概念漂移时 |
二、异常检测的三种范式
异常检测并非单一方法,而是围绕“什么是异常”形成了三种主流范式,理解它们的差异对后续选择 AutoEncoder 至关重要。
- 基于密度:正常样本位于高密度区域,异常样本落在低密度区域。代表算法有 KDE、LOF、GMM。优点是解释直观,缺点是高维空间中密度估计极不稳定。
- 基于距离/边界:正常样本彼此靠近,异常样本远离正常簇。代表算法有 KNN 距离、One-Class SVM、Isolation Forest。Isolation Forest 通过随机切分让异常点更快被“孤立”,在交易特征上表现稳健。
- 基于重构:正常样本可以被模型很好地压缩再还原,异常样本重构误差大。AutoEncoder、PCA 重构都属于这一类,也是本课程的主线方法。
三种范式并非互斥。实践中常把重构误差与密度分数、孤立分数做融合,形成多视角的异常评分。
三、密度估计与重构误差的数学直觉
密度估计试图回答“这个样本在正常分布下出现的概率有多大”。若 p(x) < τ,则判为异常。但高维交易特征中,样本稀疏,直接估计 p(x) 几乎不可行。重构误差提供了一条迂回路径:不显式建模概率密度,而是训练一个模型学习恒等映射 x → x,但中间经过低维瓶颈。正常样本能被有效压缩,异常样本压缩后信息丢失严重,重构误差自然变大。
异常分数 = || x - Decoder(Encoder(x)) ||²
判定规则:若 异常分数 > 阈值 τ,则标记为异常交易
这里的阈值 τ 通常由正常验证集重构误差的分位数确定,例如取 99% 分位数,意味着允许约 1% 的正常样本被误报。这个取舍直接对应风控中的召回率与误报率平衡。
四、常见算法家族与交易场景映射
下表梳理了无监督异常检测的主要算法家族及其在交易反欺诈中的典型用法,便于你建立全局选型视角。
| 算法家族 | 核心思想 | 交易场景示例 | 注意事项 |
|---|---|---|---|
| 统计方法 | 假设分布,计算偏离程度 | 单特征金额突变检测 | 高维失效,需特征工程 |
| 距离/密度 | LOF、KNN 距离 | 小额高频试探性盗刷 | 对参数 k 敏感,计算量大 |
| 孤立森林 | 随机切分快速孤立异常 | 多特征组合异常交易 | 对类别特征需编码 |
| One-Class SVM | 学习正常样本边界 | 已知正常交易轮廓 | 核函数与参数调优成本高 |
| 自编码器 | 重构误差衡量异常 | 高维交易序列、行为嵌入 | 需防止过拟合导致重构过好 |
五、误区与复盘:无监督不是“万能钥匙”
初学者常陷入几个典型误区。第一,认为无监督模型不需要任何验证。实际上,没有标签不代表没有评估,仍需要用少量已知异常做召回率验证,或用业务规则做交叉检查。第二,把重构误差直接等同于异常概率。重构误差大也可能因为样本噪声大或模型欠拟合,必须结合阈值校准和业务上下文。第三,忽略特征尺度。AutoEncoder 对输入尺度敏感,金额、频次、时间间隔量纲差异大时,必须做标准化或分位数变换,否则重构误差会被大尺度特征主导。
复盘一个典型流程:某支付平台用 AutoEncoder 对交易行为向量做无监督训练,正常样本重构误差集中在低分位,异常样本误差显著偏高。团队取 99.5% 分位作为阈值,先圈出约 0.5% 的可疑交易,再叠加“同一设备短时间多卡尝试”规则,最终将误报率控制在可接受范围。这个案例说明:无监督方法提供的是“异常候选”,而非最终判决,业务规则与人工经验仍是闭环中不可或缺的一环。