1. 课程导入
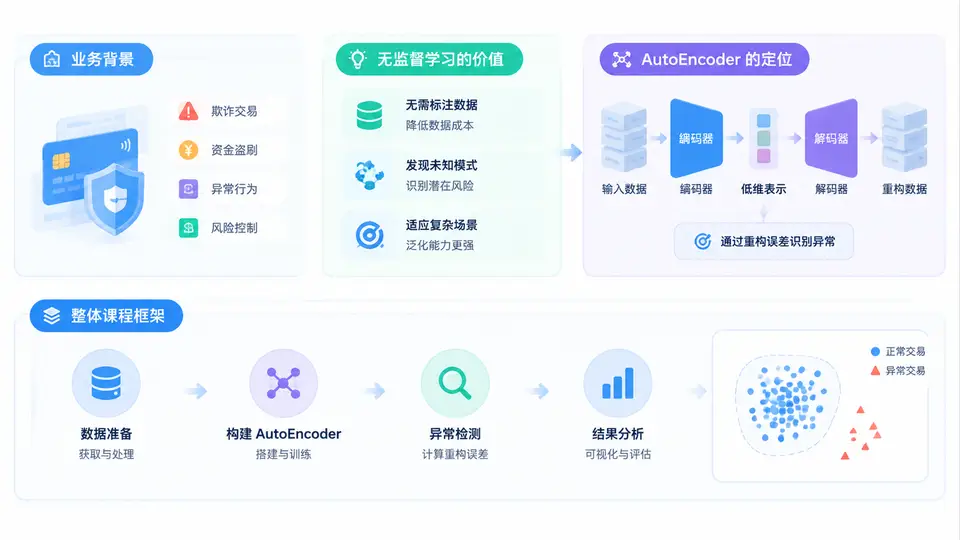
在支付、银行、电商、证券等交易密集型业务中,异常交易检测是风控体系的核心环节。它要回答的问题非常直接:这笔交易是否偏离了正常用户的正常行为?但真正落地时,团队很快会遇到三个现实约束:异常样本极少、异常形态不断变化、标注成本极高。传统有监督模型依赖大量已标注的欺诈样本,而欺诈者一旦改变手法,历史标签就会迅速失效。这正是无监督学习在本场景中具有独特价值的原因。
一、业务背景:异常交易检测为什么难
异常交易检测并不是简单的“二分类”。它的业务目标通常包括降低资损、减少误杀、提升审核效率,并满足合规与可解释性要求。以线上支付为例,正常交易占绝大多数,欺诈交易可能不足千分之一。若直接训练有监督分类器,会面临极端类别不平衡,模型容易偏向多数类,导致召回率不足。
更棘手的是,异常的定义会随时间漂移。今天表现为“短时间高频小额转账”的异常,明天可能变成“长期休眠账户突然大额消费”。有监督模型只能识别训练集中出现过的模式,对新型异常往往反应滞后。因此,业务需要一种能够从数据自身结构出发、发现“不像正常样本”的检测机制。
- 样本稀缺:欺诈标签获取周期长,且很多异常在发生后才能确认。
- 形态多变:黑产会主动规避规则和模型,异常模式持续演化。
- 误杀成本高:把正常用户判为异常,会直接影响体验和收入。
- 可解释性要求:风控审核需要知道“为什么这笔交易被拦截”。
二、无监督学习的价值:不依赖标签,先学会“正常”
无监督异常检测的核心思想是:正常行为高度重复且具有稳定结构,异常行为则偏离这种结构。我们不需要预先知道异常长什么样,只需要让模型学习正常交易的分布。当新交易出现时,如果模型难以重构或难以解释它,就说明它可能异常。
这与有监督方法形成互补。有监督模型擅长识别已知异常,无监督模型擅长发现未知异常。实际风控系统中,二者常结合使用:无监督模型负责发现可疑候选,有监督模型或规则引擎负责二次确认。这样既能提升召回,又能控制误报。
核心判断:无监督异常检测不是替代有监督模型,而是补足“未知异常发现能力”。在标注稀缺、异常漂移明显的交易场景中,它往往是最先上线的基线方案。
三、AutoEncoder的定位:用“重构误差”衡量异常
AutoEncoder(自编码器)是一类经典的神经网络结构,由编码器和解码器组成。编码器把高维输入压缩为低维隐向量,解码器再尝试从隐向量还原原始输入。训练目标是让输出尽可能接近输入。
关键点在于:AutoEncoder只使用正常交易数据训练。因此,它学会的是正常交易的压缩与还原方式。当输入是正常交易时,重构误差较小;当输入是异常交易时,由于模型从未学习过这种模式,重构误差会明显增大。我们可以把重构误差作为异常分数,并设定阈值进行告警。
输入交易特征 x
   ↓
编码器 Encoder:x → z(低维隐向量)
   ↓
解码器 Decoder:z → x_hat(重构输出)
   ↓
重构误差 loss = ||x - x_hat||²
   ↓
异常分数 score = loss
   ↓
score > 阈值 → 判定为异常交易
相比孤立森林、One-Class SVM等方法,AutoEncoder的优势在于能够处理高维、稀疏、非线性特征,并且可以通过网络结构灵活建模交易序列、用户行为和时间模式。它的局限也很明显:如果异常样本也能被很好地重构,检测效果就会下降;阈值选择会直接影响误报和漏报。
四、整体课程框架:从原理到实战落地
本课程共30章,围绕“数据—特征—模型—评估—部署”的完整链路展开。第1章建立业务与算法认知,后续章节逐步进入特征工程、模型搭建、训练调参、异常评分、阈值优化和线上部署。你会看到的不只是理论,还包括可运行的代码、参数配置、日志分析和复盘方法。
| 阶段 | 核心内容 | 实战产出 |
|---|---|---|
| 业务与问题定义 | 异常交易场景、无监督价值、评价指标 | 明确检测目标与误报容忍度 |
| 数据与特征工程 | 交易流水清洗、行为特征、时间窗口统计 | 可训练的特征矩阵 |
| 模型构建与训练 | AutoEncoder结构设计、损失函数、训练策略 | 正常行为重构模型 |
| 异常评分与阈值 | 重构误差分布、阈值选择、告警策略 | 异常交易候选清单 |
| 评估与部署 | 离线评估、线上监控、模型更新 | 可持续运行的风控模块 |
五、案例场景:一笔交易如何被判定为异常
假设某用户平时交易金额集中在50~300元,交易时间多在白天,商户类型以餐饮和超市为主。某天凌晨2点,该账户突然发生一笔9800元的跨境虚拟商品交易。将这笔交易输入训练好的AutoEncoder后,模型发现它无法被正常模式很好地重构,重构误差显著高于历史正常交易的平均水平,于是生成异常告警。
这个例子说明:AutoEncoder并不需要知道“跨境虚拟商品交易”一定是欺诈,它只需要知道这笔交易不像该用户过去的正常行为。当然,实际系统中还要结合用户画像、设备指纹、IP归属、交易频次等多维特征,避免单点误判。
实践提示:异常分数高不等于一定是欺诈。它只是“值得进一步审核”的信号。风控系统应把无监督模型输出作为候选筛选器,而不是最终判决器。
六、常见误区与复盘
初学者在应用AutoEncoder做异常检测时,最容易犯以下错误:
- 用包含异常的数据训练模型。这会让模型也学会重构异常,导致异常分数被压低。应尽量使用经过清洗的正常样本训练。
- 只看重构误差,不看业务阈值。不同用户、不同交易类型的正常误差分布不同,统一阈值可能造成大量误报。
- 忽略特征质量。如果特征不能反映交易行为差异,再复杂的网络也无法区分正常与异常。
- 用准确率评估模型。在极端不平衡场景中,准确率没有意义,应关注召回率、精确率、F1和告警量。
- 上线后不更新。用户行为会变化,模型需要定期用新的正常样本重新训练或微调。
复盘结论:AutoEncoder异常交易检测的成败,往往不取决于网络有多深,而取决于问题定义是否清晰、正常样本是否干净、特征是否有效、阈值是否贴合业务。把这四件事做好,简单结构也能产生稳定价值。
本章作为课程导入,已经建立了三个关键认知:异常交易检测面临标注稀缺和形态漂移的双重挑战;无监督学习通过“学习正常、偏离即异常”提供补充能力;AutoEncoder以重构误差为核心信号,适合作为高维交易数据的异常检测基线。接下来,课程将进入数据与特征环节,把业务问题转化为模型可学习的输入。