1. 课程导入
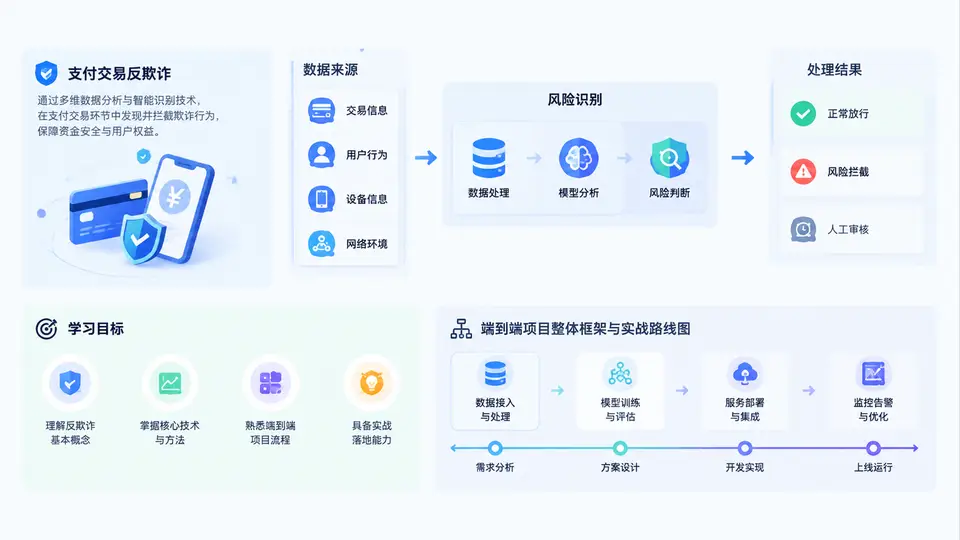
一、什么是支付交易反欺诈
支付交易反欺诈,是指在支付链路中,围绕“谁在付、付给谁、用什么付、付多少、何时何地付”这五个核心问题,利用规则、模型、名单、设备指纹、关系网络与实时计算等手段,识别并拦截盗刷、欺诈、套现、洗钱、营销作弊等风险行为的一整套技术与管理体系。它不等同于“风控”全部,而是聚焦于交易发生前后与资金流向直接相关的欺诈风险。
从业务视角看,支付反欺诈要同时满足三个目标:资金安全、用户体验、合规要求。过于宽松会导致资损,过于严格会误伤正常用户并抬高客服成本。因此,反欺诈本质上是一个在风险与转化率之间持续寻优的工程问题,而不是单纯追求“抓得越多越好”。
从技术视角看,支付反欺诈系统通常包含:数据接入与清洗、特征计算、规则引擎、模型评分、决策引擎、名单与画像、案件调查、策略迭代等模块。它们共同构成一条从“交易请求”到“拦截/放行/挑战”的端到端链路。
二、学习目标:学完本课程你能做到什么
本课程不是零散知识点堆砌,而是以可落地的端到端项目为主线。完成学习后,你应当具备以下能力:
- 理解支付反欺诈的完整业务链路:从收单、发卡、网关、风控到清结算,知道风险发生在哪一环。
- 能设计并实现实时风控决策流程:包括规则命中、模型打分、决策分流与挑战策略。
- 能构建核心特征与名单体系:如设备维度、账户维度、商户维度、IP与地理位置维度。
- 能使用规则引擎与模型协同:理解规则的可解释性与模型的泛化能力如何互补。
- 能完成策略评估与复盘:掌握命中率、误杀率、资损率、召回率等指标,并能定位策略问题。
- 能形成工程化交付物:包括数据表、特征任务、决策服务、监控看板与迭代记录。
核心主线:本课程将围绕一个模拟的“支付交易反欺诈平台”展开,从需求定义、数据准备、特征开发、规则与模型、决策服务、监控告警到策略迭代,逐步完成一个可运行、可评估、可复盘的端到端项目。
三、端到端项目整体框架与实战路线图
为了让学习路径清晰,我们把项目拆成六个阶段。每个阶段都有明确的输入、输出与验收标准。下表给出整体框架:
| 阶段 | 核心任务 | 关键产出 | 验收标准 |
|---|---|---|---|
| 1. 业务与风险定义 | 明确欺诈类型、资金流向、风险场景与业务指标 | 风险场景清单、指标口径文档 | 能说清“什么算欺诈、什么算误伤” |
| 2. 数据接入与治理 | 接入交易、用户、设备、商户、黑名单等数据 | 数据字典、清洗规则、宽表 | 数据可追溯、字段口径一致 |
| 3. 特征与名单体系 | 构建实时/离线特征,维护名单与画像 | 特征表、名单服务、画像标签 | 特征可复用、名单可更新 |
| 4. 规则与模型策略 | 编写规则、训练模型、融合评分 | 规则集、模型文件、评分卡 | 策略可解释、可回测 |
| 5. 决策服务与集成 | 实现实时决策API、挑战与拦截动作 | 决策服务、接口文档、日志 | 低延迟、高可用、可降级 |
| 6. 监控、复盘与迭代 | 监控指标、案件调查、策略调优 | 看板、复盘报告、迭代记录 | 指标闭环、策略持续优化 |
下图展示了从交易请求到决策输出的端到端数据流与决策流,帮助你建立整体认知:
四、核心原理:规则、模型与决策的协同
很多初学者会问:有了机器学习模型,还需要规则吗?答案是:需要,而且两者是互补关系。
- 规则擅长处理确定性风险,例如“同一设备1分钟内发起20笔不同账户支付”“命中已知黑名单卡号”。规则可解释、可快速上线,但容易被绕过,且维护成本随规则数量上升。
- 模型擅长处理模糊、高维、非线性风险,例如“该用户行为模式与历史盗刷团伙相似”。模型泛化能力强,但可解释性弱,且依赖数据质量与特征工程。
- 决策引擎负责将规则命中、模型评分、名单状态、业务策略融合成最终动作:放行、挑战(短信/人脸)、人工审核或直接拦截。
一个典型的决策逻辑可以用如下伪代码表示:
risk_score = 0
if device in blacklist:
    risk_score += 100
if rule_engine.hit("高频小额试探"):
    risk_score += 40
if model_score > 0.85:
    risk_score += 50

if risk_score >= 100:
    action = "BLOCK"
elif risk_score >= 60:
    action = "CHALLENGE"
else:
    action = "PASS"
这段逻辑虽然简化,但体现了端到端项目的核心:多源信号融合、阈值可调、动作分级。在实际系统中,还需要考虑延迟、降级、灰度与回滚。
五、案例与场景:三个典型支付欺诈场景
- 盗刷场景:攻击者通过撞库或钓鱼获取用户账号,在短时间内异地登录并完成多笔大额支付。关键信号包括:新设备、异地IP、夜间交易、收款方集中、历史行为偏离。
- 套现场景:持卡人与商户合谋,通过虚假交易将信用额度转为现金。关键信号包括:商户交易金额规律性强、退款率高、同一卡号在固定商户反复交易。
- 营销作弊场景:黑产利用批量注册账号领取优惠券并快速变现。关键信号包括:设备指纹聚集、IP段集中、注册与支付时间间隔极短、收货地址异常。
这些场景的共同点是:单点信号往往不足以判定欺诈,需要组合特征与上下文。这也是端到端项目要解决的核心问题。
六、常见误区与复盘思路
误区1:只追求高召回,忽视误杀。拦截率上升的同时,正常用户被挑战或拒绝,会导致投诉与流失。必须同时监控误杀率与客诉率。
误区2:规则越多越安全。规则堆叠会带来冲突、维护困难和性能下降。应定期做规则命中率与覆盖度复盘,淘汰低效规则。
误区3:模型上线即结束。模型会随黑产对抗而衰减,需要持续监控特征分布、评分分布与命中效果,并定期重训。
误区4:忽视数据质量。特征口径不一致、时间戳错乱、设备ID缺失,都会让策略失效。数据治理是反欺诈的地基。
复盘时建议围绕四个问题展开:哪些欺诈漏过了?哪些正常用户被误伤?哪些规则从未命中?哪些特征重要性下降?把这些问题转化为下一轮迭代的输入,才能形成闭环。