3. 标签体系概览
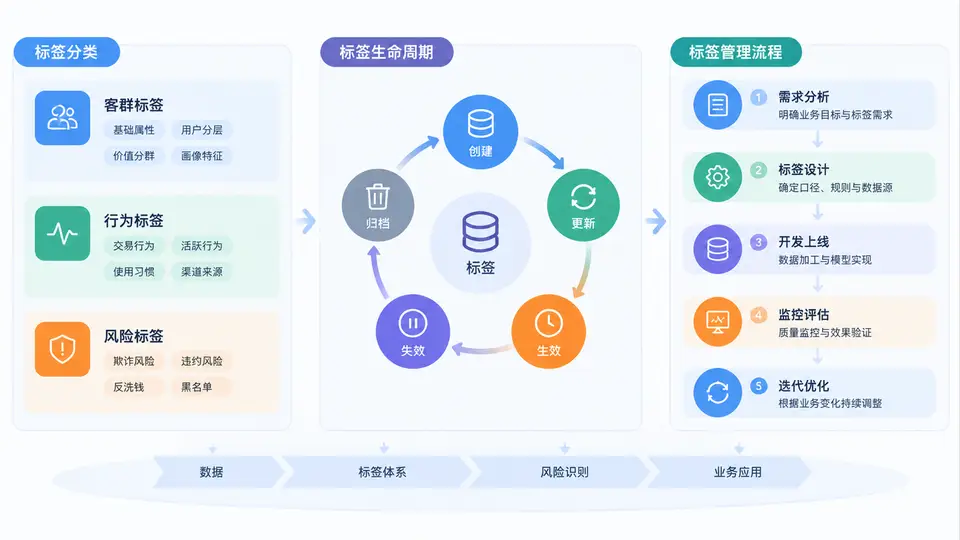
在风控体系中,标签不是孤立的数据字段,而是连接原始数据、业务语义与模型决策的中间层。口径设计决定了标签“怎么算”,坏样本定义决定了标签“算出来代表什么风险”,而标签体系则决定了这些标签能否被稳定地生产、复用和治理。本节从标签分类、生命周期和管理流程三个角度,建立后续口径设计与坏样本定义的共同语言。
一、核心原理:标签是业务语义的压缩表达
风控标签的本质,是把分散在多个系统、多个时间窗口、多种计算逻辑中的信息,压缩成可被规则、模型和策略直接消费的离散或连续变量。一个标签通常包含四层含义:对象(对谁打标,如用户、设备、商户、订单)、时间(观察点与观察窗口)、口径(统计逻辑与过滤条件)、取值(枚举、数值或布尔)。缺少任何一层,标签在跨团队使用时都会产生歧义。
因此,标签体系设计的第一原则不是“多”,而是“可解释、可追溯、可复用”。可解释意味着业务方能理解标签含义;可追溯意味着能从标签反查到原始数据和计算任务;可复用意味着同一标签在不同策略中不需要重复开发。
二、标签分类:客群标签、行为标签、风险标签
按业务语义,风控标签通常分为三大类。三者不是互斥关系,而是从不同视角描述同一对象,实际体系中常组合使用。
| 标签类别 | 核心问题 | 典型示例 | 主要来源 | 更新频率 |
|---|---|---|---|---|
| 客群标签 | “他是谁” | 新客/老客、学生群体、高净值、企业主、地域分层 | 注册资料、实名信息、第三方画像 | 低,按天/周/月 |
| 行为标签 | “他做了什么” | 近7日登录次数、近30日交易笔数、夜间活跃、设备切换频次 | 埋点日志、交易流水、设备指纹 | 高,按小时/天 |
| 风险标签 | “他有多危险” | 多头借贷、历史逾期、黑名单命中、团伙关联、欺诈评分 | 征信、内部案件、模型分、关联图谱 | 中,按天/事件触发 |
客群标签偏静态,用于分层和准入;行为标签偏动态,用于捕捉近期变化;风险标签偏结论,用于直接参与决策。实践中,风险标签往往由客群标签和行为标签衍生而来,例如“新客 + 近7日设备切换≥3次 + 多头借贷≥5家”可组合成“高危新客”风险标签。
分类不是目的,而是治理手段。分类清晰后,才能为不同类别设定不同的更新频率、质量校验规则和权限策略。例如行为标签需要更严格的时效监控,风险标签需要更严格的变更审批。
三、标签生命周期:从需求到退役
标签不是一次开发就永久有效。一个完整的标签生命周期通常包含六个阶段:
- 需求提出:业务方或策略方提出标签需求,明确使用场景、对象、时间窗口和预期取值。
- 口径设计:定义统计逻辑、过滤条件、空值处理、边界情况,并形成可评审的口径文档。
- 开发与测试:实现计算任务,进行数据质量校验、分布对比和回溯验证。
- 上线与发布:注册到标签平台,配置更新频率、存储位置、权限和版本号。
- 监控与迭代:监控覆盖率、稳定性、分布漂移和业务效果,按需调整口径。
- 退役与归档:当标签不再使用或口径被替代时,停止生产并保留历史版本,避免“僵尸标签”污染体系。
生命周期管理的关键是版本化。任何口径变更都必须产生新版本,而不是直接覆盖旧逻辑。否则,同一标签名在不同时间点的含义不一致,会导致模型回溯和策略复盘失效。
四、标签管理流程:从注册到消费
标签管理流程可以概括为“注册—生产—质检—服务—消费—治理”六个环节。下面是一个简化的标签注册配置示例,用于说明标签元数据应包含哪些关键字段:
{
  "tag_code": "risk_multi_loan_30d",
  "tag_name": "近30日多头借贷机构数",
  "category": "risk",
  "object": "user",
  "window": "30d",
  "caliber": "统计近30日内成功放款的非银机构数,去重",
  "value_type": "int",
  "update_freq": "daily",
  "owner": "risk_data_team",
  "version": "v2.1",
  "status": "online",
  "quality_rule": "覆盖率>=95%, 空值率<=5%"
}该配置中,caliber 是口径的核心描述,version 支持版本追溯,quality_rule 用于自动质检。标签平台应基于这些元数据统一调度生产任务,并向策略、模型和报表提供一致的查询接口。
管理流程的核心目标:让标签“找得到、看得懂、信得过、管得住”。找得到靠元数据检索,看得懂靠口径文档,信得过靠质量监控,管得住靠权限与审批。
五、案例与场景:一个“高危新客”标签的诞生
假设业务方希望识别注册后7天内可能发生欺诈的新客。初始需求是“新客风险标签”。经过拆解,发现它需要组合三类标签:
- 客群标签:
is_new_user_7d,注册7天内; - 行为标签:
device_switch_7d,近7日设备切换次数;night_active_7d,近7日夜间活跃天数; - 风险标签:
multi_loan_30d,近30日多头借贷机构数;blacklist_hit,是否命中黑名单。
组合规则可定义为:新客且设备切换≥3且多头借贷≥5,则打上 high_risk_new_user 标签。上线后监控发现该标签覆盖率仅2%,但命中人群中欺诈率是平均水平的8倍,说明口径有效。随后根据业务反馈,将设备切换阈值调整为≥2,版本升级为v2,并保留v1用于回溯对比。
六、误区与复盘
常见误区一:标签命名随意。同一含义出现多个名称,或同一名称对应多种口径,导致策略引用错误。应建立命名规范,如“类别_对象_窗口_指标”。
常见误区二:只建不管。标签上线后无人监控,分布漂移、覆盖率下降、空值率上升都无人发现,最终污染模型输入。
常见误区三:口径变更不留痕。直接修改计算逻辑而不升版本,导致历史策略无法复现,坏样本定义与标签口径错位。
常见误区四:风险标签滥用。将风险标签直接作为强规则拒绝,而不评估其时效性和误杀率,容易造成业务损失。
复盘时,应重点检查三件事:标签是否仍有明确使用方;口径是否与当前业务定义一致;质量监控是否覆盖核心标签。只有把标签当作有生命周期的数据资产来管理,后续的坏样本定义和模型开发才有可靠基础。