1. 课程导入
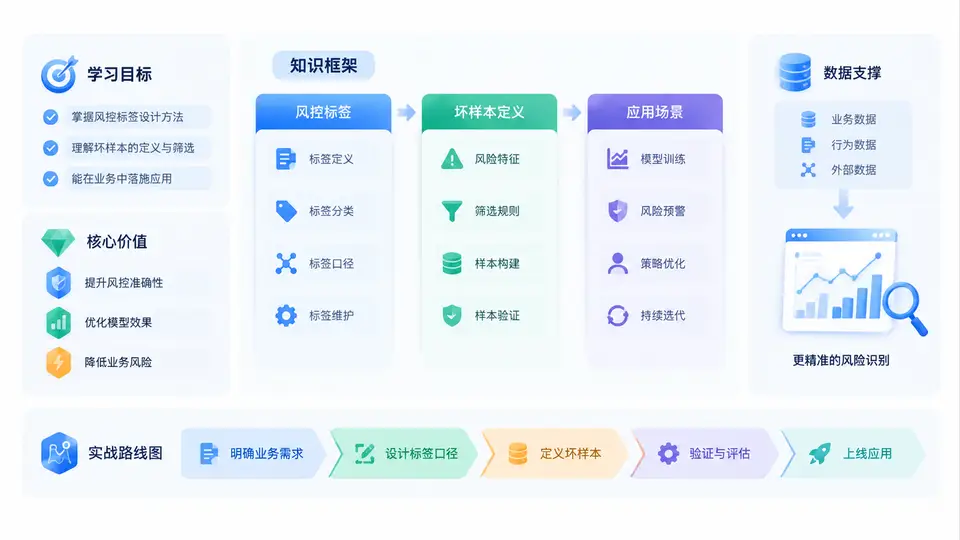
欢迎进入《风控标签口径设计与坏样本定义实战》。在信贷风控、消费金融、供应链金融以及平台型业务中,模型效果的上限往往不由算法决定,而由标签口径与坏样本定义决定。很多团队在建模阶段反复调参、换算法、加特征,最终AUC提升有限,根本原因常常是:目标变量本身定义不清、口径漂移、样本选择偏差或时间窗口错配。本课程的第一章不讨论复杂模型,而是先建立一套贯穿全课程的认知框架,帮助你理解为什么“定义坏”比“预测坏”更难,也更关键。
一、学习目标:从“会建模”到“会定义问题”
本课程的学习目标分为四个层次,层层递进:
- 认知层:理解风控标签与坏样本定义在模型开发全流程中的位置,明确其与特征工程、模型训练、策略部署之间的关系。
- 方法层:掌握坏样本定义的常见口径,包括滚动率、账龄、逾期天数、金额阈值、行为表现等,并能根据业务场景选择合适定义。
- 实战层:能够独立完成从业务目标拆解、观察期与表现期设计、样本筛选、标签生成到口径文档化的完整流程。
- 复盘层:识别标签定义中的典型误区,如幸存者偏差、时间穿越、口径不一致、样本不均衡处理不当等,并具备修正能力。
核心价值:一个口径清晰的坏样本定义,可以让模型效果提升10%~30%,并显著降低策略上线后的误杀与漏放。反之,口径模糊的标签会让模型在离线表现优异、上线后迅速失效。本课程的价值在于把“定义”从经验直觉变成可复用、可审计、可迭代的工程能力。
二、核心原理:标签是业务的数学投影
风控标签不是简单的“好/坏”二分类,而是业务风险偏好在数据上的投影。定义坏样本时,需要同时回答五个问题:
- 谁?样本主体是个人、企业、商户还是订单?
- 什么时候?观察期与表现期如何划分?
- 什么行为?逾期、违约、欺诈、失联、提前还款还是额度使用异常?
- 多严重?逾期1天、30天、60天、90天,还是金额超过某一阈值?
- 观察多久?表现期是3个月、6个月、12个月还是更久?
这五个问题构成了坏样本定义的“五要素模型”。任何一项模糊,都会导致标签噪声。例如,同样叫“逾期客户”,M1(逾期1~30天)与M3+(逾期90天以上)的风险含义完全不同;同样叫“表现期6个月”,从放款日算起还是从首次提款日算起,样本集合也会显著不同。
三、整体知识框架:从口径到落地的六层结构
本课程将围绕六层结构展开,第一章先建立全局地图:
| 层级 | 核心内容 | 关键产出 |
|---|---|---|
| 业务层 | 风险偏好、产品类型、客群定位 | 坏样本定义的业务目标 |
| 口径层 | 逾期天数、金额阈值、行为类型、观察期/表现期 | 标签口径说明书 |
| 数据层 | 样本筛选、时间切片、数据质量校验 | 建模样本集 |
| 标签层 | 坏样本标注、灰样本处理、样本权重 | 目标变量Y |
| 模型层 | 特征工程、算法选择、交叉验证 | 风险评分模型 |
| 策略层 | 阈值切分、通过率/坏账率权衡、监控 | 风控策略与报表 |
其中,口径层是承上启下的枢纽。业务目标若不能翻译成可计算的口径,数据层就无从筛选;标签层若没有稳定的定义,模型层再先进也只是在拟合噪声。
四、实战路线图:四周从入门到交付
为了让学习路径清晰,本课程设计了一条可执行的实战路线图:
第1周:业务理解与口径设计
  - 明确风险偏好与产品形态
  - 定义观察期、表现期、坏样本阈值
  - 输出《标签口径说明书V1》

第2周:样本构建与标签生成
  - 数据抽取、清洗、时间切片
  - 坏样本标注、灰样本处理
  - 样本分布与稳定性校验

第3周:模型开发与验证
  - 特征工程与WOE/IV分析
  - 模型训练、交叉验证、KS/AUC评估
  - 口径敏感性测试

第4周:策略落地与监控
  - 阈值切分与通过率模拟
  - 上线监控指标设计
  - 口径迭代与版本管理
提示:路线图中的每一周都对应后续章节的实战任务。建议你在学习过程中同步准备一份自己的业务数据,边学边做,最终形成可复用的口径文档与建模样本。
五、案例场景:一个“坏样本定义”如何改变模型结论
假设某消费金融产品要预测“未来6个月是否发生严重逾期”。团队A将坏样本定义为“逾期天数≥30天”,团队B定义为“逾期天数≥90天”。两者在同一份数据上建模,结果如下:
- 团队A的坏样本占比约8%,模型KS约0.42;
- 团队B的坏样本占比约3%,模型KS约0.35;
- 上线后,团队A的模型在审批通过率相近时,首逾率更低,但误杀了一些短期资金周转客户;
- 团队B的模型更聚焦严重违约,但漏放了一些最终会恶化的客户。
这个案例说明:坏样本定义不是“越严格越好”,而是要与业务目标匹配。如果业务目标是控制严重损失,M3+更合适;如果目标是早期预警与客户经营,M1+可能更敏感。关键在于:定义必须与策略目标、客群特征、资金成本一致。
六、常见误区与复盘
误区1:用“当前逾期状态”直接作为历史标签。这会造成时间穿越,因为当前状态包含了未来信息。正确做法是按观察期截止时的行为表现来标注。
误区2:忽略灰样本。逾期1~29天的客户既不是明确好客户,也不是明确坏客户。直接归为好或坏都会引入噪声,应单独处理或加权。
误区3:口径频繁变更且无版本记录。这会导致模型监控失效、策略回溯困难。每次口径调整都应记录版本、原因、影响范围。
误区4:样本选择偏差。只用“已放款客户”建模,会忽略被拒绝客户的风险分布,导致模型上线后对全量申请人群排序能力下降。
复盘这些误区的共同点:它们都不是算法问题,而是定义问题。定义不清,模型越复杂,偏差被放大得越严重。因此,本课程把“口径设计与坏样本定义”放在第一章,作为整个风控建模体系的地基。
七、本章小结与行动清单
通过本章,你应该已经理解:风控标签是业务的数学投影,坏样本定义需要回答“谁、何时、什么行为、多严重、观察多久”五个问题;整体知识框架分为业务层、口径层、数据层、标签层、模型层、策略层;实战路线图按四周推进,从口径设计到策略监控。最后,请完成以下行动清单:
- 写下你当前业务中“坏客户”的业务定义,并尝试拆解为可计算口径。
- 检查现有模型标签是否存在时间穿越、灰样本未处理、口径无版本等问题。
- 准备一份样本数据,标注观察期与表现期,为后续章节的实战任务做准备。
当你能够清晰回答“我的坏样本到底是怎么定义的”,你就已经超过了大多数只会调参的建模者。接下来的章节,将带你一步步把定义变成可落地的标签、样本与模型。