3. 模型性能评估基础
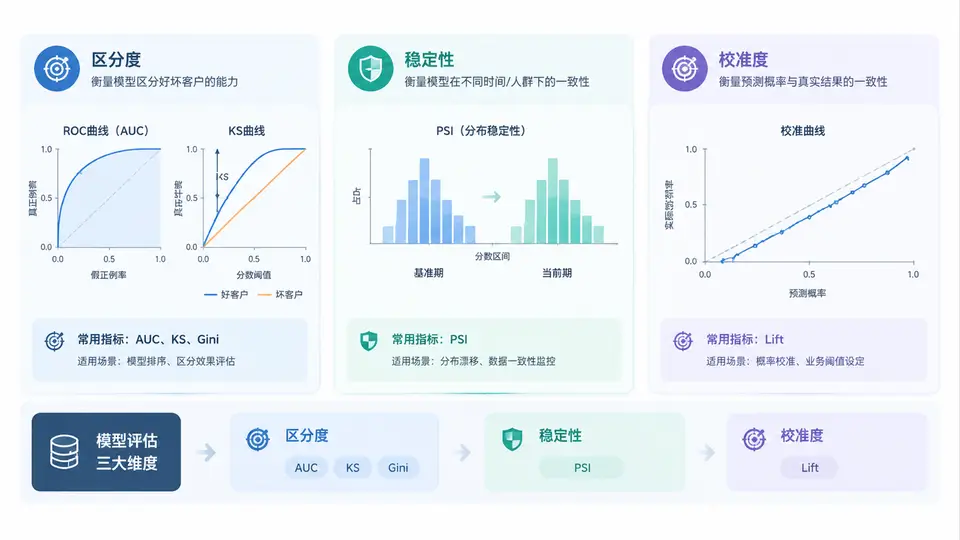
在信贷风控场景中,模型上线只是起点,真正的挑战在于持续判断它“是否还值得信任”。要回答这个问题,不能只看一个指标,而应从区分度、稳定性、校准度三个维度建立评估框架。区分度回答“模型能否把好坏客户分开”,稳定性回答“模型在新样本上是否还保持原有行为”,校准度回答“模型输出的违约概率是否接近真实违约率”。三者缺一不可:区分度高但校准差,会导致定价和额度策略失真;校准好但稳定性差,会让监控失去预警能力。
一、核心原理:三大维度分别解决什么问题
区分度(Discrimination)衡量模型对好坏样本的排序能力。它不关心概率绝对值,只关心“坏人得分是否普遍高于好人”。常用指标包括 AUC、KS、Gini。AUC 可理解为随机抽取一个好人和一个坏人,模型给坏人更高风险分的概率;KS 衡量好坏累计分布曲线的最大间距;Gini 与 AUC 存在线性关系,常用于金融行业报告。
稳定性(Stability)衡量模型输入分布或输出分布随时间、客群、渠道变化而偏移的程度。最常用的是 PSI(Population Stability Index)。PSI 不直接评价模型好坏,而是回答“当前样本与建模样本是否同分布”。当 PSI 升高时,AUC 可能暂时不变,但模型已经处于风险之中。
校准度(Calibration)衡量预测概率与真实违约频率的一致性。若模型给 1000 个客户都预测 5% 的违约率,实际应有约 50 人违约。校准度常用校准曲线、Brier Score、预期/实际违约比(Expected/Actual)评估。在信贷定价、拨备和资本计量中,校准度比区分度更直接影响财务结果。
一句话记忆:区分度看排序,稳定性看偏移,校准度看概率。排序决定“选谁”,概率决定“收多少、留多少”。
二、方法流程:从指标计算到监控闭环
实际监控中,建议按以下流程组织评估,而不是孤立地看某个指标:
- 确定评估窗口:按月度、周度或放款批次切分样本,确保表现期完整,避免成熟度偏差。
- 计算区分度:在验证集和近期样本上分别计算 AUC、KS、Gini,观察是否出现持续下降。
- 计算稳定性:对入模变量和模型分数分别计算 PSI,定位是变量偏移还是分数整体偏移。
- 计算校准度:按分数分箱,比较预测违约率与实际违约率,计算 E/A 比值和 Brier Score。
- 设定阈值与动作:为每个指标设定预警线、告警线和熔断线,并绑定对应处置动作。
下面是一段典型的 Python 监控计算示例,展示如何同时输出 AUC、KS 和 PSI:
import numpy as np
from sklearn.metrics import roc_auc_score, roc_curve

def ks_score(y_true, y_prob):
    fpr, tpr, _ = roc_curve(y_true, y_prob)
    return np.max(tpr - fpr)

def psi(base, curr, bins=10):
    breakpoints = np.percentile(base, np.linspace(0, 100, bins + 1))
    breakpoints[0], breakpoints[-1] = -np.inf, np.inf
    base_pct = np.histogram(base, bins=breakpoints)[0] / len(base)
    curr_pct = np.histogram(curr, bins=breakpoints)[0] / len(curr)
    base_pct = np.clip(base_pct, 1e-6, None)
    curr_pct = np.clip(curr_pct, 1e-6, None)
    return np.sum((curr_pct - base_pct) * np.log(curr_pct / base_pct))

auc = roc_auc_score(y_true, y_prob)
ks = ks_score(y_true, y_prob)
psi_score = psi(base_scores, curr_scores)
print(f"AUC={auc:.4f}, KS={ks:.4f}, PSI={psi_score:.4f}")
输出日志建议保留时间戳和样本量,便于回溯:
[2025-03-01] window=2025-02 sample=48213
AUC=0.7123, KS=0.2981, PSI=0.0874
E/A=1.12, Brier=0.0412
三、指标定义、适用场景与阈值清单
不同指标服务不同决策,不能互相替代。下表给出常用指标的定义、适用场景和常见阈值参考:
| 指标 | 维度 | 定义 | 适用场景 | 常见阈值参考 |
|---|---|---|---|---|
| AUC | 区分度 | 坏人得分高于好人的概率 | 模型排序能力整体评估 | 0.65~0.75 可用,低于 0.6 需警惕 |
| KS | 区分度 | 好坏累计分布最大间距 | 风控策略切分点选择 | 0.25~0.45 较常见,低于 0.2 偏弱 |
| Gini | 区分度 | 2×AUC−1 | 金融行业报告与横向对比 | 与 AUC 同步监控 |
| PSI | 稳定性 | 样本分布偏移程度 | 变量、分数、客群偏移监控 | <0.1 稳定,0.1~0.25 预警,>0.25 告警 |
| Lift | 区分度/排序 | 头部人群坏账率与整体坏账率之比 | 营销、催收、额度策略排序 | 看头部 10% 或 20% 的 Lift |
| E/A | 校准度 | 预期违约数/实际违约数 | 拨备、定价、资本计量 | 0.9~1.1 较理想 |
| Brier | 校准度 | 预测概率与真实结果均方误差 | 概率模型整体校准评估 | 越低越好,需与基准比较 |
Lift 的典型用法:若整体坏账率为 3%,模型评分最高的 10% 人群坏账率为 12%,则头部 Lift=4。它直接回答“如果只做头部人群,风险集中度能提高多少”,在额度调整和催收排序中非常实用。
四、案例与误区复盘
案例:某现金贷模型上线后 AUC 从 0.72 降至 0.68,团队认为“还能用”。但同期分数 PSI 从 0.06 升至 0.31,E/A 从 1.02 升至 1.45。进一步排查发现,新渠道进件人群收入分布明显下移,模型给大量客户预测 8% 违约率,实际违约率达到 11.6%。这说明:AUC 下降只是表象,稳定性偏移和校准失真才是根因。若只盯 AUC,会错过定价和拨备的实质性风险。
常见误区包括:
- 只看 AUC,不看校准:AUC 高不代表概率准,定价策略可能系统性偏低。
- 把 PSI 当模型好坏指标:PSI 只反映分布偏移,不直接说明区分度下降,但它是早期预警信号。
- 忽略样本成熟度:表现期不足时,坏样本被低估,AUC 和校准都会被高估。
- 阈值一刀切:不同产品、渠道、客群的 PSI 和 E/A 阈值应差异化设定。
- 监控频率过低:月度监控可能滞后,高风险业务应周度甚至日度监控分数分布。
复盘要点:当 AUC 下降、PSI 升高、E/A 偏离同时出现时,优先排查数据源、客群结构和策略规则变化,再决定是否重训模型。不要在没有定位原因前直接调参或换模型。