3. 模型稳定性的核心来源
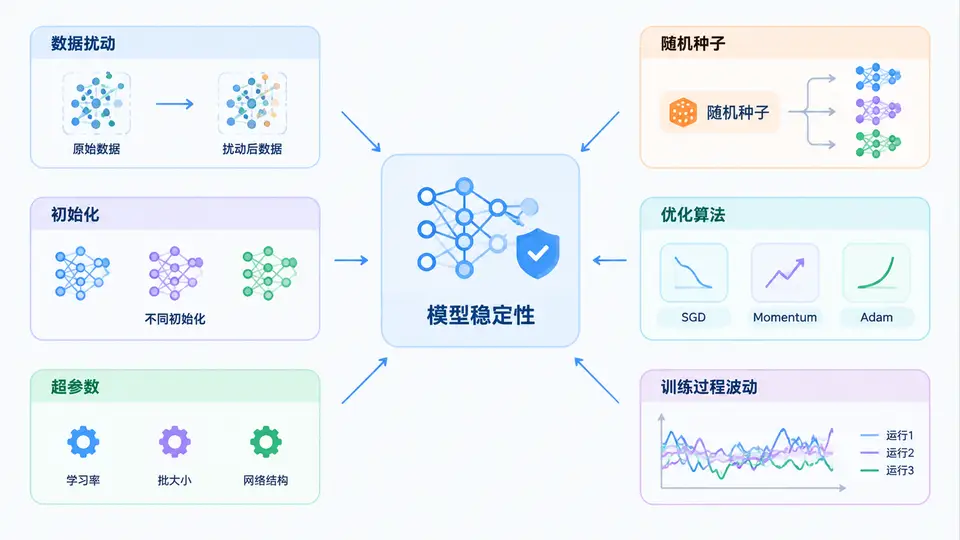
在模型验证中,我们常把“稳定性”理解为:当训练条件发生微小变化时,模型性能是否仍然保持在可接受范围内。一个不稳定的模型,往往不是“训练失败”,而是表现为指标方差大、复现困难、上线后表现漂移。要定位这种不稳定性,必须回到训练系统的六个核心扰动源:数据扰动、初始化、超参数、随机种子、优化算法与训练过程波动。它们既可能单独作用,也可能耦合放大。
一、核心原理:稳定性是“输入扰动—输出响应”的敏感度问题
从系统角度看,训练过程是一个从“数据+配置+随机性”到“模型参数与指标”的映射。稳定性衡量的是该映射对输入的敏感度。若输入轻微变化导致输出剧烈变化,则模型不稳定。六类来源可归为三组:
- 数据侧:样本顺序、采样偏差、噪声、类别不平衡、数据增强强度。数据扰动直接改变经验风险面。
- 配置侧:初始化、超参数、优化算法。它们决定搜索轨迹与收敛盆地。
- 随机侧:随机种子、GPU并行、Dropout、批归一化统计、数据加载器打乱。它们引入不可控方差。
理解一个关键区分:稳定性不等于最终精度。一个高精度模型可能极不稳定,换种子就崩;一个中等精度模型可能非常稳定,适合生产。验证的目标是同时报告“均值”和“方差”,而不是只看单次最优结果。
核心判断:若同一配置在多次运行中指标标准差超过业务容忍阈值,或不同数据切分下结论方向相反,则模型稳定性不足,需优先排查随机种子、初始化与数据扰动。
二、六类来源的机制与排查方法
下面按来源逐一说明其作用机制、典型现象与验证手段。
| 来源 | 作用机制 | 典型不稳定现象 | 验证手段 |
|---|---|---|---|
| 数据扰动 | 改变经验风险面与梯度方向 | 换切分后指标大幅波动 | K折交叉验证、Bootstrap重采样 |
| 初始化 | 决定初始盆地与对称性破缺 | 部分初始化收敛到差局部最优 | 多初始化重复实验,统计分位数 |
| 超参数 | 控制容量、正则与步长 | 学习率稍变即发散或欠拟合 | 网格/随机搜索+敏感性曲线 |
| 随机种子 | 控制打乱、Dropout、初始化采样 | 同配置结果不可复现 | 固定种子对照,多种子方差报告 |
| 优化算法 | 影响轨迹平滑度与逃逸能力 | SGD与Adam结论不一致 | 跨优化器对比,观察收敛曲线 |
| 训练过程波动 | 批统计、并行归约、早停时机 | 验证曲线锯齿大,最佳点漂移 | 日志监控、滑动平均、多次早停 |
数据扰动是最容易被低估的来源。很多团队只做一次训练/验证切分,得到“漂亮”结果便上线。正确做法是至少做5折交叉验证,并报告每折指标。若某折显著偏离,需检查该折是否包含稀有类别或时间泄漏。
初始化与优化算法常耦合。例如ReLU网络对初始化尺度敏感,过大导致梯度爆炸,过小导致神经元死亡。Adam对学习率相对鲁棒,但在某些任务上泛化不如SGD。验证时应固定其他变量,单独改变优化器,观察收敛曲线与最终指标分布。
# 多种子稳定性验证示例(伪代码)
seeds = [42, 123, 2024, 7, 99]
results = []
for s in seeds:
    set_seed(s)
    model = build_model()
    train(model, train_loader)
    metrics = evaluate(model, val_loader)
    results.append(metrics)

report_mean_std(results)
# 输出:accuracy mean=0.912, std=0.018
# 若std > 0.02,需排查初始化与数据打乱
实践建议:把随机种子当作超参数记录在实验元数据中。任何未记录种子的实验,都不具备可复现性,也无法判断稳定性。
三、方法流程:如何系统验证稳定性
建议采用“分层扰动—统计报告—归因定位”的流程:
- 固定基线:确定数据切分、初始化、超参数、优化器与种子,得到基线指标。
- 单因素扰动:每次只改变一个来源,如仅换种子、仅换初始化、仅换优化器,观察指标变化。
- 重复实验:每个配置至少运行5次,记录均值、标准差、最小值与最大值。
- 敏感性分析:对学习率、批大小、正则系数绘制敏感性曲线,识别“悬崖区”。
- 归因定位:若方差主要来自种子,检查Dropout与数据打乱;若来自数据,检查切分与采样。
- 决策阈值:设定业务可接受的方差上限,超过则拒绝上线或要求集成/正则化。
该流程的关键是“控制变量”。很多团队同时换种子和超参数,导致无法归因。稳定性验证不是追求一次最优,而是建立对模型行为的统计置信。
四、案例与复盘:一次“高精度但不稳定”的排查
某风控模型在单次实验中AUC达到0.89,团队准备上线。复现时换种子后AUC降至0.81,换数据切分后甚至出现方向性错误。排查发现:
- 数据侧:正样本仅占1.2%,且切分未分层,导致某折正样本极少。
- 初始化:输出层偏置未按类别比例初始化,导致早期梯度被负样本主导。
- 随机种子:数据加载器未固定打乱种子,每次顺序不同。
- 优化算法:使用Adam且学习率偏大,验证曲线锯齿明显,早停点漂移。
修复措施:分层切分、按比例初始化输出偏置、固定所有种子、降低学习率并改用带warmup的AdamW、增加早停耐心值。修复后AUC均值0.86,标准差0.006,虽略低于原“最优”0.89,但稳定性显著提升,最终上线。
常见误区:把“最好一次结果”当作模型能力;忽略随机种子记录;用单次切分代替交叉验证;只调参不做敏感性分析;把训练波动误判为数据问题。这些都会导致上线后性能漂移。
复盘结论:稳定性验证应作为模型交付的必选项,而非可选项。数据扰动、初始化、超参数、随机种子、优化算法与训练过程波动,六者共同决定模型是否可信。只有量化方差、定位来源、控制变量,才能把“偶然好”变成“稳定好”。