1. 课程导入
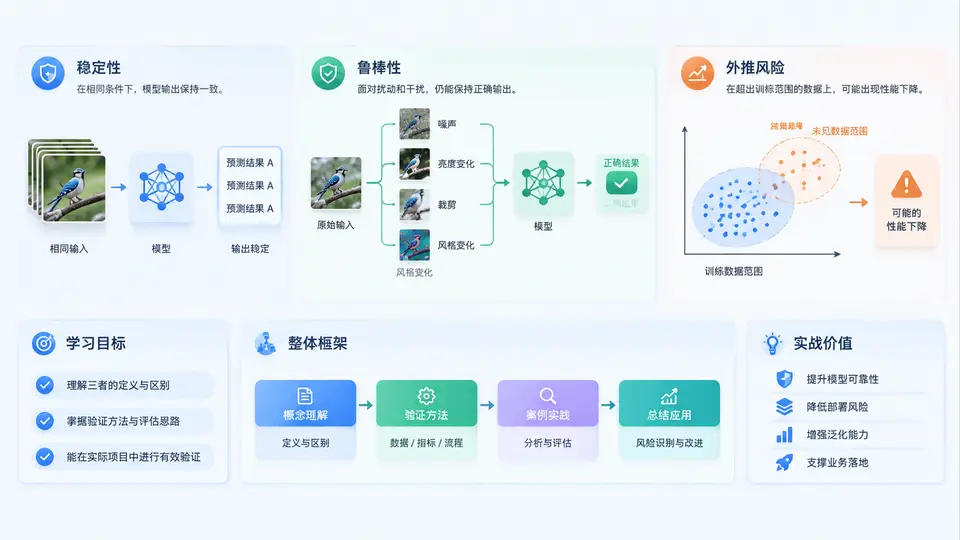
在机器学习项目从实验走向生产的过程中,模型在训练集和随机测试集上的高分往往给人一种“问题已经解决”的错觉。然而,当数据分布发生轻微漂移、输入出现噪声、样本来自训练时未覆盖的区域时,模型的表现可能急剧下降。这类失败并非源于模型容量不足,而是源于我们对模型在非理想条件下的行为缺乏系统验证。本课程围绕三个核心概念展开:稳定性、鲁棒性与外推风险,它们共同构成了模型可信度的底层支柱。
1.1 三个核心概念的定义
模型稳定性关注的是:当训练数据、随机种子、超参数或训练流程发生微小变化时,模型输出与性能是否保持一致。稳定性差的模型,换一个随机种子指标就大幅波动,换一批训练样本结论就反转,这样的模型无法被信任,也无法被复现。
模型鲁棒性关注的是:当输入数据受到扰动、噪声、缺失、对抗性修改或分布偏移时,模型能否维持可接受的性能。鲁棒性衡量的是模型对“不完美输入”的容忍度,它直接决定了模型在真实场景中的可用边界。
外推风险关注的是:当模型被要求预测训练分布之外或边缘区域的样本时,其输出是否仍然可靠。外推风险的本质是模型在缺乏数据支撑的区域做出了过度自信的推断,这类风险在时间序列预测、科学计算、医疗决策等场景中尤为致命。
1.2 学习目标
完成本课程后,学习者应能够达到以下目标:
- 准确区分稳定性、鲁棒性与外推风险三类问题的表现形式与成因;
- 掌握评估模型稳定性的实验设计方法,包括多随机种子、多数据子集、多超参数配置的对比协议;
- 掌握鲁棒性测试的常用手段,如输入扰动、噪声注入、缺失值模拟与对抗样本评估;
- 能够识别外推风险的高发场景,并设计分布外测试集与边界样本验证方案;
- 能够将稳定性、鲁棒性与外推风险指标纳入模型验收标准,形成可落地的验证报告。
1.3 整体课程框架
本课程共30章,按照“概念—方法—工具—案例—复盘”的逻辑递进组织,整体分为五个模块:
| 模块 | 核心内容 | 对应章节范围 |
|---|---|---|
| 基础认知 | 定义、边界、常见误区与验证思维 | 第1–5章 |
| 稳定性验证 | 随机性分析、数据扰动实验、超参数敏感性 | 第6–12章 |
| 鲁棒性验证 | 噪声注入、缺失值、对抗样本、分布偏移 | 第13–20章 |
| 外推风险验证 | OOD检测、边界样本、置信度校准、外推指标 | 第21–26章 |
| 综合实战 | 验证流水线、报告模板、工程落地与复盘 | 第27–30章 |
每个模块都包含原理讲解、可执行代码示例、指标解读与真实场景分析,确保学习者不仅理解概念,还能在实际项目中复现验证流程。
1.4 核心原理:为什么模型会“不稳定、不鲁棒、外推失败”
从原理上看,这三类问题共享一个根源:模型在训练数据上拟合的是有限样本的经验分布,而非真实世界的完整分布。当训练数据、输入条件或目标分布发生变化时,模型内部的决策边界可能发生剧烈移动。
具体而言:
- 稳定性问题常源于训练过程的随机性(初始化、批顺序、Dropout)与数据采样偏差,导致模型落入不同的局部最优;
- 鲁棒性问题常源于模型对特定特征维度的过度依赖,当这些特征被噪声污染或缺失时,预测逻辑崩溃;
- 外推风险常源于模型在训练分布之外仍进行高置信度插值或 extrapolation,而缺乏不确定性表达机制。
1.5 方法流程:验证工作的基本闭环
本课程贯穿一个可复用的验证闭环,建议在每个项目中按以下步骤执行:
- 定义验证目标:明确要验证的是稳定性、鲁棒性还是外推风险,或三者组合;
- 构造验证数据集:包括多随机种子训练集、扰动测试集、分布外测试集与边界样本集;
- 设计实验协议:固定变量、控制随机性、记录完整配置;
- 执行评估:计算性能均值、方差、最差情况指标与置信区间;
- 分析失败模式:定位性能下降的样本类型与特征维度;
- 输出验证报告:给出通过/不通过结论与改进建议。
以下是一个最小化的验证配置示例,用于记录实验参数:
experiment:
  name: stability_check_v1
  model: gradient_boosting
  seeds: [0, 1, 2, 3, 4]
  train_subsets: [0.8, 0.9, 1.0]
  noise_levels: [0.0, 0.05, 0.1]
  ood_split: holdout_region
  metrics:
    - accuracy
    - f1
    - worst_case_accuracy
    - std_over_seeds
1.6 案例与场景:三类风险的典型表现
场景一:金融风控模型。某评分模型在历史数据上AUC达到0.92,但上线后遇到经济周期切换,新样本分布偏移,模型拒绝率异常升高。这是典型的外推风险与鲁棒性不足叠加。
场景二:医疗影像诊断。同一模型在不同医院设备采集的图像上表现差异巨大,换一台扫描仪指标下降15%。这属于输入分布扰动下的鲁棒性问题。
场景三:推荐系统。更换随机种子重新训练后,线上CTR波动超过8%,无法判断是模型改进还是随机噪声。这是稳定性验证缺失的典型后果。
1.7 实战价值与复盘要点
掌握本章内容后,学习者在实际工作中可以获得三方面收益:第一,在模型上线前识别潜在失败模式,降低生产事故概率;第二,建立可复现的验证标准,让模型对比结论更可信;第三,在合规与审计场景中提供完整的风险验证证据链。
复盘时建议重点检查以下清单:
- 是否在多个随机种子下重复训练并报告方差?
- 是否测试了输入噪声、缺失与分布偏移下的性能?
- 是否构造了训练分布之外的测试样本?
- 是否记录了最差情况指标而非仅平均值?
- 是否将验证结论写入模型验收文档?