3. 为什么需要稳健性
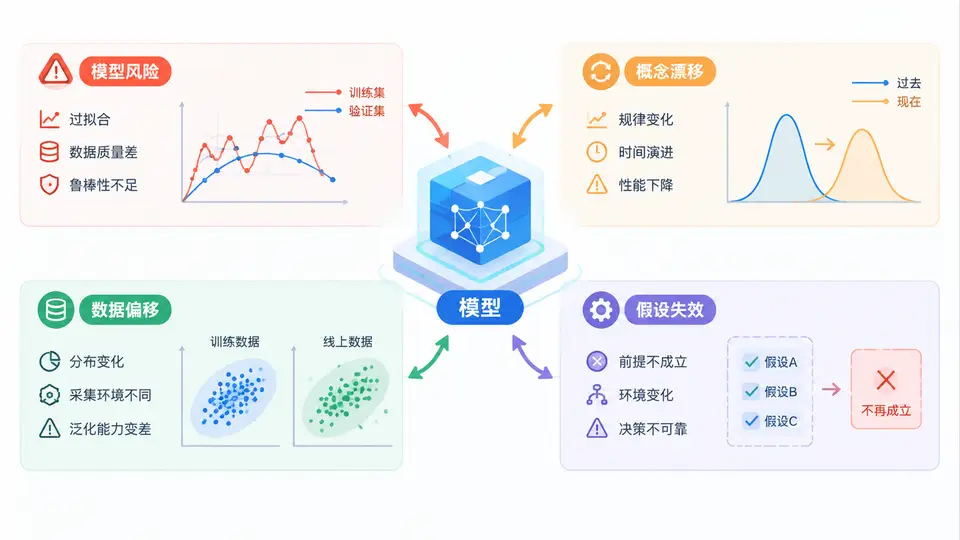
在真实业务环境中,模型上线从来不是终点,而是风险的起点。很多团队在离线评估中看到 AUC 0.92、F1 0.88 就认为“模型已经足够好”,但上线三个月后却发现转化率预测失准、风控误杀率飙升、推荐点击率持续下滑。问题往往不在模型本身“训练得不好”,而在于模型所依赖的世界已经变了,而模型却没有任何机制去感知和应对这种变化。稳健性(Robustness)要解决的核心问题就是:当数据分布、业务概念、系统环境或前提假设发生变化时,模型性能是否还能维持在可接受范围内。
一、核心原理:四类失稳来源
模型失稳通常来自四个层面,它们经常同时发生,但成因和应对方式不同。
- 模型风险:模型自身的过拟合、对噪声敏感、对异常输入脆弱,导致在训练集之外表现急剧下降。
- 概念漂移:输入与输出之间的真实关系发生变化。例如“同一批用户特征,过去代表高价值,现在代表高风险”。
- 数据偏移:输入分布 P(X) 发生变化,但 P(Y|X) 未必改变。例如流量来源从自然搜索变成信息流投放。
- 假设失效:建模时默认的因果结构、采样机制、特征可得性、业务规则不再成立。例如“用户点击后必然产生曝光”这一假设在改版后不再成立。
稳健性不是追求模型永远不退化,而是追求退化可检测、影响可量化、策略可回退、假设可验证。
二、方法流程:从监控到验证的闭环
要让稳健性从口号变成工程能力,需要建立一条可执行的闭环流程:
- 定义关键指标与容忍阈值:不仅监控准确率,还要监控输入分布、输出分布、业务 KPI 和延迟。
- 建立基线快照:保存训练集、验证集、上线首周数据的统计摘要,作为后续对比基准。
- 持续检测偏移:对数值特征使用 PSI、KS,对类别特征使用卡方或频率差,对嵌入使用距离度量。
- 触发假设验证:当偏移超过阈值时,回溯核心假设是否仍然成立,而不是直接重训。
- 执行应对策略:根据严重程度选择重新加权、在线学习、模型切换、规则兜底或人工审核。
- 复盘与归档:记录每次漂移的根因、处理动作和恢复时间,形成组织记忆。
# 示例:使用 PSI 监控关键特征偏移
import numpy as np

def psi(base, current, bins=10):
    base_perc, edges = np.histogram(base, bins=bins, density=True)
    curr_perc, _ = np.histogram(current, bins=edges, density=True)
    base_perc = np.clip(base_perc, 1e-6, None)
    curr_perc = np.clip(curr_perc, 1e-6, None)
    return np.sum((curr_perc - base_perc) * np.log(curr_perc / base_perc))

# PSI < 0.1 稳定;0.1~0.25 需关注;> 0.25 显著偏移
print(psi(train_feature, online_feature))
三、案例与场景:失稳如何造成真实后果
| 场景 | 失稳类型 | 典型表现 | 业务后果 |
|---|---|---|---|
| 电商推荐系统大促期间 | 数据偏移 + 概念漂移 | 用户行为从“浏览比价”变为“抢购囤货” | 推荐点击率下降,GMV 损失 |
| 风控模型遇到新型欺诈 | 概念漂移 + 假设失效 | 历史欺诈特征不再区分新手法 | 资损上升或误杀正常用户 |
| 医疗影像模型跨院部署 | 数据偏移 | 设备型号、拍摄参数不同导致像素分布变化 | 诊断准确率大幅下降 |
| NLP 情感分析遇到新梗 | 概念漂移 | 同一词汇情感极性反转 | 舆情误判,公关响应延迟 |
| 供应链需求预测遇到疫情 | 假设失效 | 历史季节性规律完全被打破 | 库存积压或断货 |
最常见的误区是:一检测到指标下降就立刻重新训练模型。如果根因是数据采集管道变更或业务规则调整,重训只会把错误固化进新模型,甚至加速退化。
四、误区与复盘:稳健性验证的常见陷阱
在实际项目中,团队常陷入以下误区:
- 只看整体指标,不看切片:整体 AUC 没降,但某个重要客群已经崩了。
- 把偏移检测当成一次性任务:没有持续监控,漂移发生数周后才被发现。
- 混淆数据偏移和概念漂移:前者可通过重加权缓解,后者往往需要重新定义标签或引入新特征。
- 忽略假设的显式化:很多假设从未被写下来,因此失效时无人察觉。
- 没有回退方案:模型一旦上线就无路可退,故障时只能硬扛。
一个实用的复盘模板:何时发现 → 哪个指标异常 → 根因属于哪类失稳 → 哪个假设被打破 → 采取了什么动作 → 恢复用了多久 → 如何提前发现。坚持记录,团队的稳健性能力会显著提升。
稳健性之所以必须被当作一等公民,是因为真实世界不会按照训练集的分布运行。模型风险、概念漂移、数据偏移和假设失效不是小概率事件,而是生产环境的常态。只有把稳健性验证嵌入日常流程,才能让模型在变化中保持可信,而不是在变化中悄悄失效。