1. 课程导入
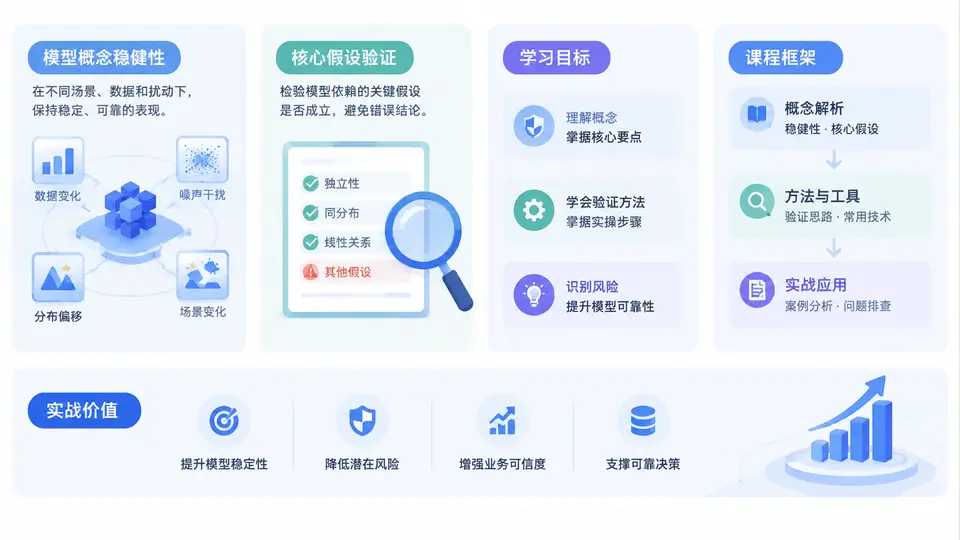
在机器学习与数据建模的实践中,我们常常遇到一种令人困惑的现象:一个模型在训练集和验证集上表现优异,指标漂亮得足以写进汇报材料,但一旦部署到真实业务环境,效果却迅速衰减,甚至产生方向性错误。更棘手的是,当团队试图复现或迭代这个模型时,发现换一批数据、调整一个特征、改变一个时间窗口,结论就完全翻转。这类问题的根源,往往不在于算法本身不够先进,而在于模型所依赖的概念与核心假设没有被系统性地检验。
本课程围绕“模型概念稳健性”与“核心假设验证”两个关键词展开,帮助学员建立一套从定义、诊断到修复、复盘的完整方法论。第1章作为导入,将明确这两个概念的内涵、课程的学习目标、整体框架以及实战价值,为后续29章的深入实战打下认知基础。
一、什么是模型概念稳健性与核心假设验证
模型概念稳健性,指的是模型所学习的输入与输出之间的映射关系,在不同数据分布、不同时间阶段、不同子群体以及不同扰动条件下,仍然保持语义一致和预测稳定的能力。这里的“概念”不是指业务名词,而是指模型真正依赖的判别逻辑。例如,一个信贷违约模型如果主要依赖“近期查询次数”这一特征,那么当查询行为因政策变化而整体减少时,模型的概念基础就被动摇了。
核心假设验证,则是对建模过程中隐含的、通常未被显式写出的前提条件进行识别、检验和量化。这些假设包括但不限于:样本独立同分布、特征与标签关系稳定、缺失机制随机、因果方向正确、子群体间无系统性偏差等。核心假设一旦不成立,模型的高指标就可能是虚假繁荣。
一句话概括:概念稳健性关注“模型学到的逻辑是否稳定”,核心假设验证关注“支撑这套逻辑的前提是否成立”。两者互为表里,缺一不可。
二、学习目标
完成本课程后,学员应能够达到以下目标:
- 能够用结构化语言描述一个模型所依赖的核心概念与关键假设,并区分显性假设与隐性假设。
- 掌握至少5类概念稳健性诊断方法,包括时间切片检验、子群体一致性分析、特征扰动敏感度、反事实测试和分布漂移监控。
- 能够针对核心假设设计可执行的验证方案,并解读验证结果对模型上线决策的影响。
- 能够在模型复盘报告中,清晰呈现假设违背的风险等级、影响范围和修复优先级。
- 建立“假设—验证—修复—再验证”的闭环工作习惯,而非一次性通过指标验收。
三、整体课程框架
课程共30章,按“认知—诊断—验证—修复—复盘”五阶段推进。第1章为导入,第2至6章建立概念稳健性的理论基础与度量体系;第7至14章深入核心假设的识别与验证方法;第15至22章进入实战场景,覆盖金融风控、推荐系统、医疗预测、工业质检等领域;第23至28章聚焦修复策略与工程化落地;第29至30章为综合案例与复盘方法论。
| 阶段 | 章节范围 | 核心任务 | 关键产出 |
|---|---|---|---|
| 认知建立 | 第1-6章 | 理解概念稳健性与假设验证的定义、度量与诊断框架 | 模型假设清单、稳健性指标看板 |
| 假设验证 | 第7-14章 | 识别隐性假设,设计验证实验,量化违背程度 | 假设验证报告、风险等级矩阵 |
| 场景实战 | 第15-22章 | 在真实业务场景中应用诊断与验证方法 | 场景化诊断方案、修复前后对比 |
| 修复落地 | 第23-28章 | 针对违背假设进行特征、模型、数据层面的修复 | 修复方案、再验证结果、上线检查单 |
| 综合复盘 | 第29-30章 | 端到端案例复盘,形成组织级方法论 | 复盘模板、团队协作流程 |
四、实战价值与典型场景
概念稳健性与假设验证的实战价值,体现在三个层面。第一,降低上线风险:在模型部署前发现假设违背,避免线上事故。第二,提升迭代效率:当效果衰减时,能快速定位是数据漂移、概念漂移还是假设失效,而不是盲目调参。第三,增强沟通说服力:用假设验证结果向业务方解释模型边界,比单纯汇报AUC更有说服力。
考虑一个推荐系统场景:模型在历史数据上表现良好,但上线后点击率下降。若仅看整体指标,可能误判为“用户兴趣变化”。但通过子群体一致性分析发现,新用户群体的预测偏差显著大于老用户,进一步验证发现模型隐含假设“用户历史行为长度足够”在新用户上不成立。这就是核心假设验证的直接价值。
实战中,建议把“假设验证”作为模型开发流程的强制关卡,而不是可选项。每个模型上线前,至少完成一次核心假设清单的逐项检查,并记录验证结论。
五、常见误区与复盘要点
在导入阶段,有必要先澄清几个常见误区,避免后续学习走偏。
- 误区一:指标好就等于模型稳健。 指标只反映特定数据集上的平均表现,无法揭示子群体差异和分布变化下的稳定性。
- 误区二:假设验证是一次性工作。 数据分布和业务环境持续变化,假设需要定期复验,而非上线前做一次就结束。
- 误区三:所有假设都必须严格成立。 现实中假设往往部分成立,关键是量化违背程度及其对预测的影响,而非追求完美。
- 误区四:概念稳健性只是算法团队的事。 业务方对场景变化最敏感,假设识别需要业务、数据、算法三方共同参与。
复盘时,最容易犯的错误是“事后归因”:模型出问题后,才回头找假设。正确做法是在建模初期就建立假设清单,并在每个迭代周期主动验证,把风险前置。
六、本章小结与行动建议
本章明确了模型概念稳健性与核心假设验证的定义、学习目标、课程框架和实战价值。概念稳健性关注模型逻辑在不同条件下的稳定性,核心假设验证关注支撑逻辑的前提是否成立。两者共同构成模型可信度的基石。
作为行动建议,请在进入后续章节前,选择一个你熟悉的模型,尝试列出它可能依赖的3条核心假设,并思考:如果这些假设不成立,模型会怎样失效?这个练习将帮助你带着问题进入后续学习,提升实战转化率。
行动清单:
1. 选择一个已上线或即将上线的模型。
2. 写出3条你认为它隐含依赖的核心假设。
3. 对每条假设,标注:验证难度(高/中/低)、影响范围(全局/局部)。
4. 思考:如果该假设被违背,最可能的业务表现是什么?
5. 带着这份清单进入第2章学习。
概念稳健性与假设验证不是额外的负担,而是让模型从“实验室可用”走向“生产可信”的必经之路。接下来的章节,我们将逐一拆解诊断方法、验证工具和修复策略,帮助你把这一理念转化为可落地的工程能力。