3. Outcome Analysis概述
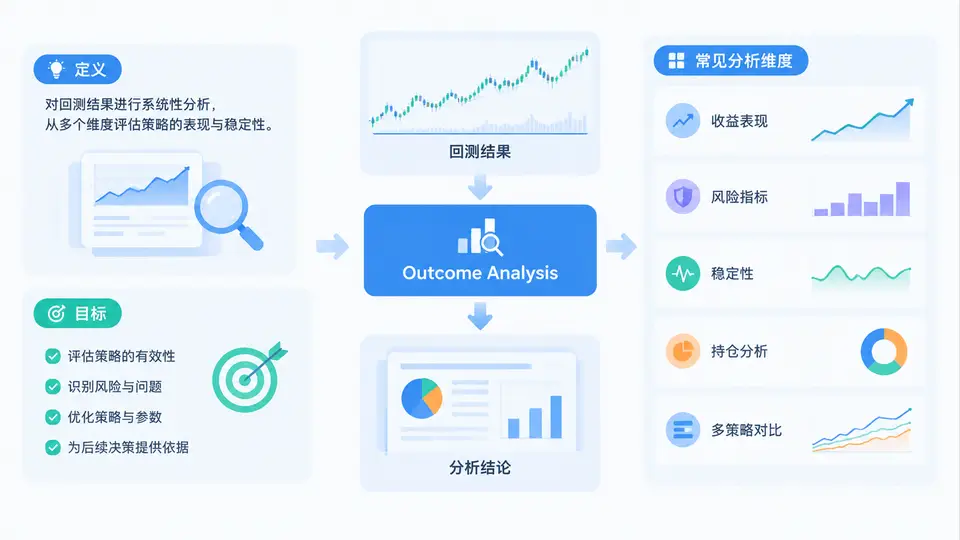
在模型回测体系中,Outcome Analysis(结果分析)指的是:在回测或仿真运行结束后,对模型产生的交易记录、信号记录、持仓变化、资金曲线及风险指标进行系统化拆解与解释的过程。它回答的不是“模型赚不赚钱”这一个问题,而是“模型为什么赚、为什么亏、在什么条件下有效、在什么条件下失效”。如果说回测是实验,那么结果分析就是对实验数据的统计推断与归因诊断。
很多团队把回测报告等同于结果分析,这是常见误解。回测报告通常只呈现净值曲线、年化收益、最大回撤等汇总指标;而结果分析要求进一步回答收益来源、风险暴露、交易质量、参数敏感性、样本内外一致性等问题。前者是“体检报告”,后者是“诊断报告”。
一、结果分析的定义与核心目标
从工程视角看,结果分析是对回测输出数据集进行多维度切片、聚合、对比和归因的过程。其输入通常包括:逐笔交易明细、每日持仓与净值、信号触发日志、参数配置、基准数据;其输出则是可解释的结论与可执行的改进建议。
结果分析的核心目标可以归纳为四点:
- 验证有效性:判断模型收益是否来自真实可重复的规律,而非过拟合、数据泄漏或幸存者偏差。
- 归因收益与风险:拆解收益来自哪些品种、时段、因子或交易类型,风险又集中在哪些暴露上。
- 评估稳健性:通过参数扰动、样本外测试、不同市场状态下的表现,判断模型是否稳定。
- 指导迭代:定位问题环节,为信号、仓位、风控、执行等模块提供优化方向。
关键区分:回测回答“发生了什么”,结果分析回答“为什么发生”以及“未来是否还会发生”。没有结果分析的回测,只是数字堆砌;没有回测的结果分析,则缺乏数据基础。
二、结果分析与回测的关系
回测与结果分析构成一个闭环:回测负责生成数据,结果分析负责解释数据,解释结论又反过来驱动模型修改,再进入下一轮回测。二者在流程上紧密衔接,但在职责上必须分离。
一个常见的工程实践是:回测引擎只负责按规则执行并输出标准化结果集,结果分析模块独立读取这些结果集进行统计与可视化。这样做的好处是分析逻辑不会污染回测逻辑,也便于复现和审计。下面是一个典型的结果集结构示例:
{
  "run_id": "bt_20240612_001",
  "strategy": "momentum_v3",
  "period": "2019-01-01 ~ 2024-05-31",
  "trades": [
    {"date": "2023-03-15", "symbol": "IF2306", "side": "long",
     "entry": 3980.2, "exit": 4012.6, "pnl": 3240.0, "holding_bars": 18}
  ],
  "daily_equity": [
    {"date": "2023-03-15", "equity": 1023400.0, "drawdown": -0.012}
  ],
  "metrics": {
    "annual_return": 0.183,
    "max_drawdown": -0.146,
    "sharpe": 1.42,
    "win_rate": 0.54,
    "profit_factor": 1.31
  }
}
结果分析模块读取上述结构后,可以按品种、时段、持仓周期、市场状态等维度进行分组统计。需要注意的是,回测阶段应尽量保留原始粒度数据,避免只保存汇总指标,否则后续分析将失去切片能力。
三、常见分析维度与清单
结果分析的维度选择取决于模型类型与业务目标,但以下维度具有较强通用性。下表给出常见维度、分析目的与典型指标:
| 分析维度 | 分析目的 | 典型指标 / 方法 |
|---|---|---|
| 收益维度 | 判断收益水平与稳定性 | 年化收益、夏普、卡玛比率、月度收益分布 |
| 风险维度 | 识别回撤与尾部风险 | 最大回撤、回撤持续期、VaR、CVaR、波动率 |
| 交易质量维度 | 评估信号与执行质量 | 胜率、盈亏比、利润因子、平均持仓周期 |
| 时间维度 | 观察不同市场状态下的表现 | 分年度、分季度、牛熊震荡分段统计 |
| 品种/标的维度 | 识别收益集中度与分散效果 | 分品种盈亏贡献、相关性矩阵 |
| 参数维度 | 检验稳健性与过拟合风险 | 参数敏感性热力图、样本外衰减率 |
| 成本维度 | 评估滑点与手续费影响 | 成本前后收益对比、换手率、成本占比 |
在实际项目中,建议先固定一套核心分析清单,再根据模型特点扩展。例如趋势跟踪模型应重点关注持仓周期与市场状态分段;高频模型则应重点关注成本敏感性与执行延迟。
四、方法流程与案例场景
结果分析的标准流程可以概括为五步:数据准备、指标计算、维度切片、归因对比、结论输出。以下是一个简化的分析脚本示例,展示如何按年度和品种进行盈亏归因:
import pandas as pd

trades = pd.read_csv("trades.csv", parse_dates=["date"])
trades["year"] = trades["date"].dt.year

# 按年度与品种聚合盈亏
report = trades.groupby(["year", "symbol"]).agg(
    total_pnl=("pnl", "sum"),
    trade_count=("pnl", "count"),
    win_rate=("pnl", lambda x: (x > 0).mean()),
    avg_pnl=("pnl", "mean")
).reset_index()

print(report.sort_values(["year", "total_pnl"], ascending=[True, False]))
假设某趋势模型在2019—2024年回测中年化收益18%,最大回撤14.6%,表面看表现良好。但通过分年度归因发现:2020年贡献了总收益的62%,而2022年亏损占最大回撤的70%。进一步按品种切片发现,收益高度集中在单一品种IF上,其他品种贡献接近于零。这说明模型并非广泛有效,而是依赖特定年份与特定标的的行情,稳健性存疑。
实践建议:结果分析应优先关注“收益集中度”和“最差情景”。一个模型如果80%的收益来自20%的交易,或最大回撤集中在某一小段时期,就需要警惕其可重复性。
五、常见误区与复盘要点
结果分析阶段最容易出现以下几类问题:
- 只看汇总指标,不做切片:年化收益和夏普比率会掩盖结构性缺陷,必须下钻到时间、品种、交易类型等维度。
- 混淆样本内与样本外:在样本内反复调参后的结果不具备预测意义,结果分析必须明确区分样本区间。
- 忽略交易成本与滑点:很多模型在扣除真实成本后收益大幅衰减,分析时应同时呈现成本前后对比。
- 过度归因于单一因素:将收益简单归因于某个因子或参数,而忽略市场状态、流动性等外部条件。
- 缺乏基准对比:没有基准的收益分析无法判断模型是否真正创造了超额收益。
复盘提醒:结果分析的结论必须可追溯。每一个“模型有效”或“模型失效”的判断,都应能回溯到具体的数据切片、指标计算和样本区间。否则分析结论本身也不可信。
综上,Outcome Analysis 是连接回测与模型迭代的关键环节。它要求分析者既理解统计指标,又理解策略逻辑与市场结构,能够从数据中识别真实规律与虚假繁荣。掌握结果分析的定义、目标、与回测的关系及常见维度,是后续深入学习归因方法、稳健性检验和报告体系的基础。