1. 课程导入
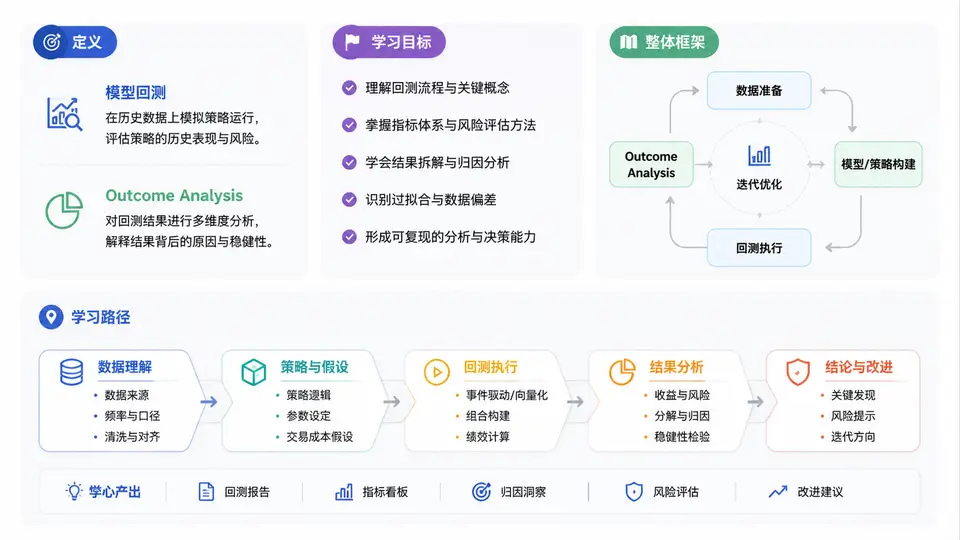
欢迎进入《模型回测与Outcome Analysis结果分析》课程。在机器学习、量化策略、风控评分、推荐系统乃至A/B实验等场景中,模型上线前的最后一道关卡,往往不是训练精度,而是回测与结果分析。很多团队在建模阶段投入大量精力,却在回测环节草率处理,导致上线后效果与预期严重偏离。本章作为全课程的导入,将帮助你建立对这两个核心概念的准确认知,明确学习目标,并给出30章的整体学习路径。
一、什么是模型回测与Outcome Analysis
模型回测(Model Backtesting)是指在历史数据上模拟模型在真实业务时序中的决策过程,评估其在不同时间段、不同市场状态或不同用户群体下的表现。它强调“时间一致性”:训练集、验证集与测试集必须按时间切分,避免未来信息泄露。回测不是简单地在测试集上跑一次指标,而是构建一套可重复、可审计的评估流程。
Outcome Analysis(结果分析)则是对回测输出进行系统性解读的过程。它回答的问题包括:模型在哪些样本上表现好?哪些特征驱动了预测?误差是随机波动还是结构性偏差?不同阈值下收益与风险如何权衡?结果分析将原始指标转化为可执行的业务洞察,是连接“模型分数”与“业务决策”的桥梁。
一句话区分:回测解决“模型在历史中表现如何”,Outcome Analysis解决“为什么这样表现、是否可信、如何改进”。两者互为表里,缺一不可。
二、学习目标
完成本课程后,你应能够:
- 独立设计符合业务时序的回测方案,正确划分训练、验证与滚动窗口;
- 计算并解释分类、回归、排序等不同任务的核心评估指标;
- 使用分组分析、误差归因、稳定性检验等方法开展Outcome Analysis;
- 识别常见陷阱,如数据泄露、幸存者偏差、过拟合回测、指标选择偏差;
- 输出结构化的回测报告,并与产品、运营、风控等角色有效沟通结论。
三、整体课程框架与学习路径
本课程共30章,按“基础—方法—实战—进阶”四段式组织。前8章建立概念与指标基础;第9至18章深入回测设计与结果分析方法;第19至26章通过金融、推荐、风控等场景实战;第27至30章讨论自动化回测平台、模型监控与持续迭代。
| 阶段 | 章节范围 | 核心内容 | 产出能力 |
|---|---|---|---|
| 基础篇 | 第1–8章 | 定义、指标、数据切分、可视化 | 能读懂回测报告 |
| 方法篇 | 第9–18章 | 滚动回测、分组分析、误差归因、稳定性 | 能独立设计回测 |
| 实战篇 | 第19–26章 | 量化、推荐、风控、A/B实验 | 能落地业务场景 |
| 进阶篇 | 第27–30章 | 自动化平台、监控、迭代闭环 | 能构建评估体系 |
建议学习路径:先通读基础篇建立术语体系,再按方法篇顺序动手实现,实战篇可选择与自身业务最接近的章节优先学习,最后用进阶篇收束为完整工程能力。
四、核心原理:回测的本质是“模拟决策时序”
回测的核心不是计算指标,而是还原模型在真实时间轴上的决策过程。以信贷风控为例,模型在每月初对存量客户打分,决定是否调额;下个月才能观察到是否逾期。若用随机划分的测试集评估,就会把未来信息混入训练,得到虚高指标。
# 错误做法:随机划分,存在时间泄露
train, test = train_test_split(data, test_size=0.2, random_state=42)

# 正确做法:按时间切分,训练集早于测试集
train = data[data['date'] < '2023-01-01']
test  = data[data['date'] >= '2023-01-01']

# 滚动回测:多个时间窗口依次训练与评估
for start, end in rolling_windows:
    model.fit(data[start:end])
    pred = model.predict(data[end:next_end])
    record_metrics(pred, y_true)
Outcome Analysis则在此基础上追问:指标变化来自数据分布漂移、模型退化,还是业务规则调整?只有把回测结果放回业务语境,分析才有意义。
五、案例场景:一个推荐系统的回测复盘
某电商推荐团队离线AUC达到0.82,上线后点击率却下降。复盘发现:回测使用了随机划分,且特征中包含“商品近7天销量”,而该特征在预测时点不可得,造成泄露。修正后按时间滚动回测,AUC降至0.74,与线上表现一致。进一步做Outcome Analysis,发现新用户群体误差显著高于老用户,原因是冷启动特征缺失。团队随后针对新用户单独建模,线上点击率回升。
该案例说明:回测方案设计错误会直接导致错误结论;Outcome Analysis的价值在于定位“哪类样本、哪个环节”出了问题,而非只给一个总分。
六、常见误区与复盘要点
- 误区一:只看单一指标。 AUC高不代表业务收益高,需结合精确率、召回率、收益曲线综合判断。
- 误区二:忽略时间因素。 随机划分、未来特征、标签延迟都会污染回测结果。
- 误区三:回测一次就结束。 模型需持续滚动回测,监控分布漂移与指标衰减。
- 误区四:结果分析停留在描述统计。 应进一步做分组、归因与假设检验,形成可执行建议。
复盘时务必保留回测配置、数据版本、随机种子与指标日志。没有可复现的记录,任何结果分析都不可信。
七、本章小结与行动清单
本章明确了模型回测与Outcome Analysis的定义、学习目标与30章框架。回测是时间一致的模拟评估,结果分析是面向业务的归因解读。两者共同构成模型上线前的决策依据。
- 用自己的话写下回测与结果分析的区别;
- 检查你当前项目的数据切分是否按时间进行;
- 列出你所在业务最关心的三个评估指标;
- 准备一份历史回测报告,尝试找出一个潜在泄露点。