3. 基准模型详解
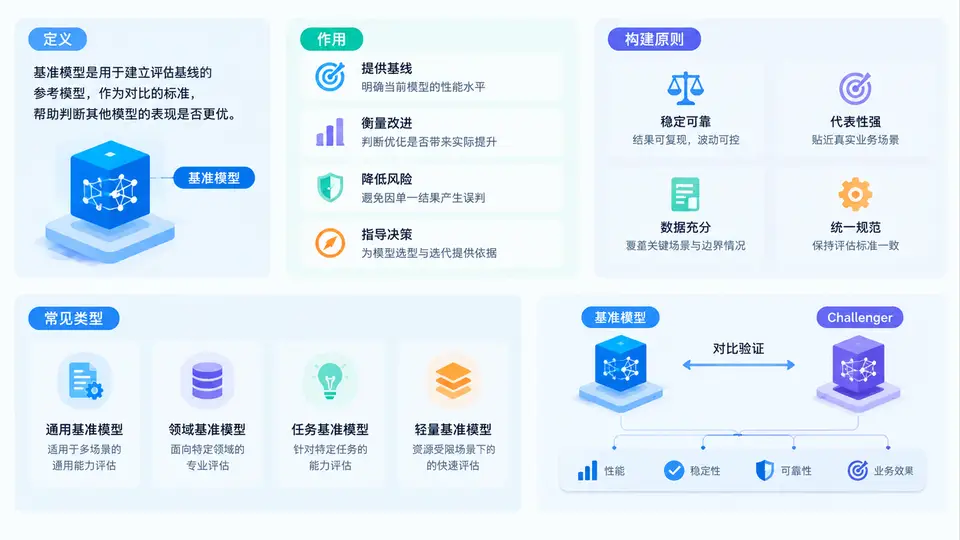
在对照验证的语境中,基准模型(Baseline Model)并不是“随便先跑一个模型”,而是被明确定义为参照物的模型版本。它承担的是“标尺”职责:后续所有Challenger模型的收益、风险、稳定性判断,都要以它为坐标原点。如果基准模型本身定义模糊、数据口径不一致或评估方式不稳定,那么对照验证的结论就失去可信度。因此,理解基准模型,本质上是在理解整套验证体系的度量基准。
一、核心原理:基准模型到底是什么
基准模型是指在某一业务目标、数据版本、特征口径和评估指标下,被正式选定为“当前生产标准”或“对照起点”的模型。它可以是线上正在运行的模型,也可以是经过冻结的离线模型,但必须满足三个条件:可复现、可解释、可比较。
- 可复现:给定相同数据与配置,能够重新得到相同或统计等价的输出。
- 可解释:其训练数据范围、特征处理、超参数、评估口径都有记录。
- 可比较:与Challenger使用同一套评估样本、同一指标定义、同一时间窗口。
从统计视角看,基准模型提供的是零假设的载体:我们默认“新模型没有显著优于基准”。只有对照实验结果足以拒绝这一假设,才考虑替换。因此,基准模型不是“最差的模型”,而是“当前最可信的参照”。
关键认知:基准模型的价值不在于它有多强,而在于它足够稳定、足够透明,使任何对比结论都能被复盘和审计。
二、方法流程:基准模型如何构建与冻结
构建基准模型通常遵循以下流程,每一步都需要留下可追溯的记录:
- 明确业务目标:确定优化目标是点击率、转化率、风险拦截率还是成本指标。
- 锁定数据快照:固定训练数据的时间范围、样本过滤规则和标签定义。
- 固化特征管道:记录特征版本、缺失值处理、归一化方式和特征哈希规则。
- 训练与调参:在既定搜索空间内完成训练,保存最优参数与随机种子。
- 离线评估:在独立验证集上计算核心指标与置信区间。
- 冻结与登记:将模型文件、配置、指标、数据版本写入模型登记表。
下面是一个基准模型登记配置的示例,用于保证后续对照实验可复现:
baseline:
  model_id: baseline_v2.3
  train_data: ds_2024_01_01_2024_03_31
  valid_data: ds_2024_04_01_2024_04_15
  feature_version: feat_v17
  algorithm: lightgbm
  params:
    num_leaves: 63
    learning_rate: 0.05
    n_estimators: 800
  seed: 20240415
  metrics:
    auc: 0.812
    logloss: 0.431
    calibration_error: 0.021
  frozen_at: 2024-04-16T10:00:00Z
冻结之后,基准模型不应随意更新。若因数据漂移必须更新,应创建新的基准版本,而不是覆盖旧版本,否则历史对照结论将无法复现。
三、常见类型:不同场景下的基准选择
基准模型并非只有一种形态。根据业务阶段和验证目的,常见类型包括:
| 类型 | 典型来源 | 适用场景 | 注意事项 |
|---|---|---|---|
| 线上生产模型 | 当前线上正在服务的版本 | 模型替换、A/B实验 | 需固定流量口径与时间窗口 |
| 离线冻结模型 | 历史训练并冻结的版本 | 离线对照、快速迭代 | 需确认与线上特征一致 |
| 规则基线 | 人工规则或专家策略 | 冷启动、风控兜底 | 指标口径可能与模型不同 |
| 简单统计模型 | 逻辑回归、均值预测 | 验证复杂模型增益 | 避免因基线过弱导致虚高 |
| 上一版Challenger | 上次实验胜出的模型 | 持续迭代、版本递进 | 需重新冻结并登记 |
选择哪种类型,取决于验证目标。若目标是“是否替换线上”,则线上生产模型是最自然的基准;若目标是“复杂模型是否值得引入”,则简单统计模型更适合作为起点。需要警惕的是,故意选择过弱的基准来制造“显著提升”,这是对照验证中最常见的自欺行为。
四、案例与场景:基准模型在实战中的作用
假设某推荐团队要验证一个新排序模型。当前线上模型A的AUC为0.812,新模型B离线AUC为0.826。若直接把B与A对比,看似提升明显。但进一步检查发现:A的训练数据截止到3月底,B使用了4月数据;A的特征版本为v17,B为v19。此时两者并不可比。
正确做法是:以A为基准,冻结其数据与特征口径,在相同验证集上重新评估A与B。若A在同一验证集上AUC为0.818,B为0.826,则真实增益约为0.008,而非0.014。这个案例说明,基准模型的核心作用不是“提供一个分数”,而是消除口径差异,让增益可被归因。
实践建议:在对照实验开始前,先做一次“基准复现检查”——用基准模型在本次评估集上重新打分,确认其指标与登记值偏差在可接受范围内。若偏差过大,应先排查数据或特征管道,而不是急于比较Challenger。
五、误区与复盘:基准模型常见问题
- 误区一:基准越弱越好。弱基准会放大Challenger的虚假增益,导致上线后收益不达预期。
- 误区二:基准可以随时更新。随意更新会破坏历史对照的可复现性,使实验结论无法审计。
- 误区三:只看单一指标。基准对比应同时关注AUC、LogLoss、校准误差和业务指标,避免指标间冲突。
- 误区四:忽略数据漂移。基准模型在旧数据上表现良好,不代表在当前分布下仍然稳定,需定期做漂移检测。
复盘要点:每次对照验证结束后,应记录基准模型的指标波动、数据版本变化和特征管道变更。若基准本身发生漂移,应先修复基准,再评估Challenger,否则结论不可信。
总结来看,基准模型是对照验证的“度量原点”。它通过明确的定义、严格的冻结流程、合理的类型选择和持续的漂移监控,为Challenger模型提供公平、可复现的比较基础。只有基准可靠,增益才可信;只有增益可信,模型迭代才真正可控。