1. 课程导入
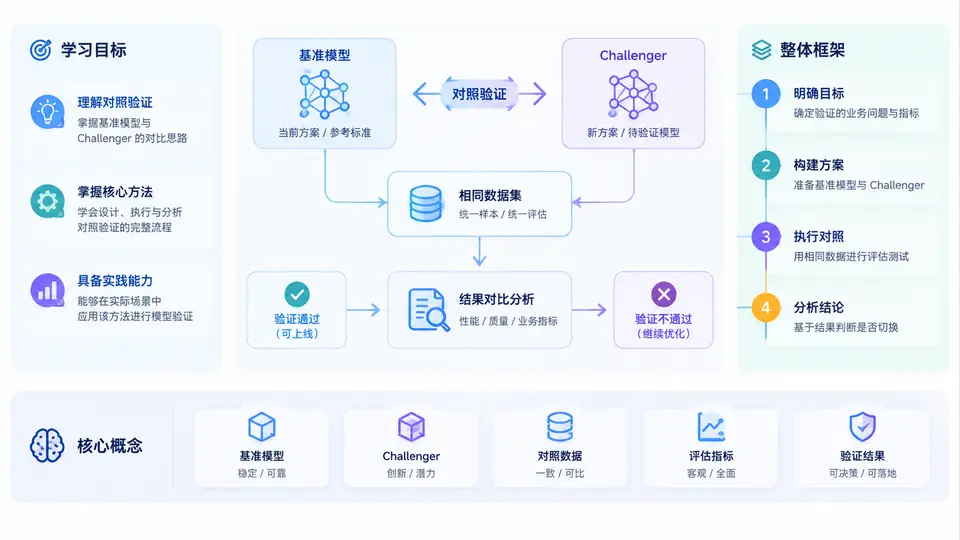
欢迎进入《基准模型与Challenger对照验证实战》。在开始写第一行验证代码之前,我们需要先建立一套清晰的认知框架:什么是基准模型,什么是Challenger,为什么二者必须对照验证,以及这套方法在真实工程中解决什么问题。本章不涉及复杂实现,而是为后续29章打下概念地基。
一、学习目标
完成本课程后,你将具备以下能力:
- 概念层:准确区分基准模型(Baseline)与Challenger模型的角色、职责和边界,理解“对照验证”与“单模型测试”的本质差异。
- 方法层:掌握从指标定义、数据切分、流量对齐到差异归因的完整验证流程,能够独立设计一份可执行的对照验证方案。
- 工具层:熟练使用配置化方式管理双模型运行参数,能够读取并解读对照日志、差异报告和显著性判定结果。
- 决策层:基于验证结论判断Challenger是否具备替换基准模型的条件,并识别“指标赢了但业务输了”的典型陷阱。
核心提醒:对照验证的目标不是证明Challenger更好,而是用可复现的证据回答“在什么条件下、哪个模型更合适”。验证结论必须能支撑上线、回滚或继续观察的决策。
二、核心概念:基准模型、Challenger与对照验证
基准模型(Baseline)是当前生产环境中正在服务、被业务方接受、作为参照系的模型。它未必是最优模型,但一定是“已知行为边界”的模型。基准模型的价值在于提供稳定的比较锚点:没有基准,任何新模型的指标都缺乏业务含义。
Challenger模型是待验证的候选模型,可能来自算法迭代、特征扩充、架构调整或外部引入。Challenger的使命是挑战基准,但挑战必须建立在同一数据、同一评价口径、同一业务约束之上,否则比较无效。
对照验证(A/B对照验证)不是简单地把两个模型各跑一遍然后比分数。它是一套受控实验方法,核心在于控制变量:相同输入、相同切分、相同指标定义、相同后处理逻辑,只让“模型”这一个因素变化。只有这样,观察到的差异才能归因于模型本身。
三者关系可以用一句话概括:基准模型定义“现在”,Challenger定义“可能”,对照验证定义“是否值得改变”。
三、整体框架:五步闭环
本课程后续章节将围绕以下五步闭环展开,本章先建立全局视图:
- 目标与指标对齐:明确业务目标,将其翻译为可计算的离线指标与在线指标,并确定主指标、护栏指标和辅助指标。
- 数据与流量准备:固定验证数据集,确保基准与Challenger看到完全相同的样本、相同的特征快照和相同的预处理版本。
- 双模型并行运行:通过统一配置驱动两个模型执行,记录原始输出、中间状态和资源消耗,避免人工拼接结果。
- 差异分析与显著性判定:对比指标差异,区分随机波动与真实提升,定位差异来源是数据、特征、模型还是后处理。
- 结论与决策:输出可复现的验证报告,给出替换、回滚、灰度或继续观察的明确建议。
这五步不是一次性流程,而是可重复的验证循环。每次Challenger迭代,都应回到第一步重新对齐目标,而不是直接复用上一次的指标口径。
四、方法流程与关键配置
为了让对照验证可复现,建议从一开始就用配置文件管理双模型运行参数。以下是一个最小化的验证配置示例,后续章节会逐步扩展:
# validation_config.yaml
experiment:
  name: "baseline_vs_challenger_round1"
  seed: 42
  dataset_version: "2024-06-snapshot"
  split: "test_fixed"

baseline:
  model_id: "baseline_v3"
  endpoint: "local://models/baseline_v3"
  params:
    threshold: 0.50
    batch_size: 256

challenger:
  model_id: "challenger_v4"
  endpoint: "local://models/challenger_v4"
  params:
    threshold: 0.50
    batch_size: 256

metrics:
  primary: ["auc", "f1"]
  guardrail: ["latency_p99", "memory_peak"]
  report: ["confusion_matrix", "segment_breakdown"]
注意配置中threshold和batch_size保持一致。如果Challenger换了阈值而基准没换,指标差异就无法归因于模型。这是新手最常见的对照污染来源。
实践建议:把“相同”当作默认约束,把“不同”当作需要显式声明的实验变量。任何一处不一致,都应在验证报告中标注为潜在混淆因素。
五、案例场景:推荐模型替换验证
假设某推荐系统当前使用基准模型B,团队训练了Challenger模型C,声称点击率预估AUC提升0.8个百分点。如果直接上线,可能忽略以下问题:
- C在头部热门商品上表现更好,但在长尾商品上AUC下降,导致整体指标被头部样本拉高。
- C的推理延迟P99从80ms上升到140ms,超出服务SLA,虽然离线指标更好但线上不可用。
- C对某类特征缺失更敏感,在流量低谷时段输出分布明显偏移。
对照验证的价值就在于:在离线阶段用固定测试集和分段分析暴露这些问题,而不是等上线后由业务方发现。验证报告应同时呈现主指标、护栏指标和分群指标,而不是只报一个总分。
六、常见误区与复盘清单
| 误区 | 表现 | 正确做法 |
|---|---|---|
| 只比总分 | 只看AUC或准确率,忽略分群和护栏指标 | 主指标+护栏指标+分群拆解三层呈现 |
| 数据不一致 | 两个模型用了不同版本的特征或样本 | 固定数据集版本与特征快照,写入配置 |
| 阈值不同步 | Challenger调了阈值,基准没调 | 阈值作为实验变量显式声明,默认保持一致 |
| 忽略随机性 | 单次运行差异当作真实提升 | 固定随机种子,多次运行取分布或做显著性检验 |
| 结论模糊 | 报告写“Challenger更好”但没有条件 | 结论必须包含适用条件、风险和决策建议 |
复盘要点:如果验证结论无法被第三方用相同配置复现,那么该结论不具备决策效力。可复现性是对照验证的底线,而不是加分项。
七、本章小结
本章建立了三个核心认知:第一,基准模型是参照系,Challenger是待验证候选,对照验证是受控实验;第二,验证流程是“目标对齐—数据准备—并行运行—差异分析—结论决策”的五步闭环;第三,可复现性来自配置化、固定变量和显式声明实验差异。接下来,我们将从目标与指标对齐开始,逐步把这套框架落到可执行的工程实践中。