3. 核心概念与术语
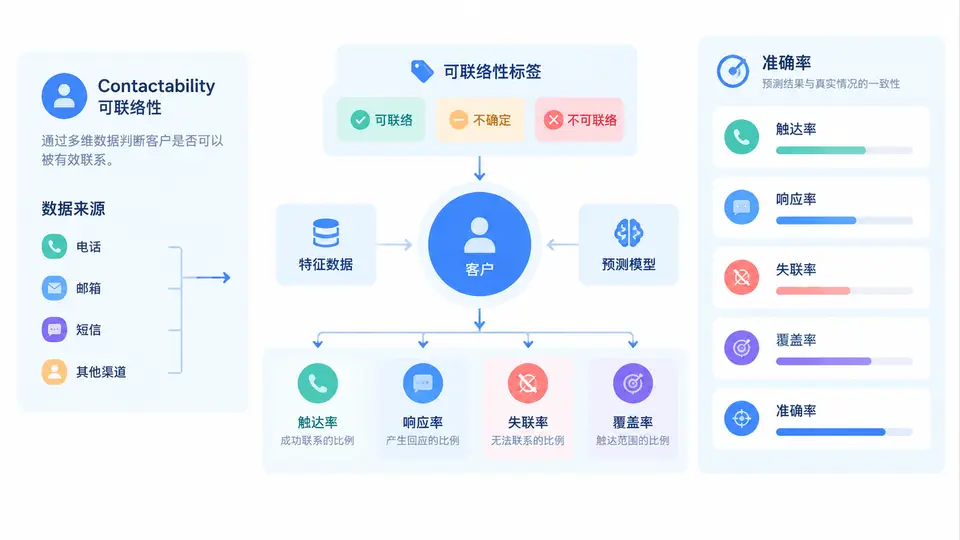
在失联客户预测项目中,业务方最常问的一句话是:“你们说的可联络,到底指什么?”如果这个概念没有统一,后续的建模、评估和运营动作都会走偏。本节把七个高频术语一次讲清,并说明它们之间的计算关系与使用边界。
一、核心原理:Contactability 是“可被成功接触”的概率
Contactability(可联络性)指在给定时间窗口、给定触达渠道和给定触达策略下,一个客户能够被成功接触到的可能性。它不是“客户是否存在”的问题,而是“我们能否在合适的时间、用合适的方式、以可接受的成本联系上他”的问题。
可联络性通常由三类因素共同决定:
- 客户侧因素:联系方式是否有效、是否停机、是否设置了拦截、是否习惯接听陌生来电。
- 渠道侧因素:外呼线路质量、短信通道到达率、APP 推送权限、企微/微信是否可加好友。
- 策略侧因素:拨打时段、拨打频次、号码轮换、话术与身份标识是否影响接听意愿。
因此,Contactability 是一个条件概率,必须绑定“渠道 + 时间窗 + 策略”才有意义。脱离这些条件谈“这个客户可联络”,在工程上是不严谨的。
二、可联络性标签:把概率问题转成监督学习问题
要建模,就必须先定义标签。可联络性标签通常是一个二分类变量:
label = 1  若在观察窗口内,该客户在指定渠道上被成功接触至少一次
label = 0  若在观察窗口内,该客户在指定渠道上未被成功接触
标签定义中最容易出错的是“观察窗口”和“成功接触”的口径。常见口径包括:
| 要素 | 常见口径 | 风险提示 |
|---|---|---|
| 观察窗口 | 7 天 / 14 天 / 30 天 | 窗口越长正样本越多,但业务时效性越差 |
| 成功接触 | 接通时长 ≥ 10 秒 / 客户有应答 | 口径过松会把骚扰误判为成功 |
| 渠道范围 | 单渠道 / 多渠道任一成功 | 多渠道会高估单渠道可联络性 |
| 样本过滤 | 排除黑名单、投诉、明确拒联 | 不排除会污染标签分布 |
建议在项目启动时就把标签口径写成《标签定义说明书》,并让业务、运营、算法三方签字确认。后续所有指标都以此为准,避免“各算各的”。
三、方法流程:从触达到评估的指标链路
七个术语并不是孤立的,它们构成一条从“尝试触达”到“模型评估”的完整链路。理解这条链路,才能正确解读报表。
- 触达率:成功触达人数 ÷ 尝试触达人数。它衡量的是“打出去的动作有多少真正到达了客户”。
- 响应率:有正向响应人数 ÷ 成功触达人数。它衡量的是“接触到之后客户是否愿意互动”。
- 失联率:1 − 触达率。它是最直观的运营压力指标,但要注意它和观察窗口强相关。
- 覆盖率:模型预测为可联络且实际被触达的人数 ÷ 全部实际被触达人数。它衡量模型“捞回”了多少真实可联络客户。
- 准确率:模型预测正确的样本数 ÷ 总样本数。它衡量整体判断质量,但在正负样本极不均衡时容易失真。
下面是一段典型的指标计算伪代码,便于在离线评估中复现:
touch_rate      = tp_count / attempt_count
response_rate   = response_count / tp_count
lost_rate       = 1 - touch_rate
coverage        = tp_pred_touch / tp_count
accuracy        = (tp_pred_touch + tn_pred_untouch) / total_count
准确率在失联客户场景中往往具有欺骗性。若可联络客户仅占 8%,一个“全部预测为失联”的模型准确率也能达到 92%。因此必须同时看覆盖率、召回率和提升度。
四、案例与场景:一次外呼名单的指标复盘
假设某银行信用卡中心对 10,000 名失联客户发起外呼,实际接通 1,200 人,其中 300 人完成还款承诺。模型事前预测 2,000 人为可联络,其中 900 人实际接通。
- 触达率 = 1,200 ÷ 10,000 = 12%
- 响应率 = 300 ÷ 1,200 = 25%
- 失联率 = 1 − 12% = 88%
- 覆盖率 = 900 ÷ 1,200 = 75%
- 准确率 = (900 + 8,000 − 800) ÷ 10,000 = 81%
这组数字说明:模型覆盖了 75% 的真实可联络客户,但预测为可联络的 2,000 人中只有 900 人接通,精确率仅 45%。如果运营按模型名单优先外呼,会浪费大量线路资源。此时应调整阈值,或引入渠道偏好特征提升精确率。
五、误区与复盘:别把相关指标混为一谈
实际项目中最常见的四个误区:
- 把触达率当可联络性:触达率是历史结果,可联络性是面向未来的预测概率,两者不能直接等同。
- 用准确率单指标验收:类别不平衡下准确率虚高,必须结合覆盖率、召回率、F1 与业务提升度。
- 忽略渠道差异:同一客户在电话渠道失联,在短信或 APP 推送渠道可能可联络,标签必须分渠道定义。
- 观察窗口与运营窗口不一致:训练用 30 天窗口,运营只跑 3 天,指标会系统性偏低。
记住一条工程原则:标签定义决定模型上限,指标口径决定验收结论。在失联客户预测中,先把 Contactability 的条件说清楚,再谈模型和算法,才是可靠的落地路径。