1. 课程导入
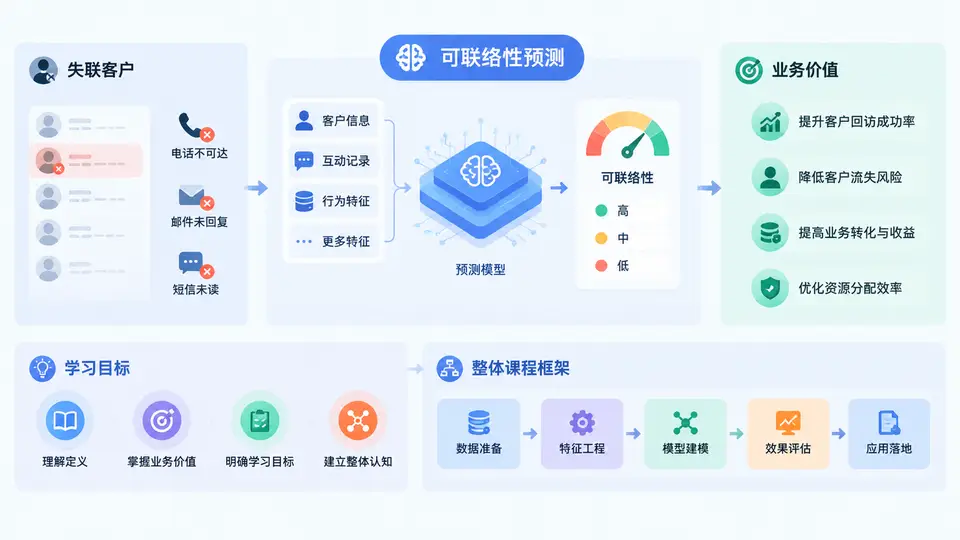
一、什么是失联客户可联络性预测
在信贷催收、保险续保、电商复购、会员召回等业务中,企业常常面对一批“联系不上”的客户:电话无人接听、空号、停机、关机,或接通后立即挂断。传统做法是把这些客户统一标记为“失联”,然后反复外呼或直接放弃。但真实情况是,失联不是一种静态状态,而是一种随时间、渠道、时段和客户行为变化的动态概率。同一位客户,在工作日午间拨打可能无人接听,在周末傍晚拨打却可能顺利接通;用电话联系不上,用短信、APP推送或邮件却可能触达。
失联客户可联络性预测(Contactability Prediction),就是利用客户的历史行为、账户属性、历史联络记录、外部标签和时间上下文等特征,构建机器学习模型,预测“在特定时间、特定渠道、特定策略下,该客户被成功联络的概率”。它的输出通常是一个0到1之间的可联络性分数,而不是简单的“能联系/不能联系”二分类标签。
从技术视角看,这是一个典型的概率预测问题,常以二分类模型实现,但业务上更关注排序能力和分数校准。因为催收团队、客服团队或营销团队每天能拨打的电话量有限,真正需要的是“把最可能接通的客户排在前面”,而不是追求一个绝对准确的硬标签。
二、业务价值:为什么值得单独建一门课
可联络性预测的直接价值体现在三个层面:
- 提升触达效率:在同样的人力与线路资源下,优先拨打高可联络性客户,接通率可显著提升,坐席无效等待时间下降。
- 降低运营成本:减少无效外呼、重复外呼、号码标记和投诉风险,同时降低短信、语音机器人等渠道的浪费。
- 改善客户体验与合规性:避免高频骚扰低响应客户,把联系资源集中在真正可触达且有意愿沟通的客户上,减少投诉与监管风险。
更关键的是,可联络性预测往往不是孤立模型,而是催收策略、营销策略和客户经营策略的前置模块。它决定了“能不能联系上”,后续的还款意愿预测、流失预测、响应预测才谈得上“联系上之后说什么”。因此,它常被称为客户经营链路中的“第一公里”。
核心判断:可联络性预测不是简单的号码清洗,而是把“联系客户”这件事从经验驱动升级为概率驱动。它的价值不在模型本身,而在于让每一次外呼、每一条短信、每一次推送都更有把握。
三、核心原理:从“失联标签”到“可联络概率”
理解可联络性预测,需要先区分三个容易混淆的概念:
| 概念 | 含义 | 典型标签 | 建模目标 |
|---|---|---|---|
| 失联状态 | 当前号码是否无法接通 | 空号、停机、关机 | 号码质量判断 |
| 可联络性 | 在给定时间与渠道下成功触达的概率 | 接通、回复、点击 | 概率排序与分数校准 |
| 响应意愿 | 触达后是否愿意沟通或履约 | 承诺还款、下单、续保 | 转化预测 |
可联络性预测的核心原理可以概括为:用历史联络行为构造监督标签,用客户属性与时间上下文构造特征,用分类模型学习“在什么条件下更容易接通”的模式,再输出概率分数用于排序和策略分配。
一个常见的标签定义方式是:对每一次外呼记录,若通话时长超过阈值(如5秒)或客户有应答行为,则标记为1,否则为0。然后以“客户+日期+时段+渠道”为粒度聚合,形成训练样本。模型学习的是条件概率:
P(contactable = 1 | 客户特征, 历史联络行为, 时间上下文, 渠道)这个概率不是固定不变的。随着客户换号、作息变化、催收强度变化,模型需要定期重训和监控。因此,可联络性预测是一个持续迭代的工程系统,而不是一次性的建模任务。
四、方法流程:一个可落地的端到端框架
本课程后续章节会逐步展开,这里先给出整体流程,帮助建立全局认知:
- 业务定义与标签设计:明确“可联络”的业务口径,确定观察窗口、表现窗口和标签阈值。
- 数据准备与特征工程:整合账户、号码、历史外呼、短信、APP行为、时间上下文等数据,构造客户级、时段级和渠道级特征。
- 模型训练与评估:选择逻辑回归、梯度提升树等模型,使用AUC、KS、Lift、校准曲线等指标评估排序与概率质量。
- 策略应用与打分:将分数接入外呼系统,按分数排序分配坐席、选择拨打时段和渠道。
- 监控与迭代:监控分数分布、接通率、模型漂移和业务指标,定期重训与调优。
学习提示:不要一上来就追求复杂模型。可联络性预测的收益,往往更多来自标签定义清晰、特征贴近业务、策略落地顺畅,而不是模型从XGBoost换成深度学习。
五、案例场景:一个催收外呼的直观例子
假设某催收团队有1000个待联系客户,每天只能拨打300通电话。传统做法是按逾期天数从高到低拨打,结果接通率只有18%,大量坐席时间浪费在无人接听上。引入可联络性预测后,模型根据历史接通记录、号码活跃度、客户作息、近期短信回复等特征,给每个客户打出可联络性分数。团队优先拨打分数最高的300人,接通率提升到34%,同样人力下有效沟通量接近翻倍。
这个例子说明:可联络性预测的本质是资源分配优化。它不改变客户是否愿意还款,但改变了“把有限的联系机会给谁”的决策质量。
六、常见误区与复盘
- 误区一:把失联当成永久标签。客户可能只是暂时关机或换号,静态标签会误杀可联络客户。
- 误区二:只追求模型AUC,忽略分数校准。如果分数不能反映真实概率,策略阈值和成本核算就会失真。
- 误区三:忽略时间与渠道维度。同一客户在不同时段、不同渠道的可联络性差异很大,单一时点模型会浪费机会。
- 误区四:模型上线后不监控。号码质量、客户行为和外部环境都会变化,模型会漂移,必须持续监控与重训。
合规提醒:可联络性预测涉及客户联系方式与行为数据,必须在合法合规前提下使用,遵守个人信息保护、催收规范和通信管理相关要求,避免高频骚扰与数据滥用。
七、学习目标与整体课程框架
完成本课程后,你将能够:
- 独立完成可联络性预测的业务定义、标签设计和样本构造;
- 掌握特征工程、模型训练、评估与分数校准的完整方法;
- 把模型分数接入外呼、短信、APP推送等实际策略场景;
- 建立监控体系,识别模型漂移并持续迭代;
- 理解可联络性预测与响应预测、流失预测之间的协同关系。