1. 课程导入
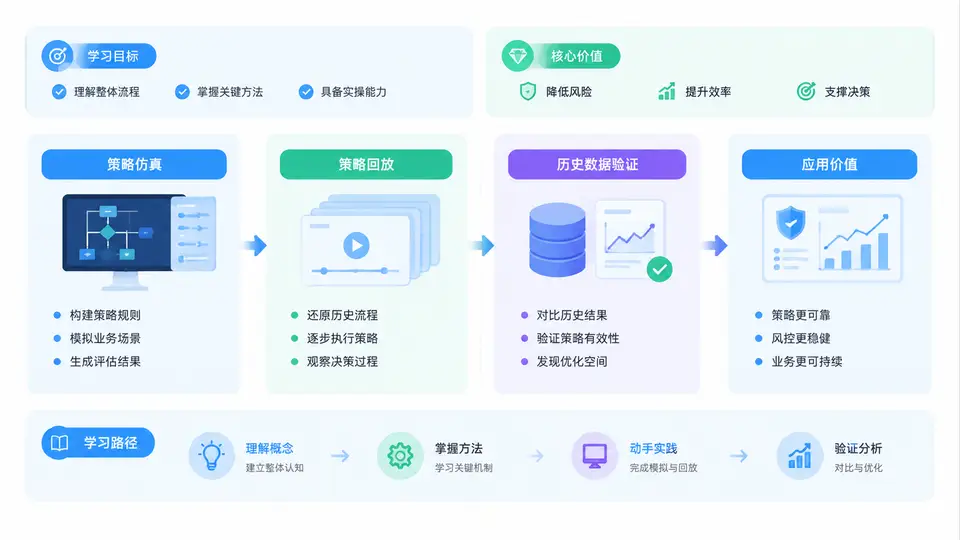
欢迎进入《授信策略仿真、回放与历史数据验证》课程。在信贷业务数字化与精细化运营的背景下,策略上线前的“拍脑袋决策”正在被系统化的仿真、回放与验证机制取代。本章作为全课程的导入,将帮助大家建立对这门课程的整体认知:我们为什么要学、学完能做什么、课程如何组织、以及按什么路径学习最有效。
一、为什么需要仿真、回放与历史数据验证
授信策略是信贷业务的核心决策逻辑,涵盖准入、额度、定价、期限、还款方式等关键环节。策略一旦上线,直接影响通过率、逾期率、资金收益与客户体验。传统策略迭代常面临三个痛点:
- 上线风险高:新策略直接投产,若逻辑缺陷或参数偏差,可能造成大规模误拒或风险敞口扩大。
- 效果难归因:策略调整后指标变化,究竟是策略本身起作用,还是市场环境、客群结构变化导致,难以剥离。
- 历史经验浪费:大量历史申请与表现数据未被系统化用于策略预演,导致重复试错。
仿真、回放与历史数据验证正是解决上述问题的三件套:仿真在虚拟环境中预演策略效果;回放将策略置于历史时间轴上重跑,观察其在不同时点的表现;历史数据验证则用真实已发生数据检验策略的区分能力、稳定性与收益性。三者结合,形成策略上线前的“安全气囊”和“校准仪”。
核心价值一句话总结:让授信策略从“经验驱动、上线后观察”转变为“数据驱动、上线前验证”,在风险可控的前提下提升策略迭代效率与决策质量。
二、学习目标:学完本课程你将掌握什么
本课程面向信贷策略分析师、风险建模人员、产品经理及数据科学从业者。通过30章的系统学习,目标可归纳为四个层次:
- 认知层:理解仿真、回放与历史数据验证的概念边界、适用场景与相互关系,能判断何时用哪种方法。
- 方法层:掌握策略仿真的实验设计、回放的时间切片与样本对齐、历史数据验证的指标体系和统计检验方法。
- 工具层:能够使用Python/SQL等工具搭建仿真流水线,配置回放参数,生成验证报告,并解读关键指标。
- 决策层:能基于仿真与验证结果,给出策略上线、调优或回退的建议,并设计灰度发布与监控方案。
需要强调的是,本课程不追求“一键出结果”的黑箱工具教学,而是强调可解释、可复现、可审计的工程化思维。每一个仿真结论都应有数据来源、假设条件和验证过程。
三、整体框架:课程的知识地图
全课程30章可划分为五个模块,形成从基础到进阶、从理论到落地的完整链路:
| 模块 | 章节范围 | 核心内容 | 产出能力 |
|---|---|---|---|
| 导入与基础 | 第1-4章 | 课程导入、授信策略基础、数据准备、仿真环境搭建 | 理解全局,能准备仿真所需数据与环境 |
| 仿真方法 | 第5-12章 | 策略仿真原理、实验设计、参数扫描、蒙特卡洛模拟、压力测试 | 能独立设计并执行策略仿真实验 |
| 回放技术 | 第13-19章 | 时间切片、样本对齐、策略版本管理、回放流水线、差异分析 | 能对策略进行历史时间轴回放与对比 |
| 历史数据验证 | 第20-26章 | 区分度指标、稳定性检验、收益测算、回溯测试、统计显著性 | 能用真实数据验证策略效果并出具报告 |
| 综合实战 | 第27-30章 | 端到端案例、灰度发布、监控体系、策略治理与复盘 | 能主导策略上线前的完整验证流程 |
五个模块之间不是线性割裂,而是螺旋上升:仿真中会用到历史数据验证的指标,回放中会嵌入仿真逻辑,综合实战则要求三者协同。建议在学习过程中不断回看前面的模块,形成交叉理解。
四、核心原理:仿真、回放与验证的底层逻辑
三者共享一个底层逻辑:用可控的输入,观察策略在目标样本上的输出,并与基准进行对比。区别在于“可控输入”和“目标样本”的构造方式。
- 仿真:输入是策略参数与模拟样本,样本可以来自历史数据重抽样,也可以由分布假设生成。核心是“如果……会怎样”。
- 回放:输入是历史某时间段的真实申请样本与当时的策略版本,按时间顺序重跑。核心是“当时如果用了新策略,结果会怎样”。
- 历史数据验证:输入是已发生真实数据与策略规则,直接计算策略在该数据上的表现指标。核心是“策略在真实数据上表现如何”。
关键区分:仿真可以创造历史中不存在的样本组合;回放严格依赖历史样本与时间顺序;历史数据验证则完全基于已发生事实。三者互补,不可互相替代。
五、方法流程:一个典型的策略验证闭环
为了让大家对后续章节有整体预期,这里给出一个通用的策略验证流程。后续章节会逐步展开每个环节的细节。
1. 明确目标:确定要验证的策略版本、核心指标(通过率、逾期率、收益等)
2. 数据准备:提取历史申请、表现、策略日志数据,完成清洗与对齐
3. 基准设定:确定对照组(当前线上策略或旧版本)
4. 仿真执行:配置参数,运行仿真,生成策略输出
5. 回放执行:按时间切片重跑历史样本,记录策略决策
6. 指标计算:计算区分度、稳定性、收益、通过率等指标
7. 对比分析:与基准对比,识别差异来源与显著性
8. 结论输出:给出上线、调优或回退建议,附风险提示
9. 灰度监控:小流量上线,持续监控,准备回退预案
这个闭环中,第4、5、6步是本课程的技术核心,第7、8步是决策核心,第9步是工程保障。缺少任何一步,验证都不完整。
六、案例场景:一个直观的例子
假设某消费信贷产品当前策略为“年龄22-55岁、无当前逾期、月收入≥3000元”,通过率45%,逾期率3.2%。业务方希望放宽年龄下限至20岁,以提升通过率。直接上线风险未知,于是启动验证:
- 仿真:在历史申请样本中,模拟“年龄20-21岁”客群的加入,观察通过率提升幅度与预期逾期率变化。
- 回放:选取过去12个月数据,按月度回放新策略,观察通过率与逾期率在时间轴上的波动,判断是否受季节性影响。
- 历史数据验证:用已放款的20-21岁客群真实表现,验证其逾期率是否显著高于其他年龄段,计算区分度与稳定性。
三者结论一致且风险可控时,才建议进入灰度发布。若仿真显示通过率提升但回放显示某几个月逾期率飙升,则需进一步分析原因,可能暂缓上线。
七、常见误区与复盘要点
误区一:把仿真当预测。仿真结果是条件性的“如果”,不是对未来的精确预测。必须明确假设边界。
误区二:回放时忽略样本漂移。历史样本的客群结构、市场环境与当前不同,回放结论需结合漂移分析。
误区三:只看通过率,不看风险调整后收益。通过率提升若伴随逾期率大幅上升,可能得不偿失。
误区四:验证一次就上线,不做灰度。验证降低风险,但不能消除风险,灰度与监控不可省略。
复盘时建议回答三个问题:假设是否合理?数据是否代表目标客群?结论是否在统计上显著?这三个问题贯穿全课程,也是后续每章练习的复盘框架。
八、学习路径建议
针对不同背景的学习者,建议采用差异化路径:
- 策略分析师:重点学习第5-12章仿真方法与第20-26章验证指标,结合自身业务数据同步练习。
- 数据科学家:重点关注实验设计、统计检验与回放流水线,强化工程化落地能力。
- 产品与业务人员:重点理解第1-4章基础与第27-30章综合实战,掌握验证结论的解读与决策应用。
- 管理者:建议通读框架与案例,重点理解验证闭环对策略治理的价值与资源投入。
无论哪条路径,都建议动手实践:每学完一个模块,用自己熟悉的数据集跑一遍仿真或回放,哪怕样本很小。只有亲手经历过数据对齐、参数配置、指标解读的完整过程,才能真正掌握这门课程的核心能力。
本章小结:仿真、回放与历史数据验证是授信策略上线前的三道防线。本课程将带你从概念到工具、从方法到实战,逐步构建可解释、可复现、可审计的策略验证能力。接下来,我们将从授信策略的基础知识开始,为后续的仿真与验证打下坚实基础。