1. 课程导入
一、为什么必须先建立“模型定位”
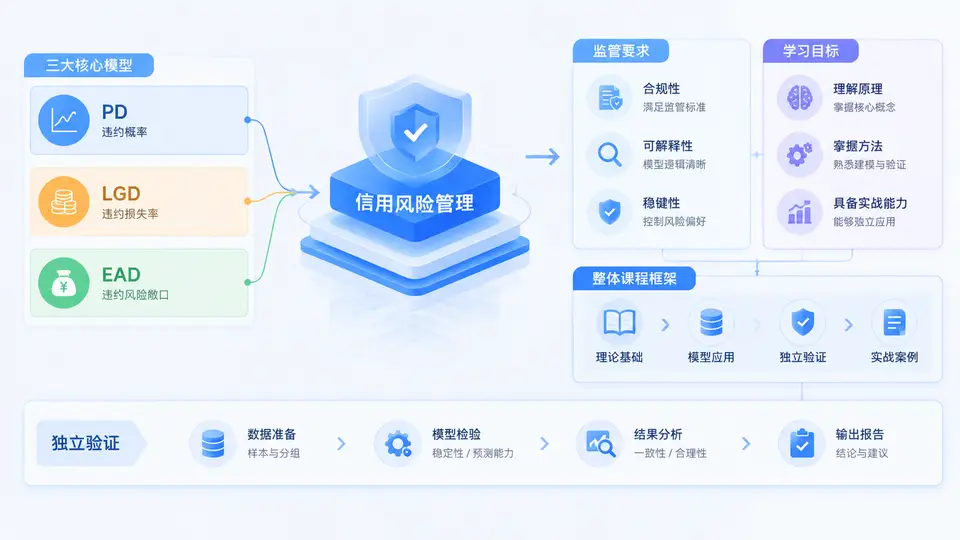
信用风险计量的核心,不是单独算出一个PD、LGD或EAD数字,而是把三个参数放回同一条风险传导链上理解:客户会不会违约(PD)、违约后到底损失多少(LGD)、违约时还欠多少钱(EAD)。三者相乘并叠加期限与相关性后,才形成预期损失(EL)与非预期损失(UL)的计量基础。
在商业银行、消费金融、汽车金融与供应链金融中,PD、LGD、EAD既是监管资本计量的输入,也是定价、授信、拨备、限额、经济资本的共同语言。很多团队的问题并非“不会建模”,而是模型定位不清:把PD当成营销评分、把LGD当成固定系数、把EAD当成合同金额,最终导致验证结论与业务决策脱节。
二、核心原理:三参数如何构成风险计量闭环
从风险形成机制看,一笔债权的信用损失可拆解为:
预期损失 EL = PD × LGD × EAD
非预期损失 UL = f(PD, LGD, EAD, 相关性, 置信水平)
风险加权资产 RWA = 12.5 × 资本要求(或按监管公式直接计算)其中,PD通常按“一年期违约概率”计量,LGD反映违约后的回收能力,EAD反映违约风险暴露。三者并非独立:高PD客户往往伴随更高LGD与更低回收率;循环授信下EAD还会随额度使用率变化。因此,模型文档必须说明参数定义、观察窗口、违约定义、回收口径、折现率、币种与担保处理,否则验证无法复现。
| 参数 | 回答的问题 | 常见计量口径 | 典型误区 |
|---|---|---|---|
| PD | 未来一段时间客户违约的可能性有多大? | 一年期违约概率、评级映射、迁移矩阵 | 用通过率或逾期率直接替代PD |
| LGD | 违约后最终损失占风险暴露的比例是多少? | 回收现金流折现、清收成本、担保覆盖 | 忽略折现与清收周期,直接按回收率倒算 |
| EAD | 违约时实际暴露有多大? | 已提用余额+未提用额度×CCF | 把合同额度等同于EAD |
三、方法流程:从建模到验证的工程化路径
本课程后续章节会反复使用同一条流程。导入阶段先建立全局视图:
- 定义与范围:明确资产池、违约定义、观察期、表现期、样本筛选与排除规则。
- 数据准备:数据血缘、缺失值、异常值、时间切片、违约标签与回收标签构建。
- 模型开发:PD采用评分卡或机器学习;LGD采用回收率模型或清收曲线;EAD采用CCF模型或额度使用率模型。
- 模型文档:记录假设、公式、参数、校准、限制、使用边界与变更历史。
- 独立验证:对数据、方法、实现、结果、稳定性与业务使用进行独立复现与挑战。
- 持续监控:区分度、校准、稳定性、回溯测试与模型风险预警。
四、案例场景:一个“看起来正确”的EAD模型为何被验证否决
某循环授信产品在建模时,将EAD简化为“合同额度×历史平均使用率”。文档中只写了平均使用率,未区分客户风险分层,也未考虑额度调降、冻结与季节性提款。独立验证抽取违约客户样本后发现:
- 低风险客户使用率长期低于30%,但违约前3个月骤升至85%以上;
- 高风险客户在额度调降后反而集中提款,CCF被系统性低估;
- 模型未设置额度调整后的观察窗口,导致EAD与违约时点错配。
验证结论并非“模型不能用”,而是要求补充风险分层CCF、违约前行为窗口与额度管理规则,并在文档中明确EAD的适用边界。这个案例说明:三参数模型的风险往往不在算法,而在定义与假设。
五、误区与复盘:导入阶段必须纠正的五个认知
- 误区一:PD、LGD、EAD可以各自独立开发、独立验证。实际上三者共享资产池、违约定义与观察窗口,必须交叉一致性检查。
- 误区二:模型文档是事后补写的合规材料。实际上文档是建模过程的一部分,缺失文档意味着假设不可追溯。
- 误区三:独立验证就是跑一遍代码看结果是否一致。验证还要挑战方法合理性、数据代表性与业务使用适当性。
- 误区四:校准好就代表模型好。区分度、校准、稳定性与业务可解释性需同时满足。
- 误区五:监管要求只是最低门槛。监管要求是治理底线,业务决策还需要更细的颗粒度与更快的监控频率。
六、整体课程框架与学习方式
本课程共30章,按“定位—数据—建模—文档—验证—监控”推进。导入章之后,将依次进入PD、LGD、EAD的专项建模与文档实战,再进入独立验证的方法、案例与整改闭环。每章均以可操作的清单、参数示例与验证要点收束,帮助你把知识转化为可交付的文档与验证报告。
学习路径示意:
定位与监管 → 数据与定义 → PD建模与文档 → LGD建模与文档 → EAD建模与文档
→ 独立验证方法 → 验证案例 → 监控与整改 → 综合实战