3. 分箱基础
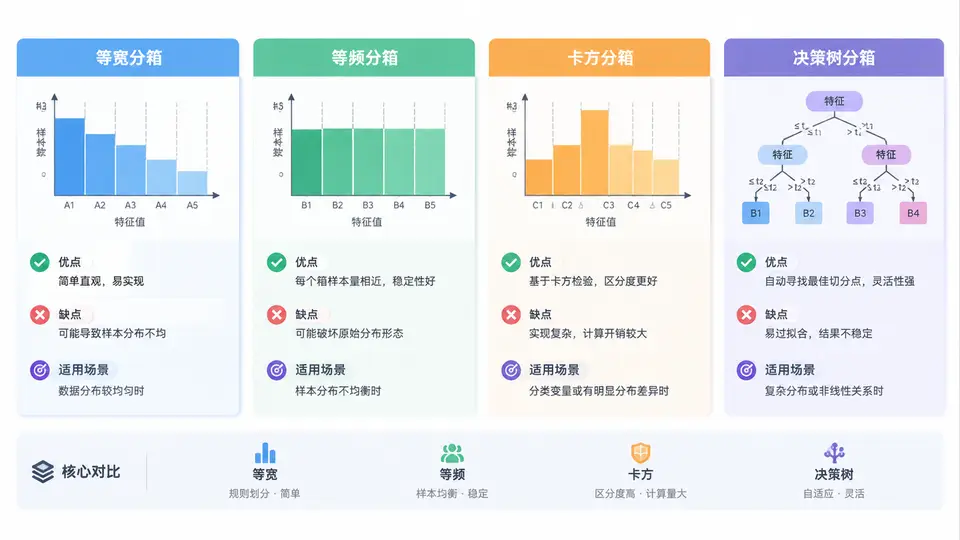
在信用评分、风控建模与用户分层等任务中,分箱(Binning)是把连续变量离散化的关键步骤。它既影响WOE与IV的计算稳定性,也直接决定模型的可解释性与上线后的监控难度。很多初学者一上来就追求“最优分箱”,却忽略了不同分箱方法本身有截然不同的假设与代价。本节把四种最常用的基础分箱方法放在同一张“手术台”上对比:等宽、等频、卡方、决策树分箱,讲清它们的核心原理、执行流程、优缺点与适用场景,为后续WOE与IV最优分箱及单调性约束打下基础。
一、核心原理:四种分箱到底在“切”什么
分箱的本质是寻找一组切点,把连续变量的取值域划分为若干区间。不同方法寻找切点的依据不同,因此对数据分布的敏感度也不同。
- 等宽分箱:按变量取值范围等距离切分。例如年龄18~70岁,分成5箱,每箱宽度为(70-18)/5=10.4岁。它只关心“数值跨度”,不关心样本分布。
- 等频分箱:按样本数量等比例切分,使每箱样本数大致相同。它关心“样本密度”,常用于让每箱都有足够的统计量。
- 卡方分箱:基于卡方统计量自底向上合并相邻区间,合并后类别分布差异最小的区间优先合并,直到满足停止条件。它关心“目标变量区分度”。
- 决策树分箱:用单变量决策树对连续变量做分裂,以信息增益、基尼系数或MSE等指标选择切点,叶子节点即分箱。它关心“预测能力”。
二、方法流程与关键参数
下面用一段Python伪代码展示四种分箱的典型调用方式,重点观察参数差异。实际项目中可基于pandas、scikit-learn或toad等库实现。
import pandas as pd
import numpy as np
from sklearn.tree import DecisionTreeClassifier

# 等宽分箱:指定箱数
df['age_ew'] = pd.cut(df['age'], bins=5, labels=False)

# 等频分箱:按分位数切分
df['age_ef'] = pd.qcut(df['age'], q=5, labels=False, duplicates='drop')

# 卡方分箱(以toad为例)
import toad
combiner = toad.transform.Combiner()
combiner.fit(df[['age']], df['y'], method='chi', n_bins=5)
df['age_chi'] = combiner.transform(df[['age']])

# 决策树分箱:限制最大叶子数
tree = DecisionTreeClassifier(max_leaf_nodes=5, min_samples_leaf=0.05)
tree.fit(df[['age']], df['y'])
df['age_dt'] = tree.apply(df[['age']])
流程上,四种方法都遵循“确定切点→生成区间→映射标签”的通用步骤,但停止条件不同:等宽和等频由箱数或宽度直接决定;卡方依赖显著性水平、最大箱数和最小箱占比;决策树依赖树深度、叶子节点最小样本数和分裂准则。参数设置不当,都会导致分箱过粗或过细。
三、优缺点对比与适用场景
下表从计算复杂度、对异常值敏感度、单调性、可解释性和适用场景五个维度进行对比。建议在项目初期先做探索性分箱,再根据IV和单调性做二次调整。
| 方法 | 核心依据 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 等宽分箱 | 数值范围等距 | 简单直观、易解释、计算快 | 对偏态分布不友好,某些箱样本极少甚至为空 | 变量分布均匀、业务规则明确的场景,如年龄分段 |
| 等频分箱 | 样本数量等比例 | 每箱样本量均衡,统计稳定 | 相同数值可能被切到不同箱,切点随样本波动 | 样本量大、分布偏斜、需要稳定WOE估计的场景 |
| 卡方分箱 | 类别分布差异 | 自动合并相似区间,区分度较好,可控制箱数 | 计算量较大,可能不单调,需人工干预 | 信用评分、风控建模中追求IV最大化的场景 |
| 决策树分箱 | 预测纯度 | 能捕捉非线性关系,切点由数据驱动 | 容易过拟合,箱数不稳定,可解释性较弱 | 特征与标签关系复杂、样本量充足、允许黑箱探索的场景 |
四、案例与误区复盘
假设我们有一个“近6个月逾期次数”变量,取值0~20,样本10万,坏样本占比5%。如果直接用等宽分箱分成5箱,会出现0~4、4~8、8~12、12~16、16~20,其中后三箱样本极少,WOE估计方差极大,IV虚高。改用等频分箱后,每箱约2万样本,WOE更稳定,但切点可能落在4.3、7.8这种业务上不好解释的位置。此时可再用卡方分箱合并相邻且类别分布相似的区间,最终得到0、1、2、3~5、6+这样的业务友好分箱。
常见误区有三个:
- 盲目追求IV最大:IV高不代表分箱合理,过细分箱会导致过拟合,上线后PSI剧烈波动。
- 忽略单调性:很多风控模型要求WOE随变量取值单调,卡方和决策树分箱都可能产生非单调区间,需要后续约束。
- 用训练集切点直接套测试集:等频和决策树分箱的切点依赖样本分布,必须保存切点并在新样本上做映射,否则会引入数据泄露。
总结来看,等宽分箱适合快速探索和规则明确的变量;等频分箱适合样本量大且分布偏斜的场景;卡方分箱是信用评分中最常用的自动分箱方法;决策树分箱则适合作为补充手段捕捉复杂关系。理解它们的优缺点与适用边界,才能在后续WOE与IV最优分箱及单调性约束中做出正确选择。