1. 课程导入
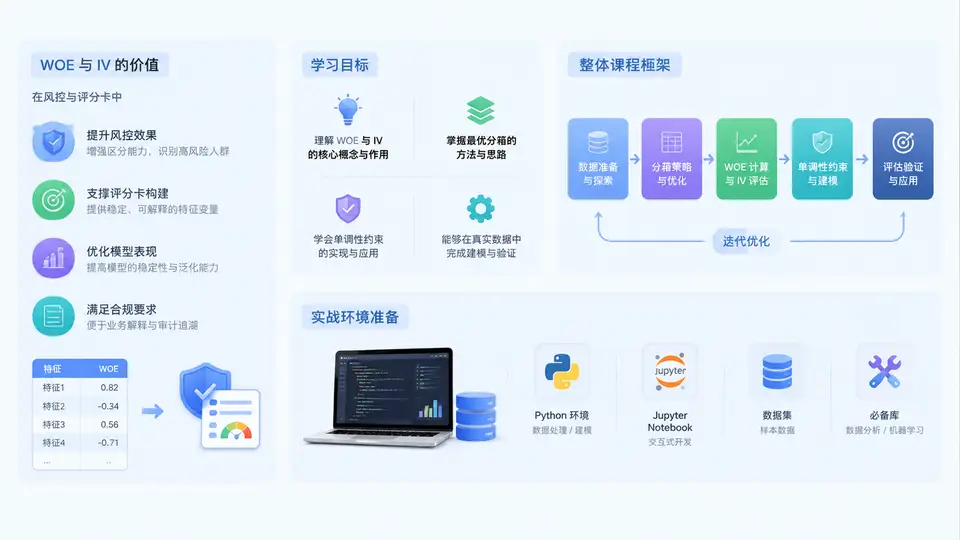
在信贷风控、消费金融、反欺诈与客户分层等场景中,评分卡模型是决策引擎的核心组件。无论是申请评分卡(A卡)、行为评分卡(B卡)还是催收评分卡(C卡),都离不开一个基础而关键的环节:将原始变量转化为具有业务解释力的风险刻度。WOE(Weight of Evidence,证据权重)与IV(Information Value,信息值)正是完成这一转化的经典工具。
很多初学者会问:既然有逻辑回归、XGBoost等模型,为什么还要手工做WOE分箱?原因在于,评分卡不仅要“准”,还要“稳”和“可解释”。监管要求、业务方沟通、策略迭代都依赖清晰的变量分段与风险排序。WOE把连续变量或复杂类别变量映射为单调的风险分值,IV则量化每个变量对目标变量的区分能力。二者配合,能在模型性能与可解释性之间取得平衡。
核心价值一句话总结:WOE负责“把变量变成风险刻度”,IV负责“判断这个刻度值不值得用”,最优分箱负责“让刻度既准又稳”,单调性约束负责“让刻度符合业务常识”。
学习目标
完成本章及后续实战后,你应当能够:
- 理解WOE与IV的数学定义、业务含义及在评分卡中的位置;
- 掌握最优分箱的常用算法(卡方分箱、决策树分箱、等频/等距分箱)及其适用边界;
- 能够对分箱结果施加单调性约束,并解释为什么单调性对风控模型至关重要;
- 使用Python完成从数据准备、分箱、WOE转换、IV筛选到逻辑回归评分卡的全流程;
- 识别并规避WOE分箱中的常见陷阱,如过拟合、IV虚高、缺失值处理不当等。
整体课程框架
本课程共30章,按照“原理—工具—实战—复盘”的脉络展开。前几章建立WOE/IV与分箱的理论基础;中间章节深入最优分箱算法与单调性约束的实现细节;后段以真实风控数据集为主线,完成评分卡开发、验证与部署。每章都配有可运行的代码片段与业务解释,避免只讲公式不讲落地。
| 阶段 | 章节范围 | 核心内容 | 产出 |
|---|---|---|---|
| 基础篇 | 第1-6章 | WOE/IV定义、评分卡逻辑、分箱概念、环境准备 | 理解风险刻度与区分度指标 |
| 算法篇 | 第7-14章 | 卡方分箱、决策树分箱、最优分箱、单调性约束 | 可复用的分箱函数 |
| 实战篇 | 第15-24章 | 数据清洗、变量筛选、WOE转换、逻辑回归建模 | 完整评分卡模型 |
| 进阶篇 | 第25-30章 | 模型评估、稳定性监控、拒绝推断、部署要点 | 可上线的评分卡方案 |
核心原理速览:WOE与IV到底在算什么
假设我们有一个二分类目标变量,例如“是否违约”(1=违约,0=正常)。对某个变量进行分箱后,每个箱内可以统计违约与正常的数量。WOE的定义为:
WOE_i = ln( (Bad_i / Bad_total) / (Good_i / Good_total) )
      = ln( 坏样本占比 / 好样本占比 )
WOE的符号和大小直接反映该箱的风险方向:WOE为正且越大,说明该箱坏样本占比越高,风险越大;WOE为负则相反。IV则是各箱WOE的加权和:
IV = Σ ( (Bad_i / Bad_total) - (Good_i / Good_total) ) * WOE_iIV越大,变量对好坏样本的区分能力越强。经验上:IV<0.02预测力极弱;0.02~0.1较弱;0.1~0.3中等;0.3~0.5较强;>0.5则需警惕过拟合或信息泄露。
提示:WOE和IV都依赖分箱结果。同一变量在不同分箱方案下,IV可能差异很大。因此“最优分箱”不是可选项,而是决定变量能否进入模型的关键步骤。
案例场景:一个变量如何从原始值变成风险刻度
以“近6个月逾期次数”为例,原始取值0~10。直接放入逻辑回归会假设每增加一次逾期,风险线性增加,但实际业务中往往不是这样:0次和1次差异巨大,5次和6次差异可能很小。通过分箱,我们可以将其划分为[0]、[1]、[2,3]、[4+]四段,分别计算WOE:
分箱        坏样本数  好样本数   WOE      IV贡献
[0]          50       950       -1.82    0.152
[1]          80       420       -0.35    0.012
[2,3]        120      180        0.69    0.041
[4+]         150      50         1.95    0.118
合计         400      1600       —       0.323
可以看到,IV合计约0.323,属于“较强”区间。WOE从负到正单调递增,符合“逾期越多风险越高”的业务常识。这样的变量进入逻辑回归后,系数解释清晰,评分卡刻度也容易向业务方说明。
实战环境准备
本课程使用Python 3.9+,核心依赖如下。建议使用虚拟环境,避免版本冲突。
python -m venv venv
source venv/bin/activate        # Windows: venv\Scripts\activate

pip install numpy pandas scikit-learn matplotlib
pip install optbinning          # 最优分箱与单调性约束
pip install scorecardpy         # 评分卡常用工具
pip install jupyterlab          # 交互式实战
数据方面,课程使用一份模拟信贷申请数据,包含客户基本信息、征信变量、历史逾期记录与违约标签。你可以在后续章节中跟随代码逐步加载、清洗和建模。建议提前确认环境可运行以下最小检查:
import pandas as pd
import numpy as np
from optbinning import OptimalBinning

print(pd.__version__)
print(np.__version__)
print("环境就绪")注意:WOE转换必须在训练集上计算,再应用到验证集和测试集。如果全量数据一起分箱,会造成信息泄露,导致IV虚高、模型上线后表现大幅下降。这是新手最常见的错误之一。
常见误区与复盘
- 误区一:IV越高越好。IV过高(如>0.5)往往意味着变量与目标高度相关,可能是泄露变量或分箱过细导致过拟合,需要结合业务判断。
- 误区二:分箱越细越好。箱数过多会让每个箱样本量不足,WOE波动大,模型不稳定。通常单变量分箱控制在3~8箱。
- 误区三:忽略单调性。如果WOE随分箱顺序上下跳动,业务方无法理解,模型也可能学到噪声。单调性约束是评分卡可解释性的底线。
- 误区四:缺失值单独一箱却不解释。缺失值本身可能携带信息,但必须确认缺失机制,避免把“没有记录”误判为“低风险”。
本章作为课程导入,已经建立了WOE/IV的价值认知、学习目标、课程框架与实战环境。接下来你将进入具体算法与代码实现,逐步把上述概念转化为可运行的评分卡工具链。