3. 数据基础与标签定义
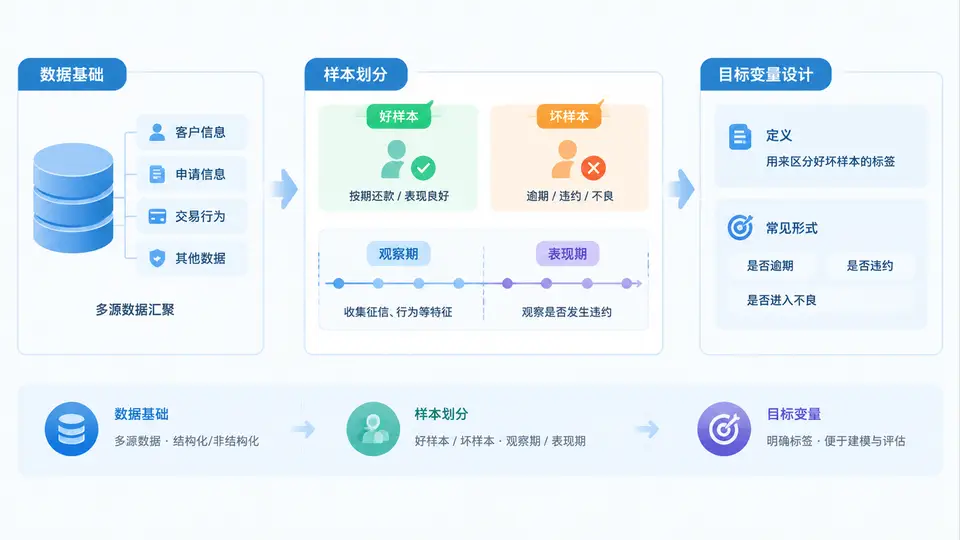
申请评分A卡的本质,是用客户在申请时点可获得的信息,预测其在未来一段时间内发生违约的概率。因此,建模的第一步不是选算法,而是把“谁是坏人、看多久、怎么标记”这三件事定义清楚。标签定义一旦偏差,后续特征工程、模型训练和阈值设计都会系统性失真。
一、核心原理:三个时间窗口的切分
申请评分卡的数据基础建立在三个关键时间概念上:观察期、表现期和申请时点。观察期用于采集申请人的历史特征(如征信查询次数、历史逾期记录、收入负债比);申请时点是模型实际打分的时刻;表现期则是从放款后开始,观察客户是否发生坏行为的时间窗口。
举例来说,若某客户2023年6月1日申请贷款,观察期可设为2022年6月1日至2023年5月31日,表现期设为放款后6个月即2023年6月1日至2023年11月30日。只有在这两个窗口都完整、且客户在表现期内有明确结果(正常还款或逾期)时,该样本才可进入建模数据集。
二、好坏样本定义:从业务语言到可计算标签
“好”与“坏”不是道德判断,而是可量化、可复现的风险事件定义。常见定义方式如下:
| 样本类型 | 常见定义 | 说明 |
|---|---|---|
| 坏样本(Bad) | 表现期内逾期天数≥30天(M1+) | 最常用,兼顾风险敏感性与样本量 |
| 坏样本(Bad) | 表现期内逾期天数≥60天或90天(M2+/M3+) | 更严格,适合低风险产品 |
| 好样本(Good) | 表现期内无逾期或逾期<30天 | 需排除“灰样本” |
| 灰样本(Gray) | 表现期内逾期1~29天,或数据不完整 | 通常剔除,不参与建模 |
定义坏样本时需注意:逾期天数应明确是“连续逾期”还是“累计逾期”,是“当前逾期”还是“历史曾逾期”。不同口径会导致坏样本率差异巨大。例如某消费金融产品,若按M1+定义坏样本率约8%,按M3+则降至3%左右,模型区分度和通过率策略都会随之改变。
三、观察期与表现期:长度选择与样本完整性
观察期长度决定了可用特征的丰富程度。观察期太短,历史行为信息不足,模型区分能力弱;观察期太长,会引入过时信息,且样本量减少。一般建议观察期至少6个月,常用12~24个月。
表现期长度则需平衡“风险充分暴露”与“样本可用性”。表现期太短,部分坏客户尚未逾期,会被误标为好样本;表现期太长,近期申请客户无法纳入建模,模型更新滞后。常见表现期为6~12个月,高风险产品可延长至12~18个月。
# 样本窗口切分示例(伪代码)
申请时点 = 2023-06-01
观察期 = [2022-06-01, 2023-05-31]   # 12个月
表现期 = [2023-06-01, 2023-11-30]   # 6个月

if 客户在表现期内最大逾期天数 >= 30:
    标签 = 1  # 坏样本
elif 客户在表现期内最大逾期天数 == 0:
    标签 = 0  # 好样本
else:
标签 = -1 # 灰样本,剔除需要特别警惕样本穿越:若表现期尚未结束就提取标签,会把“未来可能变坏”的客户误判为好样本,导致模型低估风险。正确做法是只使用表现期已完整结束的客户,或对未成熟样本进行加权/剔除。
四、目标变量设计与常见误区复盘
目标变量通常为二分类变量:1表示坏,0表示好。但在实际建模中,还需考虑以下设计细节:
- 样本权重:若好坏样本比例失衡(如1:20),可通过加权或重采样调整,但需在验证集上保持原始分布。
- 时间外验证:不能随机划分训练集和测试集,应按申请时点做时间外切分,模拟真实上线场景。
- 标签成熟度:对表现期未满的样本,可采用生存分析或部分标注方法,但需谨慎解释。
复盘一个真实场景:某现金贷产品最初将坏样本定义为“逾期≥1天”,结果坏样本率高达25%,模型虽然区分度高,但审批通过率极低,业务无法接受。后调整为“逾期≥30天”,坏样本率降至7%,模型KS从0.42降至0.35,但通过率提升至合理区间,最终上线效果更优。这说明标签定义不是越严格越好,而是要与业务目标匹配。
总之,数据基础与标签定义是申请评分A卡的地基。好坏样本定义要清晰可执行,观察期与表现期要完整且无穿越,目标变量要稳定可复现。只有这三者对齐,后续的变量筛选、模型训练和阈值设计才有意义。