1. 课程导入
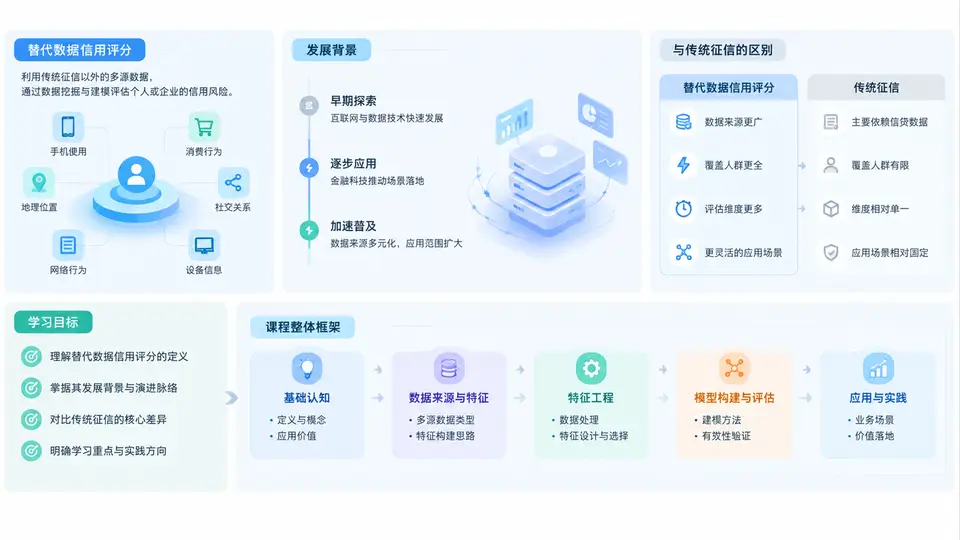
1.1 什么是替代数据信用评分
替代数据信用评分(Alternative Data Credit Scoring)是指在不依赖或仅部分依赖传统征信数据的前提下,利用非传统数据源构建信用风险模型,对个人或小微企业的还款意愿与还款能力进行量化评估的方法体系。这里的“替代数据”并非“次等数据”,而是相对于央行征信、银行信贷记录等传统金融数据而言的另一类信息资产。
常见的替代数据包括:
- 通信与设备数据:手机账单缴费记录、入网时长、设备型号、APP使用行为;
- 交易与支付数据:电商平台订单、移动支付流水、收单结算记录;
- 社交与行为数据:社交关系稳定性、履约类行为(如共享单车、租赁归还);
- 公共与政务数据:水电燃气缴费、社保公积金、税务、工商登记、司法涉诉;
- 位置与轨迹数据:居住稳定性、工作地通勤规律等(需严格合规授权)。
替代数据信用评分的核心目标,是把这些“弱金融信号”转化为可解释、可验证、可入模的信用特征,从而覆盖传统征信无法覆盖的人群,例如信用白户、灵活就业者、小微商户和县域农村用户。
1.2 发展背景:为什么替代数据信用评分成为刚需
替代数据信用评分的兴起,是技术、市场与政策三股力量共同作用的结果。
- 普惠金融的覆盖缺口:全球仍有大量成年人没有银行账户或信贷记录,传统征信模型对“无记录人群”天然失效,形成“信用白户悖论”——越没有记录越难获得信贷,越难获得信贷越没有记录。
- 数字基础设施成熟:移动支付、电商、政务数字化沉淀了海量行为数据,为特征工程提供了原材料;云计算与机器学习框架降低了建模门槛。
- 政策与监管推动:多国推动替代数据在征信体系中的合规应用,强调数据授权、最小必要、可解释与消费者权益保护。
- 业务价值驱动:在风险可控前提下提升审批通过率、降低获客成本、缩短授信时效,成为金融机构差异化竞争的关键能力。
核心逻辑:传统征信回答“你过去借过钱吗、还得怎么样”;替代数据信用评分回答“你在没有信贷记录时,是否表现出稳定、可预期、可验证的履约行为”。前者是金融履约史,后者是行为稳定性与责任感的代理信号。
1.3 与传统征信的区别:数据、模型与治理的全面对比
理解替代数据信用评分,必须把它放在与传统征信的对照中。二者不是简单替代关系,而是互补关系。下表从六个维度进行对比:
| 对比维度 | 传统征信评分 | 替代数据信用评分 |
|---|---|---|
| 数据来源 | 银行信贷、信用卡、担保、公共记录 | 通信、支付、电商、政务、设备、行为等 |
| 覆盖人群 | 有信贷记录人群 | 信用白户、小微、灵活就业、农村用户 |
| 数据频率 | 月度/事件驱动,更新慢 | 实时/高频,可动态更新 |
| 特征形态 | 结构化、金融语义明确 | 多源异构、需深度特征工程 |
| 模型方法 | 逻辑回归、评分卡为主 | 树模型、深度学习、图模型等 |
| 合规重点 | 征信业法规、数据准确性 | 授权同意、最小必要、可解释、防歧视 |
常见误区:认为替代数据“越多越好”。实际上,未经授权、与违约无因果、稳定性差或存在歧视风险的数据,不仅不能提升模型效果,还会带来合规与声誉风险。替代数据信用评分的第一原则是合规先行、有效性验证随后。
1.4 核心原理:从弱信号到信用证据的转化链路
替代数据信用评分的本质,是一条“原始数据 → 特征 → 证据 → 评分”的转化链路。其核心原理可以概括为三点:
- 代理假设:某些非金融行为与还款意愿/能力存在统计相关性,例如稳定缴费反映责任感,稳定居住反映生活稳定性。
- 特征工程放大信号:原始字段往往噪声大、粒度细,需要通过聚合、趋势、比率、时间窗口等变换,提取稳定且有区分度的特征。
- 有效性验证闭环:任何替代特征都必须经过区分度、稳定性、可解释性与合规性验证,才能进入生产模型。
一个典型的特征工程与验证流程如下:
原始数据接入 → 数据清洗与对齐 → 特征构造 → 特征筛选
→ 模型训练 → 区分度评估(KS/AUC) → 稳定性评估(PSI)
→ 可解释性分析(SHAP/IV) → 合规审查 → 上线监控与迭代
在这个过程中,特征工程决定了模型的上限,而有效性验证决定了模型能否真正落地。二者缺一不可。
1.5 案例场景:一个县域小微商户的信用评分
假设某县域银行需要为没有信贷记录的小微商户提供经营贷款。传统征信无法给出评分,但可以获取以下替代数据:
- 收单流水:近6个月日均交易额、交易笔数、周末/工作日比例;
- 缴费记录:电费、水费、房租缴纳的及时性与连续性;
- 设备与位置:经营场所GPS稳定性、设备活跃时段;
- 政务数据:工商注册年限、税务申报连续性。
通过特征工程,可以构造“经营稳定性指数”“履约及时率”“现金流波动率”等特征,再结合轻量级模型输出信用评分。该评分不追求替代央行征信,而是作为传统征信的补充,帮助银行在风险可控的前提下实现“首贷户”覆盖。
教学提示:在后续章节中,我们会反复回到这个案例,逐步演示如何从原始字段构造特征、如何验证特征有效性、如何避免常见陷阱。
1.6 学习目标与整体课程框架
本课程共30章,围绕“特征工程”与“有效性验证”两条主线展开。学完本课程,您应当能够:
- 理解替代数据信用评分的定义、边界与合规要求;
- 掌握替代数据特征工程的全流程方法,包括数据清洗、特征构造、特征筛选与编码;
- 能够针对通信、支付、政务等典型数据源设计有效特征;
- 掌握区分度、稳定性、可解释性与合规性四类有效性验证方法;
- 能够识别并规避替代数据建模中的常见误区,如数据泄露、样本偏差、歧视性特征;
- 具备将替代数据评分模型从实验推向生产的基本工程能力。
整体课程框架分为四个模块:
- 基础篇:定义、背景、合规与数据源概览;
- 特征工程篇:清洗、构造、筛选、编码与典型场景实战;
- 有效性验证篇:区分度、稳定性、可解释性与合规验证;
- 工程与复盘篇:上线监控、迭代优化与案例复盘。
学习建议:替代数据信用评分是“数据 + 业务 + 合规”的交叉领域。建议在学习过程中,始终带着三个问题:这个特征有业务含义吗?它合规吗?它真的能区分风险吗?