3. 概率校准入门
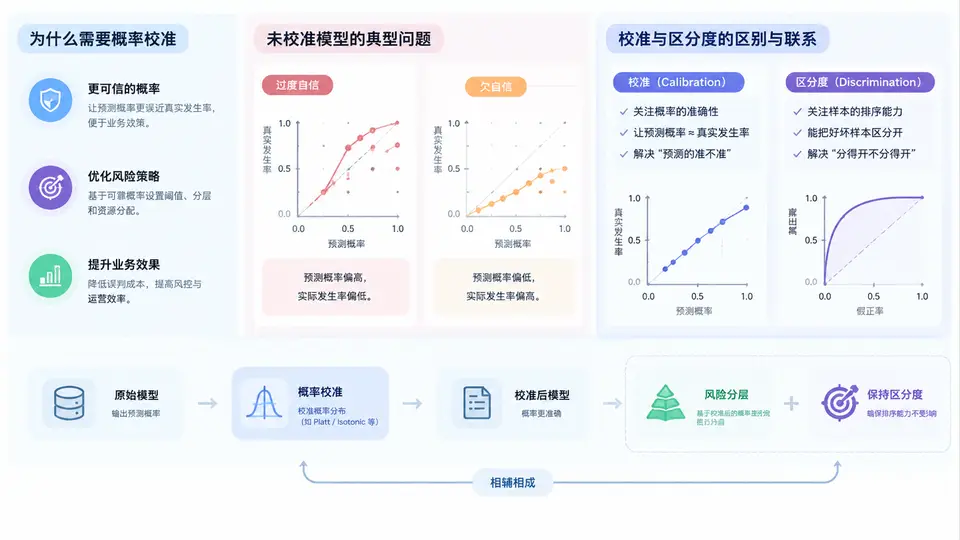
在信用评分项目中,很多团队把大量精力投入到提升AUC、KS等排序指标上,却忽略了一个更贴近业务决策的问题:模型输出的分数,究竟能不能当作“真实概率”来使用?如果一个客户被模型打出0.8的违约概率,我们是否真的可以理解为“这类客户大约有80%会违约”?这正是概率校准要解决的核心问题。
一、核心原理:校准在解决什么
概率校准的目标,是让模型输出的预测概率与真实观测频率保持一致。用形式化语言说,对于一个校准良好的模型,在所有预测概率约为 p 的样本中,真实正例比例应当接近 p。例如,把所有预测违约概率在0.10附近的客户聚在一起,如果其中约10%真的违约,那么这个区间的预测就是校准的。
需要强调的是,校准不改变样本之间的排序,它改变的是分数的“绝对含义”。逻辑回归、经过良好正则化的线性模型通常天然具有较好的校准性;而梯度提升树、随机森林、神经网络、支持向量机等模型,往往排序能力强但概率输出偏乐观或偏保守。原因在于:树模型在叶子节点上给出的是训练样本的统计量,容易受样本分布、类别不平衡和过拟合影响;神经网络则常因损失函数、正则化和训练轮次导致输出被压缩或拉伸。
一句话理解:区分度回答“谁更可能违约”,校准回答“到底有多可能违约”。前者决定排序,后者决定定价、拨备和额度。
二、未校准模型的典型问题
未校准模型在信用风控中会引发一系列连锁问题。下面列出最常见的几类表现:
- 概率整体偏高或偏低:模型预测平均违约率为8%,但实际样本违约率只有3%。这会导致审批过严、额度压低,或反之过度放贷。
- 尾部区间严重失真:高分险区间预测0.6,实际违约率可能只有0.35;低风险区间预测0.02,实际却接近0.08。尾部恰恰是定价和拨备最敏感的区间。
- 跨客群不可比:新客模型与老客模型各自输出0.2,但两个0.2背后的真实风险完全不同,无法直接合并使用。
- 阈值决策失效:业务规则写“预测概率大于0.15拒绝”,若模型未校准,这个阈值对应的真实违约率可能远高于或远低于预期。
- 经济资本与拨备偏差:PD被高估会占用过多资本,被低估则导致拨备不足,二者都会直接冲击利润与合规。
很多团队误以为“AUC高就万事大吉”。实际上,AUC只衡量排序能力,对概率的绝对大小完全不敏感。一个AUC=0.85但严重高估的模型,在定价场景中可能比AUC=0.78但校准良好的模型更危险。
三、校准与区分度的区别与联系
区分度与校准是两个正交但互补的维度。区分度描述模型把好坏样本分开的能力,常用AUC、KS、Gini;校准描述预测概率与真实频率的吻合程度,常用校准曲线、Brier分数、ECE。一个模型可以区分度很高但校准很差,也可以校准很好但区分度一般,理想状态是两者兼优。
| 维度 | 关注问题 | 常用指标 | 是否受样本不平衡影响 | 典型改进手段 |
|---|---|---|---|---|
| 区分度 | 谁更可能违约 | AUC、KS、Gini | 相对稳健 | 特征工程、模型调参、集成 |
| 校准 | 概率是否等于真实频率 | 校准曲线、Brier、ECE | 非常敏感 | Platt、Isotonic、Beta校准 |
两者的联系在于:校准通常建立在已有排序能力之上。如果模型完全没有区分度,校准也失去意义,因为所有样本的真实违约率都接近基准率。反过来,校准不会提升AUC,但能让AUC所代表的排序信息在业务上“可用”。因此,正确的流程是先保证区分度,再对概率进行校准,最后用于定价、额度和拨备。
四、方法流程与案例场景
一个可落地的校准流程通常包含以下步骤:
- 在训练集上训练基础模型,得到原始分数或概率。
- 划分独立的校准集,避免在校准集上过拟合。
- 选择校准方法:样本量充足时优先Isotonic回归,样本较少时用Platt缩放或Beta校准。
- 绘制校准曲线,计算Brier分数与ECE,评估校准前后差异。
- 在时间外样本上验证校准稳定性,必要时按客群、产品线分别校准。
下面是一段使用Python进行Platt缩放与校准曲线评估的示例代码:
from sklearn.calibration import CalibratedClassifierCV, calibration_curve
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.metrics import brier_score_loss
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, stratify=y)

base = GradientBoostingClassifier(n_estimators=200, max_depth=3)
base.fit(X_train, y_train)

# 使用sigmoid(Platt)校准
calibrated = CalibratedClassifierCV(base, method='sigmoid', cv=5)
calibrated.fit(X_train, y_train)

prob_raw = base.predict_proba(X_test)[:, 1]
prob_cal = calibrated.predict_proba(X_test)[:, 1]

print("Brier raw:", brier_score_loss(y_test, prob_raw))
print("Brier calibrated:", brier_score_loss(y_test, prob_cal))

fop_raw, mpv_raw = calibration_curve(y_test, prob_raw, n_bins=10)
fop_cal, mpv_cal = calibration_curve(y_test, prob_cal, n_bins=10)
print("raw curve:", list(zip(mpv_raw, fop_raw)))
print("calibrated curve:", list(zip(mpv_cal, fop_cal)))
假设某消费金融公司使用梯度提升树预测首逾概率。模型AUC为0.82,但校准曲线显示:预测概率在0.20~0.30区间的客户,实际违约率只有0.12。业务按0.25作为拒绝阈值,导致大量本可正常放款的客户被拒。经过Isotonic校准后,该区间预测概率调整为0.13,阈值决策与真实风险重新对齐,通过率提升约6个百分点,同时坏账率保持稳定。这个案例说明,校准不是学术装饰,而是直接影响通过率与风险成本的工程环节。
五、误区与复盘
- 误区一:校准能提升AUC。校准是单调变换,理论上不改变排序,AUC基本不变。它的价值在于概率语义,而非排序能力。
- 误区二:在校准集上评估校准效果。这会导致过于乐观的结论,必须使用独立的时间外样本或交叉验证。
- 误区三:全客群统一校准。不同客群、渠道、产品线的基准违约率差异很大,统一校准可能掩盖局部失真,建议分层校准。
- 误区四:忽略样本不平衡。违约样本极少时,Isotonic容易过拟合,应优先考虑Platt或Beta校准,并配合重采样策略。
- 误区五:校准一次就永久使用。客群结构、宏观环境和政策变化都会导致校准漂移,需要定期监控ECE与校准曲线。
复盘建议:在模型上线前,把“校准曲线是否贴近对角线”“Brier分数是否优于基准率模型”“关键阈值区间的真实违约率是否与预测一致”作为三道必检关卡。只有区分度与校准同时达标,模型才真正具备业务可用性。
概率校准的本质,是让模型从“会排序”走向“会说话”。在信用评分场景中,排序决定谁先被看见,校准决定我们愿意为这个判断付出多少成本。理解二者的区别与联系,是构建可信风险决策体系的第一步。