1. 课程导入
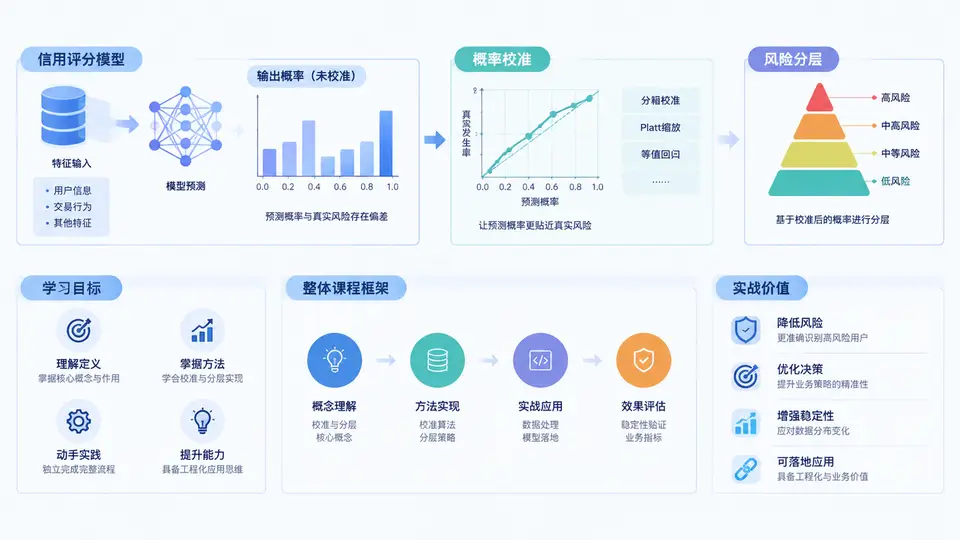
一、为什么“分数”不等于“概率”:从一个真实业务场景说起
在信贷风控中,我们经常看到这样的场景:模型给客户A打出620分,给客户B打出580分,业务方问“这两个人的违约概率分别是多少?”很多建模同学会回答“620分对应好客户,580分对应差客户”,但无法给出一个可解释、可复核的概率值。更严重的是,当模型分数被直接当作概率用于定价、拨备或资本计量时,若校准失准,可能导致风险被系统性低估或高估。
信用评分模型通常输出的是排序能力(谁比谁更可能违约),而不是绝对概率。概率校准要解决的问题是:把模型输出的分数或原始概率,映射到真实世界可解释的违约概率上。风险分层则是在校准后的概率基础上,按照业务风险偏好和监管要求,把客户划分为不同风险等级,并匹配差异化的授信、定价和监控策略。
核心定义:概率校准(Probability Calibration)是指调整模型输出的预测概率,使其与真实观测到的违约频率一致的过程。风险分层(Risk Stratification)是指基于校准后的概率或评分,将客户划分为若干风险等级,并制定差异化策略的过程。
二、学习目标:学完本课程你能做什么
本课程不是单纯讲算法推导,而是围绕“可落地、可验证、可解释”三个关键词展开。完成30章学习后,你应当能够:
- 理解原理:掌握概率校准的数学本质、常见校准方法(Platt Scaling、Isotonic Regression、Beta Calibration等)的适用条件与优缺点。
- 动手实现:使用Python和主流风控工具链,完成从原始分数到校准概率的完整流程,并输出校准诊断报告。
- 设计分层:结合业务目标、监管要求和样本分布,设计合理的风险分层方案,避免“分层过粗”或“分层过细”。
- 评估效果:使用校准曲线、Brier Score、Log Loss、KS、AUC等指标,综合评估校准与分层效果。
- 复盘误区:识别并规避“用AUC代替校准”“校准集与验证集混用”“分层边界拍脑袋”等常见错误。
三、整体课程框架:从原理到实战的30章地图
课程分为五个模块,层层递进:
| 模块 | 章节范围 | 核心内容 | 实战产出 |
|---|---|---|---|
| 导入与基础 | 第1-4章 | 定义、业务价值、评分卡与概率关系、校准评估指标 | 校准评估指标清单 |
| 校准方法 | 第5-12章 | Platt、Isotonic、Beta、温度缩放、贝叶斯校准 | 多方法对比实验报告 |
| 风险分层 | 第13-20章 | 分层策略、边界优化、单调性约束、监管映射 | 风险分层方案与策略表 |
| 工程落地 | 第21-26章 | 样本切分、时间外验证、监控告警、模型迭代 | 校准监控看板设计 |
| 综合实战 | 第27-30章 | 完整项目复盘、代码工程化、面试与答辩 | 端到端项目代码与报告 |
可以看到,课程从“为什么需要校准”出发,逐步深入到“怎么做校准”“怎么分层”“怎么上线监控”,最后以完整项目收尾。每一章都配有可运行的代码片段和业务案例,避免纸上谈兵。
四、核心原理:校准与分层的关系
概率校准和风险分层不是两个独立任务,而是前后衔接的。校准解决“概率准不准”,分层解决“概率怎么用”。如果校准失准,分层边界再精细也会失去意义;如果分层不合理,校准再准也无法转化为业务决策。
一个典型的校准流程如下:
原始模型输出 → 分数/概率 → 校准映射 → 校准后概率 → 风险分层 → 策略执行
                ↑                ↑
            训练集/校准集      业务规则/监管要求
其中,校准集必须与训练集分离,否则会过拟合。风险分层则需要考虑业务可解释性,例如“低风险”“中风险”“高风险”“极高风险”四档,每档对应不同的额度、利率和人工复核比例。
五、案例/场景:某消费金融公司的校准与分层实践
某消费金融公司原有评分卡AUC为0.78,排序能力不错,但业务方发现:模型预测违约概率为5%的客户,实际违约率却达到9%。这导致定价偏低、拨备不足。后来团队引入Isotonic Regression进行校准,校准后Brier Score从0.18降至0.12,预测概率与实际违约率偏差控制在1%以内。在此基础上,团队将客户分为五档:
- 极低风险:校准概率<1%,自动审批,利率下浮10%。
- 低风险:1%-3%,自动审批,标准利率。
- 中风险:3%-8%,人工复核,利率上浮5%。
- 高风险:8%-15%,人工复核+担保,利率上浮15%。
- 极高风险:>15%,拒绝或仅邀请制。
上线后,公司不良率下降1.2个百分点,同时审批通过率提升3%,实现了风险与收益的平衡。这个案例说明:校准让概率可信,分层让策略可执行。
六、误区与复盘:新手最容易踩的五个坑
误区1:用AUC代替校准评估。AUC只衡量排序能力,不衡量概率准确性。AUC高不代表概率准。
误区2:校准集与训练集混用。会导致校准结果过于乐观,上线后失效。
误区3:分层边界拍脑袋。不结合样本分布和业务成本,导致某些层级样本过少或过多。
误区4:忽略时间外验证。校准模型在时间外样本上可能表现差异很大,必须做跨时间验证。
误区5:只做一次校准。模型上线后,客群和宏观经济会变化,校准需要定期监控和迭代。
复盘这些误区,核心原则是:校准要独立验证,分层要业务驱动,监控要持续进行。本课程后续章节会逐一展开这些原则的落地方法。
七、实战价值:为什么这门课值得学
概率校准与风险分层是信用评分模型从“实验室”走向“生产环境”的关键一步。它直接关系到:
- 定价准确性:校准后的概率是风险定价的基础,偏差1%可能导致数百万利润损失。
- 资本计量:监管要求银行使用校准后的违约概率计算预期损失和经济资本。
- 策略差异化:分层让不同风险客户匹配不同策略,提升通过率和降低不良率。
- 模型可解释性:校准后的概率更容易被业务和监管理解,减少沟通成本。
无论你是数据科学家、风控策略师还是模型验证人员,掌握这套方法都能让你在职业发展中更具竞争力。接下来的29章,我们将从评估指标开始,一步步带你完成从理论到实战的完整闭环。