1. 课程导入
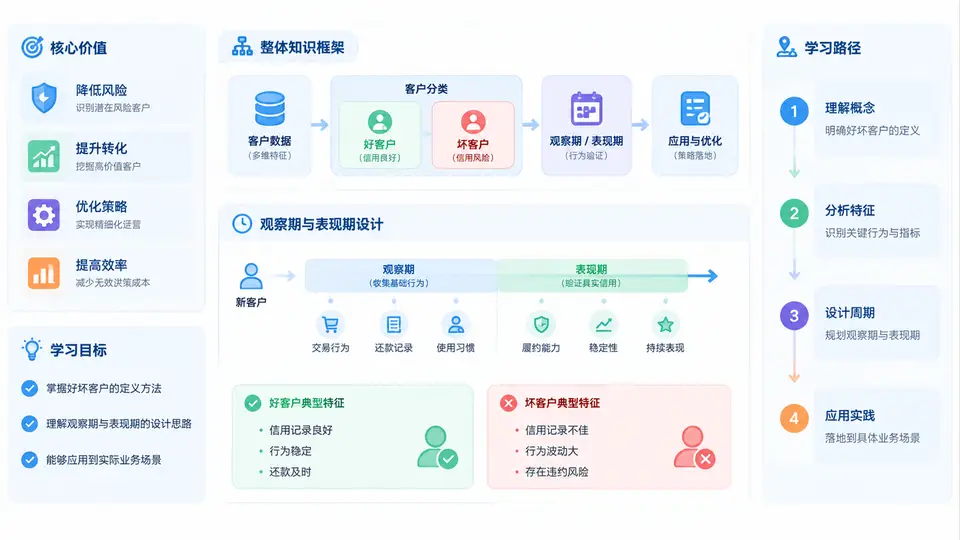
在信用评分建模项目中,很多团队把大量精力投入到算法选择、特征工程和调参上,却忽略了一个更前置、更致命的问题:谁是“坏客户”?从哪一天开始算?观察多久?表现多久?如果这个定义错了,模型再先进也只是在精确地拟合一个错误的目标。本章作为全课程的导入,将帮助你建立对好坏客户定义与观察期、表现期设计的整体认知框架。
一、为什么说“定义”比“算法”更重要
信用评分的本质,是把历史数据中“违约行为”的规律提炼成对未来风险的预测能力。这里存在一个隐含的因果链:业务目标 → 风险定义 → 样本标签 → 模型目标 → 评分应用。好坏客户定义和观察期、表现期设计,正是这条链上最上游的两个环节。
它们决定了三件事:第一,模型究竟在预测什么;第二,训练样本中正负例的比例与质量;第三,模型上线后的实际区分能力和稳定性。一个常见的真实场景是:某消费金融公司把“逾期1天”定义为坏客户,结果模型把大量只是忘记还款的优质客户也判为高风险,导致通过率骤降、业务萎缩。问题不在模型,而在定义。
二、核心概念:观察期、表现期与好坏定义
在信用风险建模中,通常把客户的时间轴切分为三个窗口:
- 观察期(Observation Period):用于提取客户特征的时间窗口,例如申请前6个月的还款记录、消费行为、查询次数等。
- 表现期(Performance Period):用于观察客户是否发生坏行为的时间窗口,例如放款后12个月内是否出现逾期90天以上。
- 好坏定义(Good/Bad Definition):在表现期内,根据逾期天数、逾期次数、金额等指标,把客户划分为好、坏、灰三类。
三者关系可以用一个简单的时间轴理解:观察期看“过去”,表现期看“未来”,好坏定义则是“未来”中判定结果的规则。下面这张图展示了标准的时间窗口切分逻辑。
三、方法流程:从业务目标到样本标签
一个规范的好坏客户定义与窗口设计流程,通常包含以下步骤:
- 明确业务目标:是控制坏账率、提升通过率,还是优化额度策略?不同目标对应不同的坏定义。
- 确定表现期长度:根据产品期限、风险暴露周期和业务容忍度,选择6、12、18或24个月。
- 确定观察期长度:保证特征有足够信息量,同时避免过长导致样本陈旧。
- 定义坏客户规则:常用规则包括逾期天数(DPD)、逾期次数、金额比例等。
- 划分灰客户:对介于好坏之间的客户单独处理,避免标签噪声。
- 验证样本分布:检查坏样本比例、时间稳定性、跨期一致性。
下面是一个典型的坏客户定义参数配置示例,供你在实际项目中参考:
bad_definition:
  dpd_threshold: 90          # 逾期90天以上定义为坏
  max_dpd_in_period: 90      # 表现期内最大逾期天数
  min_overdue_times: 1       # 至少发生一次
  gray_zone:
    dpd_min: 30
    dpd_max: 89
  observation_window: 6      # 观察期6个月
  performance_window: 12     # 表现期12个月
  sample_cutoff: "2024-06-30"
四、案例与场景:定义不同,结果天差地别
假设某银行信用卡中心要建立申请评分卡。团队A把坏客户定义为“表现期内逾期60天以上”,团队B定义为“逾期90天以上”。其他条件完全相同。结果团队A的坏样本比例约为8%,团队B约为4%。团队A的模型更敏感,但误杀率更高;团队B的模型更稳健,但对早期风险不敏感。
再考虑表现期长度。如果表现期只有6个月,很多长期风险尚未暴露,坏样本被低估;如果表现期长达36个月,虽然风险暴露充分,但样本陈旧,可能无法反映当前客群变化。因此,表现期设计本质上是在风险充分暴露与样本时效性之间做权衡。
| 设计维度 | 常见选择 | 优点 | 风险 |
|---|---|---|---|
| 坏定义DPD | 30 / 60 / 90天 | 30天敏感,90天稳健 | 30天噪声大,90天漏掉早期风险 |
| 观察期 | 3 / 6 / 12个月 | 6个月平衡信息量与时效 | 过短特征不足,过长样本陈旧 |
| 表现期 | 6 / 12 / 24个月 | 12个月覆盖多数产品周期 | 过短坏样本不足,过长样本老化 |
| 灰客户 | 30-89天单独处理 | 降低标签噪声 | 处理不当导致样本量下降 |
五、常见误区与复盘
误区二:观察期和表现期重叠,导致特征中包含未来信息,造成数据穿越。
误区三:忽略灰客户,把30-89天客户强行归为好或坏,引入标签噪声。
误区四:表现期过短,坏样本比例过低,模型无法学到有效风险模式。
复盘时,建议重点检查三件事:第一,坏样本比例是否在合理区间(通常2%-10%);第二,观察期与表现期是否严格分离;第三,定义规则是否与业务实际催收、核销口径一致。只有定义与业务口径对齐,模型结果才能被业务方信任和采纳。
当你完成本章学习后,应当能够用自己的话解释:为什么好坏客户定义是信用评分的起点;观察期与表现期分别解决什么问题;以及一个合理的定义方案需要平衡哪些业务与技术因素。这些认知将贯穿后续所有章节,成为你构建高质量信用评分模型的底层基础。