2. 追溯编码规则设计与校验
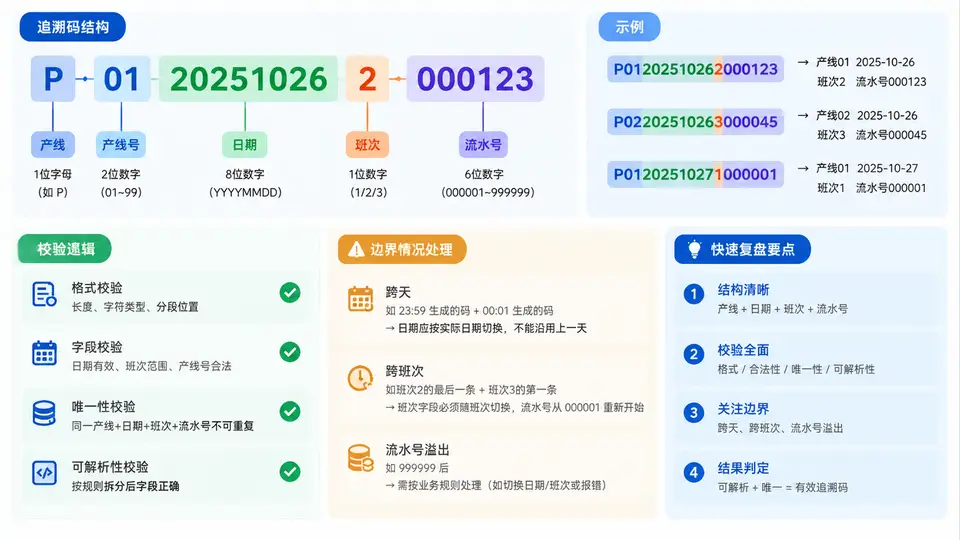
追溯码的字段结构与编码规则
本案例为一条离散装配线设计追溯码,编码需要同时满足两个条件:唯一性(同一产品不会出现重复码)和可解析性(从码本身能还原产线、日期、班次和流水号)。采用定长分段编码,避免分隔符带来的解析歧义。
| 字段 | 位数 | 取值规则 | 示例 |
|---|---|---|---|
| 产线代码 | 2 | 大写字母,L1~L9 | L3 |
| 日期 | 6 | YYMMDD,按生产日期 | 250314 |
| 班次 | 1 | 1=早班,2=中班,3=夜班 | 2 |
| 流水号 | 5 | 00001~99999,班次内递增 | 00127 |
完整追溯码为 14 位,例如 L3250314200127。流水号在每个“产线+日期+班次”组合内独立从 00001 开始,这是跨天、跨班次边界处理的核心约定。
校验逻辑实现
校验分四层:格式、日期合法性、唯一性、连续性。下面给出可直接运行的 Python 实现,包含跨天和跨班次的边界测试。
import re
from datetime import datetime, date

CODE_PATTERN = re.compile(r'^L([1-9])(\d{2})(\d{2})(\d{2})([1-3])(\d{5})$')

def parse_trace_code(code: str) -> dict:
    """解析追溯码,返回字段字典;格式非法时抛出 ValueError。"""
    m = CODE_PATTERN.match(code)
    if not m:
        raise ValueError(f"编码格式非法: {code}")
    line, yy, mm, dd, shift, seq = m.groups()
    try:
        prod_date = date(2000 + int(yy), int(mm), int(dd))
    except ValueError:
        raise ValueError(f"日期字段非法: {yy}{mm}{dd}")
    return {
        "line": f"L{line}",
        "date": prod_date.isoformat(),
        "shift": int(shift),
        "seq": int(seq),
        "unique_key": (f"L{line}", prod_date.isoformat(), int(shift), int(seq)),
    }

def validate_unique(code: str, existing_keys: set) -> bool:
    """校验唯一性:组合键是否已存在。"""
    info = parse_trace_code(code)
    return info["unique_key"] not in existing_keys

def validate_sequence(code: str, last_seq_in_shift: int) -> bool:
    """校验连续性:同一班次内流水号应为上一个+1。"""
    info = parse_trace_code(code)
    return info["seq"] == last_seq_in_shift + 1

# ---- 边界测试 ----
if __name__ == "__main__":
    # 正常码
    print(parse_trace_code("L3250314200127"))
    # 跨天:3/14 夜班最后一个码 → 3/15 早班第一个码
    print(parse_trace_code("L3250314300001"))
    # 跨班次:同一天 早班→中班,流水号重置
    print(parse_trace_code("L3250314100001"))
    print(parse_trace_code("L3250314200001"))
    # 非法格式
    try:
        parse_trace_code("L325031420012")   # 少一位
    except ValueError as e:
        print("捕获异常:", e)
    # 非法日期
    try:
        parse_trace_code("L3250230200001")  # 2月30日
    except ValueError as e:
        print("捕获异常:", e)
边界处理要点:跨天时日期字段变化,流水号在新日期内重置;跨班次时班次字段变化,流水号在新班次内重置。两者共同保证“产线+日期+班次+流水号”组合键全局唯一。若单班次产量可能超过 99999,应在设计阶段将流水号扩展为 6 位,或增加产线内子序列字段。
唯一性与可解析性验证
用一组模拟数据验证:同一班次内连续生成 5 个码,检查唯一性和连续性;再模拟跨天、跨班次场景,确认流水号正确重置。
def simulate_shift(line, prod_date, shift, count, start_seq=1):
    """模拟一个班次内生成 count 个追溯码。"""
    codes = []
    for i in range(count):
        seq = start_seq + i
        code = f"{line}{prod_date.strftime('%y%m%d')}{shift}{seq:05d}"
        codes.append(code)
    return codes

from datetime import date

# 3/14 中班,从 00127 开始生成 3 个
codes = simulate_shift("L3", date(2025,3,14), 2, 3, start_seq=127)
print(codes)  # ['L3250314200127', 'L3250314200128', 'L3250314200129']

# 跨天:3/15 早班,流水号从 00001 开始
codes_next = simulate_shift("L3", date(2025,3,15), 1, 2)
print(codes_next)  # ['L3250315100001', 'L3250315100002']

# 唯一性检查
all_keys = set()
for c in codes + codes_next:
    info = parse_trace_code(c)
    assert info["unique_key"] not in all_keys, f"重复: {c}"
    all_keys.add(info["unique_key"])
print("唯一性校验通过,共", len(all_keys), "个唯一码")
常见错误:不要用“日期+流水号”作为唯一键而忽略班次。同一天内早班和中班可能都从 00001 开始,若缺少班次字段会导致跨班次重复。另外,日期字段建议使用生产日期而非系统当前日期,避免夜班跨天时记录错误。