4. 多项式拟合与过拟合诊断
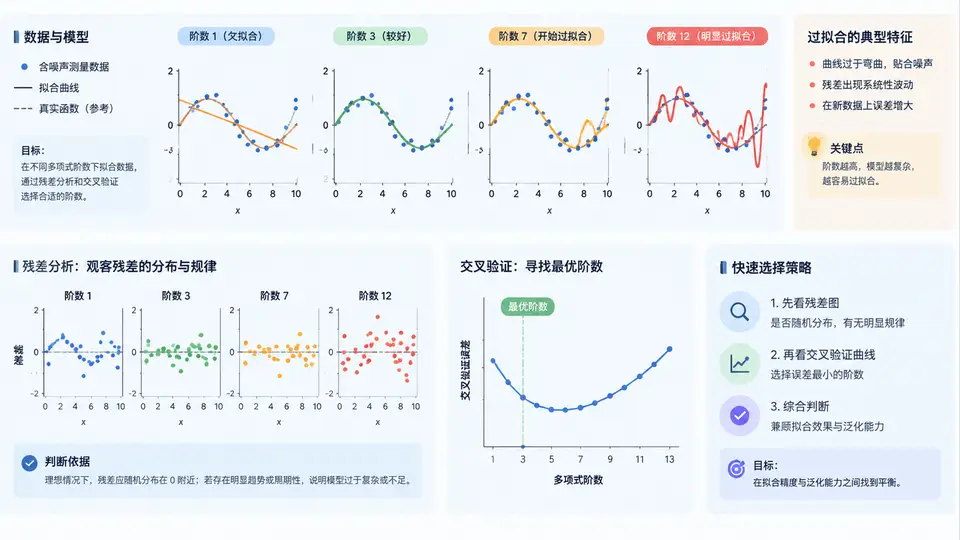
问题设定:含噪工程测量数据的多项式拟合
假设某传感器在 0~10 s 内采集了一组位移数据,真实趋势近似为三次多项式,但叠加了随机噪声。我们先用 MATLAB 构造这组教学示例数据,再通过改变拟合阶数观察过拟合现象。
rng(42);                          % 固定随机种子,保证示例可复现
x = linspace(0, 10, 25)';         % 25 个采样点
y_true = 0.5*x.^3 - 6*x.^2 + 20*x + 5;   % 真实趋势(三次)
noise = 8*randn(size(x));         % 标准差 8 的测量噪声
y = y_true + noise;               % 含噪观测值
关键点:采样点只有 25 个,噪声标准差 8 相对于信号幅度不可忽略。若用高阶多项式强行穿过每个点,训练残差会趋近于零,但对新采样点的预测会严重偏离。
阶数扫描:训练误差与验证误差的分叉
把数据按 70%/30% 划分为训练集与验证集,对 1~12 阶多项式分别拟合并记录两种误差:
n = numel(x);
idx = randperm(n);
nTrain = round(0.7*n);
iTr = idx(1:nTrain);  iVa = idx(nTrain+1:end);

degs = 1:12;
rmseTr = zeros(size(degs));
rmseVa = zeros(size(degs));

for k = 1:numel(degs)
    d = degs(k);
    p = polyfit(x(iTr), y(iTr), d);          % 训练集拟合
    rmseTr(k) = rms(y(iTr) - polyval(p, x(iTr)));
    rmseVa(k) = rms(y(iVa) - polyval(p, x(iVa)));
end

T = table(degs', rmseTr', rmseVa', ...
    'VariableNames', {'阶数','训练RMSE','验证RMSE'});
disp(T)
预期现象:低阶(1~2 阶)时训练与验证误差都较大,属于欠拟合;3~4 阶时两者都降到较低水平;5 阶以后训练误差继续下降,但验证误差开始回升——这就是过拟合的典型信号。
判断依据:当验证 RMSE 在某一阶数达到最小值后随阶数增加而上升,而训练 RMSE 仍单调下降,说明模型开始记忆噪声而非学习趋势。
残差分析:从残差结构识别过拟合
仅看误差数值还不够,残差随自变量的分布形态能提供更直接的证据。对 3 阶和 9 阶两个模型分别计算残差:
p3 = polyfit(x, y, 3);
p9 = polyfit(x, y, 9);
r3 = y - polyval(p3, x);
r9 = y - polyval(p9, x);

figure;
subplot(2,1,1); stem(x, r3, 'filled'); hold on;
yline(0,'k--'); title('3阶残差'); ylabel('残差');
subplot(2,1,2); stem(x, r9, 'filled'); hold on;
yline(0,'k--'); title('9阶残差'); ylabel('残差');
3 阶残差应表现为围绕零线的随机散布,无明显系统结构;9 阶残差虽然幅度更小,但会在相邻采样点之间出现高频正负交替,这是多项式在数据点间剧烈振荡的痕迹,也是过拟合的直观标志。
交叉验证:用 k 折结果稳定选阶
单次划分验证集受随机划分影响较大,改用 5 折交叉验证获得更稳定的阶数选择:
K = 5;
cv = cvpartition(n, 'KFold', K);
cvRMSE = zeros(numel(degs), K);

for k = 1:numel(degs)
    d = degs(k);
    for f = 1:K
        iTr = training(cv, f);
        iTe = test(cv, f);
        p = polyfit(x(iTr), y(iTr), d);
        cvRMSE(k, f) = rms(y(iTe) - polyval(p, x(iTe)));
    end
end

meanCV = mean(cvRMSE, 2);
[bestRMSE, bestIdx] = min(meanCV);
fprintf('交叉验证最优阶数 = %d, 平均RMSE = %.3f\n', ...
    degs(bestIdx), bestRMSE);
取各折验证 RMSE 的均值作为该阶数的泛化误差估计,最小值对应的阶数即为推荐阶数。若最优阶数附近(±1 阶)的 RMSE 差异很小,应优先选择更低阶模型,以降低对训练数据扰动的敏感度。
注意:交叉验证的折数 K 不宜过小(建议 5~10),否则每折训练样本过少,高阶模型容易在个别折上出现极端误差,导致均值失真。
过拟合诊断与选阶流程
下图把上述诊断逻辑组织为一条可复用的判断链:从含噪数据出发,分别观察训练/验证误差分叉、残差结构、交叉验证均值三条证据,最终落到阶数选择决策。
结果判读与工程建议
- 欠拟合信号:训练与验证 RMSE 都高且接近,残差呈现明显弯曲趋势,应提高阶数或改用更合适的模型形式。
- 过拟合信号:训练 RMSE 持续下降但验证 RMSE 回升,残差出现高频振荡,应降低阶数或增加正则化。
- 选阶原则:优先取交叉验证均值最小的阶数;若相邻阶数差异小于 5%,选更低阶以提升鲁棒性。
- 数据量约束:经验上阶数不宜超过样本数的平方根量级,25 个点对应约 5 阶上限,超过后过拟合风险急剧上升。
本案例的核心不是“拟合得越准越好”,而是通过训练/验证误差分叉、残差结构和交叉验证三条独立证据,判断模型是在学习趋势还是在记忆噪声,从而选出泛化能力最好的阶数。