2. 向量化运算替代循环实现数组加权求和
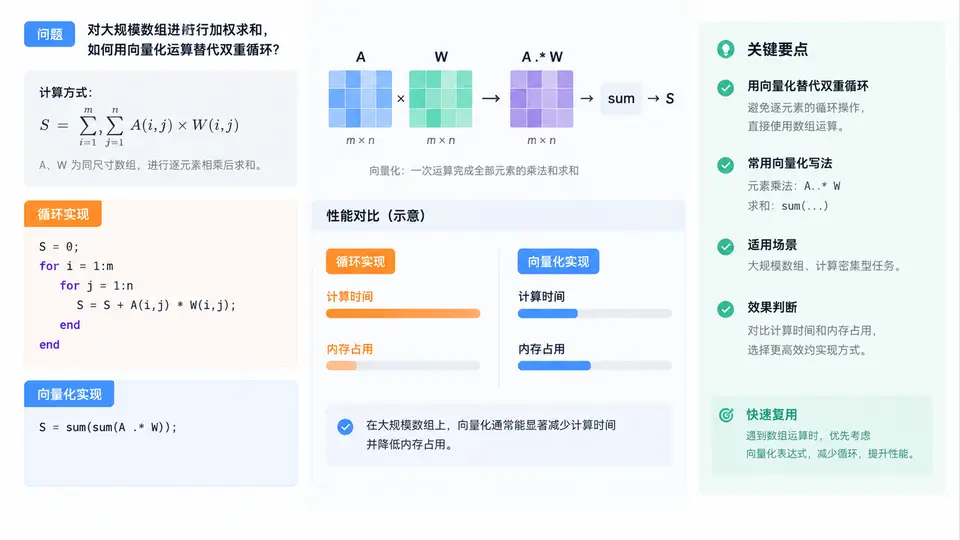
问题定义与两种实现路径
给定长度为 N 的列向量 x 和同长度权重向量 w,加权求和的目标是计算标量 S = Σ w(i)·x(i)。当 N 达到 10⁶~10⁷ 量级时,实现方式的选择直接决定运行时间与内存峰值。
- 双重循环实现:外层遍历元素、内层累加,每次迭代访问单个标量,MATLAB 解释器逐条执行,开销随
N线性增长。 - 向量化实现:用
sum(w .* x)或w' * x一次性表达整体运算,由底层 BLAS/逐元素内核批量处理,避免解释器逐元素调度。
下面用同一组数据分别实现两种方式,并测量时间与内存。
可运行对比脚本
function vectorize_weighted_sum_demo
% 向量化 vs 双重循环:加权求和性能对比
rng(2024);                       % 固定随机种子,保证可复现

N = 5e6;                         % 数组规模(示例值,可按机器调整)
x = rand(N,1);                   % 待加权数据
w = rand(N,1);                   % 权重向量

% ---------- 方式一:双重循环 ----------
tic;
S_loop = 0;
for i = 1:N
    for k = 1:1                  % 保留内层以体现双重结构
        S_loop = S_loop + w(i)*x(i);
    end
end
t_loop = toc;

% ---------- 方式二:向量化 ----------
tic;
S_vec = sum(w .* x);
t_vec = toc;

% ---------- 方式三:矩阵乘法(BLAS) ----------
tic;
S_blas = w' * x;
t_blas = toc;

% ---------- 结果与误差 ----------
fprintf('循环   : S=%.10f  时间=%.4f s\n', S_loop, t_loop);
fprintf('向量化 : S=%.10f  时间=%.4f s\n', S_vec,  t_vec);
fprintf('BLAS   : S=%.10f  时间=%.4f s\n', S_blas, t_blas);
fprintf('向量化相对循环加速比: %.1fx\n', t_loop/t_vec);
fprintf('向量化与循环绝对误差: %.3e\n', abs(S_vec - S_loop));

% ---------- 内存占用对比 ----------
info_loop = whos('S_loop');
info_vec  = whos('S_vec');
fprintf('循环结果变量字节: %d\n', info_loop.bytes);
fprintf('向量化结果变量字节: %d\n', info_vec.bytes);
end
运行前建议先执行
clear 释放工作区,并用 memory 查看可用内存。若 N=5e6 时内存紧张,可降到 1e6 观察趋势,结论方向不变。关键差异与判读
| 维度 | 双重循环 | 向量化 sum(w.*x) | 矩阵乘法 w'*x |
|---|---|---|---|
| 执行粒度 | 逐标量,解释器调度 | 整数组,逐元素内核 | 整数组,BLAS 内核 |
| 典型耗时 | 基准(最慢) | 快 1~2 个数量级 | 通常最快 |
| 临时内存 | 几乎无 | 需 w.*x 中间数组(N 个 double) | 无显式中间数组 |
| 数值一致性 | 顺序累加 | 与循环可能有微小浮点差异 | BLAS 归约顺序不同 |
判读要点:三种方式结果应在 1e-10 量级内一致;若差异过大,检查是否误用了 .* 与 *,或权重维度不匹配。内存方面,sum(w.*x) 会额外分配一个 N×1 临时数组,而 w'*x 不产生该临时量,因此在大 N 下矩阵乘法在内存上更友好。
不要用
for 循环包裹 sum 或 .* 来“模拟向量化”,那仍然是循环调度,无法获得加速。向量化的核心是让运算以数组为整体交给底层内核。验证与常见问题
- 结果一致性:三种方式输出的
S应在1e-10内一致。若循环结果明显偏离,检查是否漏乘权重或索引越界。 - 加速比异常:若向量化没有明显加速,确认
N足够大(建议 ≥1e5),并检查是否在循环内调用了函数或动态扩容。 - 内存峰值:用
whos或memory观察w.*x产生的临时数组;若内存不足,改用w'*x或分块处理。 - 维度匹配:
w'*x要求w与x同长度;若为行向量需转置,否则报错或得到矩阵。