1. 基于谱减法的语音降噪
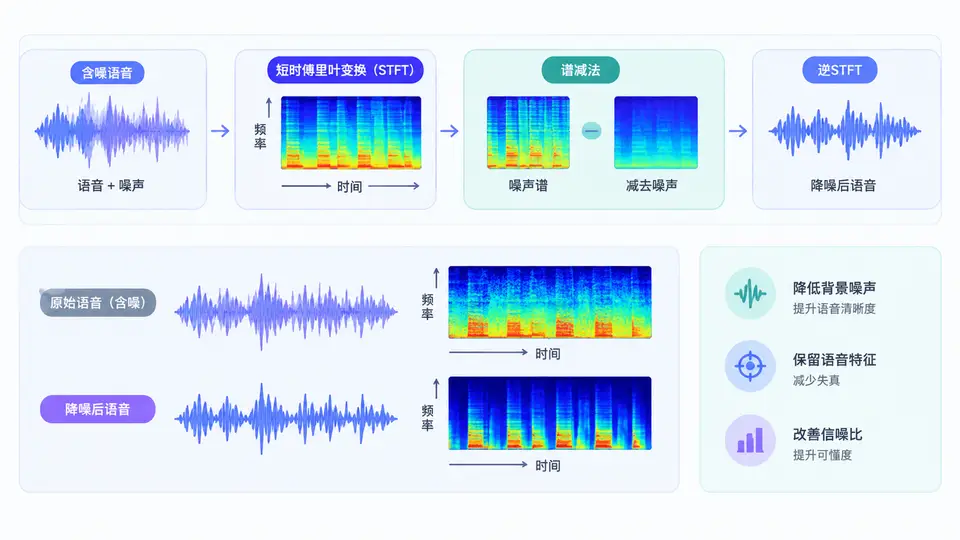
任务目标
实现经典谱减法(Spectral Subtraction),对叠加了加性噪声的语音信号进行降噪处理,并通过信噪比(SNR)提升与波形对比评估降噪效果。本案例聚焦于谱减法的核心算法实现与效果验证,不涉及端点检测、噪声估计自适应等扩展内容。
实现原理
谱减法的基本假设是:带噪语音的短时幅度谱 ≈ 干净语音幅度谱 + 噪声幅度谱(相位近似不变)。因此,用带噪语音的幅度谱减去估计得到的噪声幅度谱,再结合原始相位进行逆变换,即可恢复增强后的语音。噪声谱通过带噪语音的前导静音段(无语音段)进行统计平均估计。
完整实现代码
import numpy as np
import soundfile as sf
import matplotlib.pyplot as plt

def spectral_subtraction(noisy, sr, n_fft=512, hop=128, alpha=1.0, beta=0.01, noise_frames=10):
    """
    经典谱减法降噪
    Args:
        noisy: 含噪语音信号 (float)
        sr: 采样率
        n_fft: FFT窗口长度
        hop: 帧移
        alpha: 过减因子 (通常1~2)
        beta: 频谱下限因子 (0~0.1)
        noise_frames: 用于估计噪声的起始帧数
    Returns:
        enhanced: 降噪后的语音信号
    """
    # 分帧加窗
    win = np.hanning(n_fft)
    n_frames = 1 + (len(noisy) - n_fft) // hop
    frames = np.zeros((n_frames, n_fft))
    for i in range(n_frames):
        start = i * hop
        frames[i] = noisy[start:start + n_fft] * win

    # STFT
    spec = np.fft.rfft(frames, axis=1)
    mag = np.abs(spec)
    phase = np.angle(spec)

    # 噪声估计:取前noise_frames帧的平均幅度谱
    noise_mag = np.mean(mag[:noise_frames], axis=0)

    # 谱减
    mag_enhanced = np.maximum(mag**alpha - noise_mag**alpha, beta * noise_mag**alpha) ** (1/alpha)

    # ISTFT
    spec_enhanced = mag_enhanced * np.exp(1j * phase)
    frames_enhanced = np.fft.irfft(spec_enhanced, n=n_fft, axis=1)

    # 重叠相加
    enhanced = np.zeros(len(noisy))
    window_sum = np.zeros(len(noisy))
    for i in range(n_frames):
        start = i * hop
        enhanced[start:start + n_fft] += frames_enhanced[i] * win
        window_sum[start:start + n_fft] += win**2
    # 归一化(避免除以零)
    enhanced = enhanced / (window_sum + 1e-10)
    return enhanced

def compute_snr(clean, processed):
    """计算信噪比 (dB)"""
    noise = clean - processed
    snr = 10 * np.log10(np.sum(clean**2) / (np.sum(noise**2) + 1e-10))
    return snr

# ========== 主程序 ==========
if __name__ == "__main__":
    # 1. 读取干净语音(请替换为实际文件路径)
    clean, sr = sf.read("clean_speech.wav")

    # 2. 生成含噪语音(添加高斯白噪声,目标SNR=5dB)
    np.random.seed(42)
    noise = np.random.randn(len(clean))
    noise = noise / np.sqrt(np.sum(noise**2)) * np.sqrt(np.sum(clean**2) / 10**(5/10))
    noisy = clean + noise

    # 3. 谱减法降噪
    enhanced = spectral_subtraction(noisy, sr, alpha=1.5, beta=0.01)

    # 4. 评估
    snr_noisy = compute_snr(clean, noisy)
    snr_enhanced = compute_snr(clean, enhanced)
    print(f"含噪语音 SNR: {snr_noisy:.2f} dB")
    print(f"降噪后 SNR: {snr_enhanced:.2f} dB")

    # 5. 保存结果
    sf.write("enhanced.wav", enhanced, sr)

    # 6. 绘制波形对比
    t = np.arange(len(clean)) / sr
    plt.figure(figsize=(12, 8))
    plt.subplot(3, 1, 1)
    plt.plot(t, clean)
    plt.title("Clean Speech")
    plt.subplot(3, 1, 2)
    plt.plot(t, noisy)
    plt.title("Noisy Speech (SNR=5dB)")
    plt.subplot(3, 1, 3)
    plt.plot(t, enhanced)
    plt.title("Enhanced Speech")
    plt.tight_layout()
    plt.savefig("comparison.png", dpi=150)
    plt.show()
运行与验证
环境依赖:numpy、soundfile、matplotlib(用于绘图)。安装命令:pip install numpy soundfile matplotlib
运行步骤:
- 准备一段干净语音文件,命名为
clean_speech.wav,放置于脚本同目录(采样率建议16kHz,时长2~3秒即可); - 直接运行脚本:
python spectral_subtraction.py; - 程序将生成
enhanced.wav和comparison.png。
通过条件:
- 控制台输出的降噪后SNR高于含噪SNR(例如从5dB提升至10dB以上);
- 波形对比图中,增强语音的波形背景噪声明显减少,语音段轮廓清晰;
- 试听
enhanced.wav,背景噪声显著降低,语音可懂度保持良好。
参数说明与常见问题
- alpha(过减因子):增大可更强抑制噪声,但过大会导致语音失真(产生“音乐噪声”);建议范围1~2。
- beta(频谱下限):防止减后幅度为负值,beta越大残留噪声越多但音乐噪声越少。
- 噪声帧数:取前10帧(约0.1秒)估计噪声,需确保该段无语音;若文件开头有语音,需调整起始位置。
- 音乐噪声:谱减法的固有问题,表现为残留的断续 tonal 噪声。可通过增大beta或后续引入平滑处理缓解,但本案例不展开。