1. 构建现金流数据集
任务目标
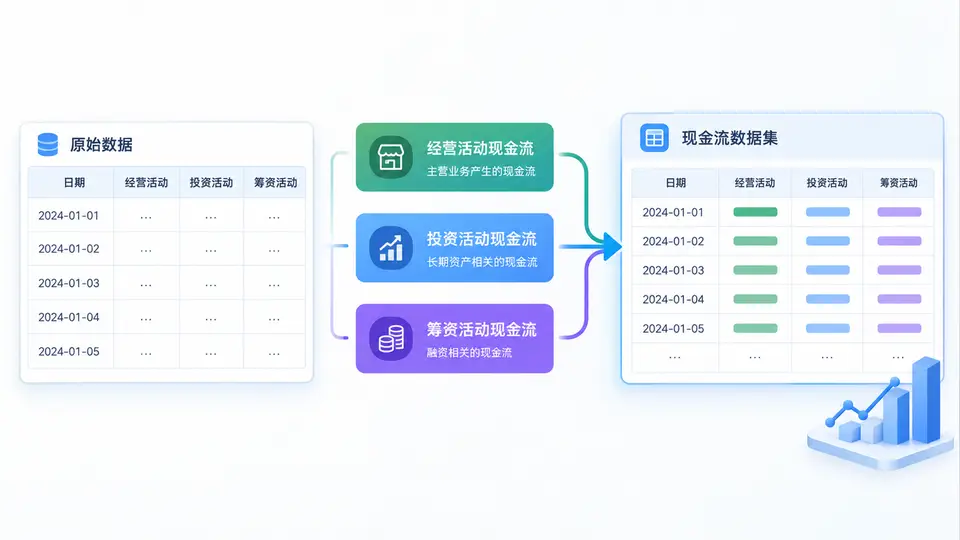
构建一个结构清晰的模拟现金流数据集,包含经营、投资、筹资三类活动的现金流入与流出记录,并附带日期字段,为后续的现金流预测与异常检测分析提供标准化输入。
数据集设计
数据集采用长表格式(每行一条现金流记录),包含以下字段:
- date:交易日期(2023-01-01 至 2023-12-31,按日生成)
- activity:活动类型(operating / investing / financing)
- cash_in:当日该活动的现金流入金额(万元)
- cash_out:当日该活动的现金流出金额(万元)
- net_cash:当日净现金流 = cash_in - cash_out
为贴近真实场景,三类活动采用不同的生成逻辑:经营活动现金流具有周期性波动(周末略低)并叠加适度随机噪声;投资活动以低频大额交易为主(约每5~10天发生一次);筹资活动仅在少数特定日期发生(如月初或季末)。
完整实现代码
import pandas as pd
import numpy as np
from datetime import datetime, timedelta

# 固定随机种子,保证结果可复现
np.random.seed(42)

# 生成日期范围:2023年全年
start_date = datetime(2023, 1, 1)
end_date = datetime(2023, 12, 31)
dates = pd.date_range(start_date, end_date, freq='D')

records = []

for d in dates:
    # 判断是否为周末(周六=5,周日=6)
    is_weekend = d.weekday() >= 5

    # ---- 经营活动 ----
    # 基础水平:工作日约50万流入,周末降至约30万
    base_in = 30 if is_weekend else 50
    # 月度季节性:月初略高
    if d.day <= 5:
        base_in *= 1.2
    op_in = max(0, np.random.normal(base_in, 8))

    # 流出与流入正相关,加上独立噪声
    op_out = max(0, np.random.normal(op_in * 0.7, 6))

    # ---- 投资活动 ----
    # 低频:约每7天发生一次交易
    inv_in = 0.0
    inv_out = 0.0
    if np.random.rand() < 0.14:  # 约14%概率发生
        if np.random.rand() < 0.4:  # 40%为流入(如资产处置)
            inv_in = np.random.uniform(80, 200)
        else:  # 60%为流出(如购置资产)
            inv_out = np.random.uniform(100, 300)

    # ---- 筹资活动 ----
    fin_in = 0.0
    fin_out = 0.0
    # 仅在每月1日和季末(3/31, 6/30, 9/30, 12/31)发生
    is_month_start = d.day == 1
    is_quarter_end = (d.month in [3, 6, 9, 12]) and (d.day == 30 or (d.month == 12 and d.day == 31))
    if is_month_start:
        fin_in = np.random.uniform(50, 150)  # 如新增借款
    if is_quarter_end:
        fin_out = np.random.uniform(80, 200)  # 如分红或还款

    # 写入记录(仅保留至少有一项活动发生的日期)
    if op_in > 0 or op_out > 0 or inv_in > 0 or inv_out > 0 or fin_in > 0 or fin_out > 0:
        # 经营
        records.append([d.date(), 'operating', round(op_in, 2), round(op_out, 2), round(op_in - op_out, 2)])
        # 投资(若发生)
        if inv_in > 0 or inv_out > 0:
            records.append([d.date(), 'investing', round(inv_in, 2), round(inv_out, 2), round(inv_in - inv_out, 2)])
        # 筹资(若发生)
        if fin_in > 0 or fin_out > 0:
            records.append([d.date(), 'financing', round(fin_in, 2), round(fin_out, 2), round(fin_in - fin_out, 2)])

# 构建DataFrame
df = pd.DataFrame(records, columns=['date', 'activity', 'cash_in', 'cash_out', 'net_cash'])

# 按日期和活动排序
df = df.sort_values(['date', 'activity']).reset_index(drop=True)

# 查看数据概览
print(f"总记录数: {len(df)}")
print(f"日期范围: {df['date'].min()} 至 {df['date'].max()}")
print("\n各活动记录数:")
print(df['activity'].value_counts())
print("\n前10行数据:")
print(df.head(10))

# 保存为CSV文件(供后续案例使用)
df.to_csv('cash_flow_dataset.csv', index=False)
print("\n数据集已保存至 cash_flow_dataset.csv")
运行方式
- 安装依赖:
pip install pandas numpy - 将上述代码保存为
build_dataset.py并运行:python build_dataset.py
验证方法
运行后观察输出:
- 总记录数应在 500~700 条之间(经营每日2条记录,投资约50次,筹资约16次)
- 日期范围覆盖 2023-01-01 至 2023-12-31
- 经营活动记录约365条,投资活动约40~60条,筹资活动约15~17条
- 生成的
cash_flow_dataset.csv文件可在当前目录找到,用Excel或pandas可正常打开
通过条件:CSV文件成功生成,且各活动记录数与上述范围一致,说明数据集构建正确,可作为后续现金流预测与异常检测案例的输入。