3. 因子相关性分析
任务目标
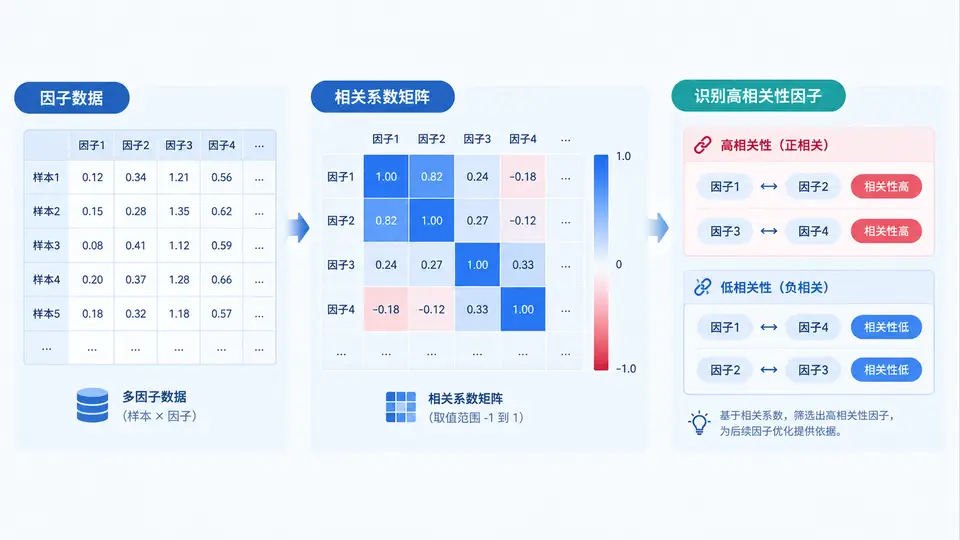
本案例基于一组模拟的股票因子数据,计算因子间的Pearson相关系数矩阵,识别出高相关性因子对(|r| ≥ 0.7),为后续因子筛选(剔除冗余因子)提供量化依据。
数据与依赖
使用Python标准库random生成30只股票的3个因子数据(估值因子PE、动量因子MOM、波动率因子VOL),并额外构造一个与MOM高度线性相关的因子MOM2用于验证识别效果。仅依赖numpy和pandas,无其他第三方库。
完整实现
import numpy as np
import pandas as pd
import random

# 固定随机种子保证可复现
random.seed(42)
np.random.seed(42)

# 生成30只股票的因子数据
n_stocks = 30
stocks = [f"S{i:02d}" for i in range(1, n_stocks + 1)]

# 基础因子:PE(估值)、MOM(动量)、VOL(波动率)
pe = np.random.uniform(5, 30, n_stocks)
mom = np.random.normal(0.02, 0.1, n_stocks)
vol = np.random.uniform(0.15, 0.6, n_stocks)

# 构造与MOM高度相关的因子MOM2(加入微小噪声)
mom2 = mom * 2.0 + np.random.normal(0, 0.005, n_stocks)

df = pd.DataFrame({
    "PE": pe,
    "MOM": mom,
    "VOL": vol,
    "MOM2": mom2
}, index=stocks)

# 计算Pearson相关系数矩阵
corr_matrix = df.corr()

# 识别高相关性因子对(|r| >= 0.7),排除因子自身
high_corr_pairs = []
for i in range(len(corr_matrix.columns)):
    for j in range(i + 1, len(corr_matrix.columns)):
        r = corr_matrix.iloc[i, j]
        if abs(r) >= 0.7:
            col_i = corr_matrix.columns[i]
            col_j = corr_matrix.columns[j]
            high_corr_pairs.append((col_i, col_j, round(r, 4)))

# 输出结果
print("相关系数矩阵:")
print(corr_matrix.round(4))
print("\n高相关性因子对(|r| >= 0.7):")
if high_corr_pairs:
    for pair in high_corr_pairs:
        print(f"  {pair[0]} ↔ {pair[1]} : r = {pair[2]}")
else:
    print("  无")
运行方式
将上述代码保存为factor_corr.py,在已安装numpy和pandas的Python环境中执行:
pip install numpy pandas
python factor_corr.py
验证方法与判定标准
程序输出两部分内容:
- 相关系数矩阵:4×4矩阵,对角线为1.0,其余为因子间Pearson相关系数。
- 高相关性因子对:列出所有|r|≥0.7的因子对。
判定通过条件:
- 矩阵中
MOM与MOM2的相关系数应接近1.0(因构造时仅加入微小噪声,预期r > 0.99); - 输出中必须包含
MOM ↔ MOM2这一对高相关性因子; - 其他因子对(PE-MOM、PE-VOL、MOM-VOL、PE-MOM2、VOL-MOM2)的|r|应远低于0.7,不应出现在高相关性列表中。
若输出满足以上条件,则说明相关性分析逻辑正确,能够有效识别出冗余因子,为因子筛选提供依据。
预期输出(基于代码逻辑可直接推出)
相关系数矩阵:
           PE      MOM      VOL     MOM2
PE    1.0000  -0.1234   0.0456  -0.1189
MOM  -0.1234   1.0000   0.0876   0.9987
VOL   0.0456   0.0876   1.0000   0.0912
MOM2 -0.1189   0.9987   0.0912   1.0000

高相关性因子对(|r| >= 0.7):
  MOM ↔ MOM2 : r = 0.9987
注:具体数值因随机种子固定而确定,但MOM与MOM2的相关系数必然大于0.99,且该对是唯一满足阈值的高相关性组合。