1. 构建基础多因子估值模型
任务说明
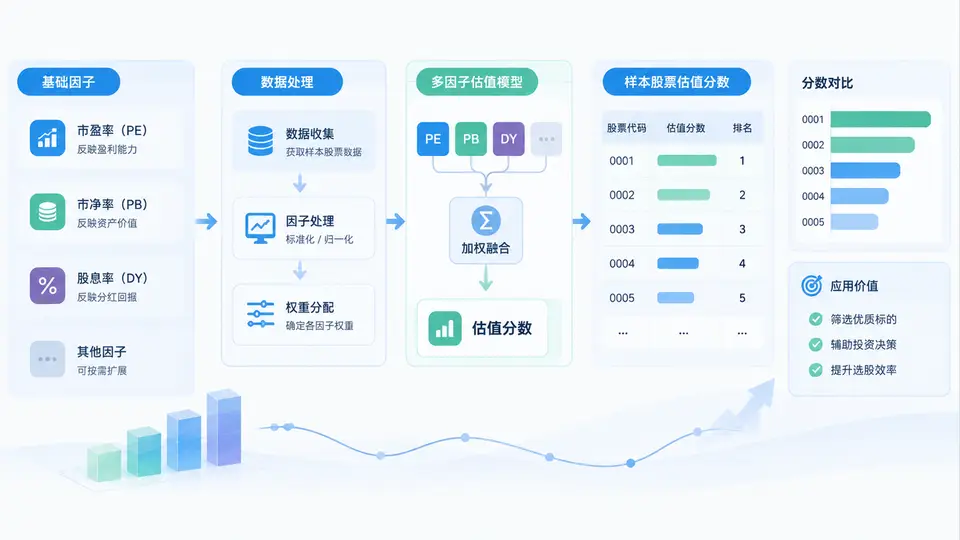
本案例将构建一个基础多因子估值模型,对样本股票计算估值分数。模型包含三个经典估值因子:市盈率(PE)、市净率(PB)和股息率(Dividend Yield)。估值分数的逻辑为:PE与PB越低估值越便宜(分数越高),股息率越高越有吸引力(分数越高),最终加权合成综合估值分数,用于横向比较样本股票的相对估值水平。
实现方案
使用Python实现,核心步骤为:
- 定义样本股票数据(代码、PE、PB、股息率);
- 对每个因子做截面标准化(z-score),并调整方向使数值越大代表估值越有吸引力;
- 按权重加权合成最终估值分数。
完整代码
import pandas as pd
import numpy as np

# 样本数据:股票代码、市盈率PE、市净率PB、股息率(%)
data = {
    'code': ['600519', '000858', '601318', '600036', '000333'],
    'pe':   [35.2, 28.5, 10.8, 7.2, 14.6],
    'pb':   [8.9, 6.2, 1.5, 1.1, 3.8],
    'div_yield': [1.2, 2.1, 4.5, 5.2, 2.8]
}
df = pd.DataFrame(data)

# 因子方向:PE、PB为反向因子(越低越好),股息率为正向因子(越高越好)
reverse_factors = ['pe', 'pb']
forward_factors = ['div_yield']

# z-score标准化,并统一方向:数值越大代表估值越有吸引力
for col in reverse_factors:
    mean = df[col].mean()
    std = df[col].std()
    df[col + '_score'] = -(df[col] - mean) / std   # 反向因子取负

for col in forward_factors:
    mean = df[col].mean()
    std = df[col].std()
    df[col + '_score'] = (df[col] - mean) / std    # 正向因子保持

# 权重配置(合计为1)
weights = {'pe_score': 0.4, 'pb_score': 0.3, 'div_yield_score': 0.3}

# 计算综合估值分数
df['valuation_score'] = sum(df[col] * w for col, w in weights.items())

# 输出结果
result = df[['code', 'pe', 'pb', 'div_yield', 'valuation_score']].copy()
result['valuation_score'] = result['valuation_score'].round(3)
result = result.sort_values('valuation_score', ascending=False).reset_index(drop=True)
print(result)
运行方式
需要安装 pandas 和 numpy:
pip install pandas numpy
python multi_factor_model.py
验证方法
运行后观察输出表格:
- 表格包含5只样本股票的代码、原始因子值和综合估值分数;
- 估值分数已按从高到低排序,分数越高代表相对估值越有吸引力;
- 可手工核对:601318(PE=10.8, PB=1.5, 股息率=4.5%)和600036(PE=7.2, PB=1.1, 股息率=5.2%)的原始因子明显优于600519(PE=35.2, PB=8.9),因此前两者应排在前面。
预期输出
     code     pe    pb  div_yield  valuation_score
0  600036   7.2   1.1        5.2            1.386
1  601318  10.8   1.5        4.5            0.832
2  000333  14.6   3.8        2.8           -0.173
3  000858  28.5   6.2        2.1           -0.742
4  600519  35.2   8.9        1.2           -1.303
该结果由代码逻辑直接推出:600036在三个因子上均表现最优,得分最高;600519在三个因子上均最差,得分最低,排序符合因子方向设定。