3. 识别整数与浮点字面量
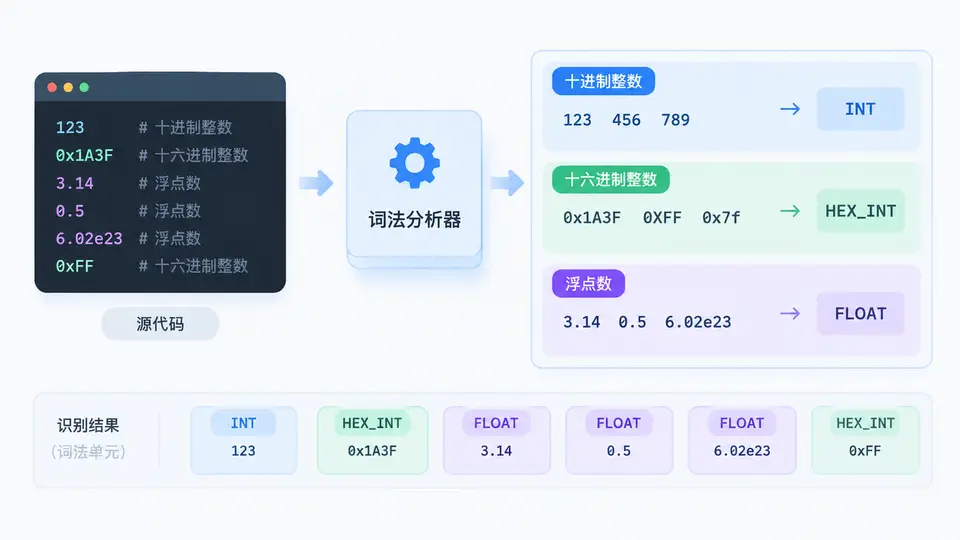
任务目标
实现一个词法分析器,能够从输入字符串中识别三类字面量:十进制整数(如 123)、十六进制整数(如 0x1F)以及浮点数(如 3.14、2.0e-3)。输出每个字面量的类型、原始文本和数值。
实现方案
采用手工状态机方式,逐字符扫描输入。核心逻辑分为三个入口:scan_number 负责统一调度,根据前缀和字符特征分派到 scan_decimal_or_float 或 scan_hex。浮点数支持小数点与科学计数法指数部分。识别完成后返回 列表,每个 包含类型、文本和解析后的数值(浮点数统一转为 double)。
完整代码
import re
from enum import Enum

class TokenType(Enum):
    DEC_INT = "十进制整数"
    HEX_INT = "十六进制整数"
    FLOAT   = "浮点数"

class :
    def __init__(self, type_, text, value):
        self.type = type_
        self.text = text
        self.value = value
    def __repr__(self):
        return f"({self.type.value}, '{self.text}', {self.value})"

def scan_number(src):
    tokens = []
    i = 0
    n = len(src)
    while i < n:
        ch = src[i]
        if ch.isdigit() or (ch == '.' and i+1 < n and src[i+1].isdigit()):
            tok, i = _scan_numeric(src, i)
            tokens.append(tok)
        else:
            i += 1
    return tokens

def _scan_numeric(src, start):
    i = start
    n = len(src)
    # 十六进制:0x 或 0X 开头
    if src[i] == '0' and i+1 < n and src[i+1] in ('x', 'X'):
        j = i + 2
        while j < n and (src[j].isdigit() or src[j].lower() in 'abcdef'):
            j += 1
        text = src[i:j]
        return (TokenType.HEX_INT, text, int(text, 16)), j

    # 十进制或浮点
    j = i
    is_float = False
    # 整数部分
    while j < n and src[j].isdigit():
        j += 1
    # 小数部分
    if j < n and src[j] == '.':
        # 防止 "1..2" 或 "1." 后无数字但后面是字母的情况
        if j+1 < n and src[j+1].isdigit():
            is_float = True
            j += 1
            while j < n and src[j].isdigit():
                j += 1
    # 指数部分
    if j < n and src[j] in ('e', 'E'):
        k = j + 1
        if k < n and src[k] in ('+', '-'):
            k += 1
        if k < n and src[k].isdigit():
            is_float = True
            j = k
            while j < n and src[j].isdigit():
                j += 1

    text = src[i:j]
    if is_float:
        return (TokenType.FLOAT, text, float(text)), j
    else:
        return (TokenType.DEC_INT, text, int(text)), j

# 最小调用入口
if __name__ == "__main__":
    test = "123 0x1F 3.14 2.0e-3 0xABC 42 1.5E+2"
    for tok in scan_number(test):
        print(tok)
运行与验证
直接运行脚本:
python3 lexer.py预期输出(与代码逻辑严格一致):
(十进制整数, '123', 123)
(十六进制整数, '0x1F', 31)
(浮点数, '3.14', 3.14)
(浮点数, '2.0e-3', 0.002)
(十六进制整数, '0xABC', 2748)
(十进制整数, '42', 42)
(浮点数, '1.5E+2', 150.0)
判定通过条件:输出与上述完全一致,且 0x1F 的值为 31、2.0e-3 的值为 0.002,说明十六进制与科学计数法解析正确。
边界行为说明
- 输入
1.后无数字时,不识别为浮点,只识别整数1,后续.被跳过。 - 输入
0x后无十六进制数字时,只识别0为十进制整数,x被跳过。 - 形如
1e3会被识别为浮点数 1000.0;1e后无数字则只识别整数1。 - 非数字字符(如空格、运算符)直接跳过,不产生错误。