1. 词法分析器框架搭建
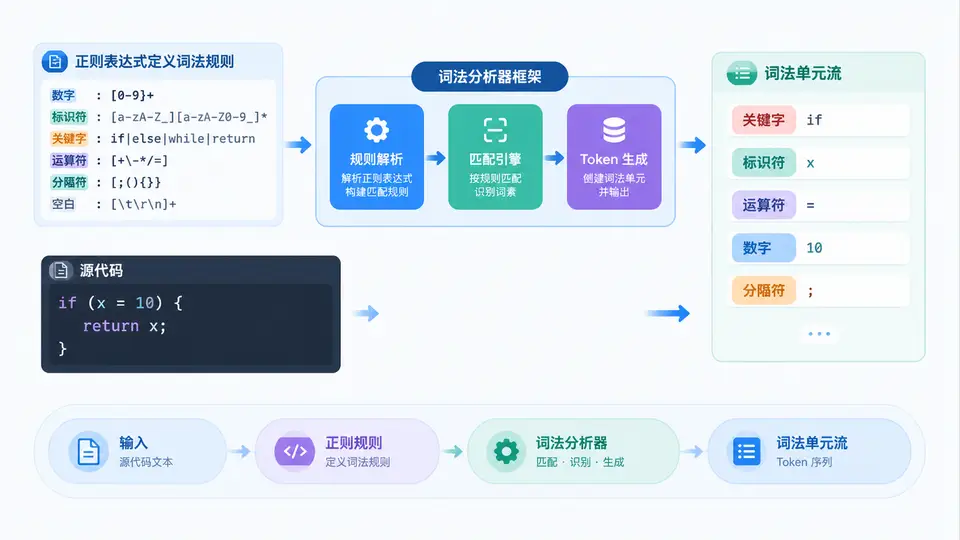
任务目标
实现一个词法分析器框架,支持以正则表达式定义词法规则,对输入源码进行扫描,输出带类型与位置信息的词法单元流。本案例聚焦框架核心:规则注册、最长匹配、单元生成与错误报告。
环境依赖
Python 3.8+,仅使用标准库 re,无第三方依赖。
核心实现
import re
from dataclasses import dataclass
from typing import List, Tuple, Optional

@dataclass
class :
    type: str
    value: str
    line: int
    col: int

class Lexer:
    def __init__(self):
        self.rules = []  # (type, compiled_pattern)

    def add_rule(self, _type: str, pattern: str):
        """注册词法规则,pattern为正则表达式字符串"""
        compiled = re.compile(pattern)
        self.rules.append((_type, compiled))

    def tokenize(self, code: str) -> Tuple[List[], List[str]]:
        tokens = []
        errors = []
        pos = 0
        line = 1
        line_start = 0
        n = len(code)

        while pos < n:
            # 处理换行
            if code[pos] == '\n':
                line += 1
                line_start = pos + 1
                pos += 1
                continue

            # 跳过空白(空格、制表符、回车)
            if code[pos] in ' \t\r':
                pos += 1
                continue

            best_match = None
            best_type = None
            best_len = 0

            # 遍历所有规则,找最长匹配
            for _type, pattern in self.rules:
                m = pattern.match(code, pos)
                if m:
                    length = m.end() - m.start()
                    if length > best_len:
                        best_len = length
                        best_match = m
                        best_type = _type

            if best_match is None:
                # 无法匹配任何规则
                col = pos - line_start + 1
                errors.append(f"第{line}行第{col}列: 无法识别的字符 '{code[pos]}'")
                pos += 1
            else:
                value = best_match.group(0)
                col = pos - line_start + 1
                tokens.append((best_type, value, line, col))
                pos += best_len

        return tokens, errors

# 使用示例
if __name__ == "__main__":
    lexer = Lexer()
    lexer.add_rule("NUMBER", r'\d+')
    lexer.add_rule("IDENT", r'[A-Za-z_]\w*')
    lexer.add_rule("OP", r'[+\-*/=]')
    lexer.add_rule("LPAREN", r'\(')
    lexer.add_rule("RPAREN", r'\)')

    source = "x = 42 + total * 3"
    tokens, errors = lexer.tokenize(source)

    for tok in tokens:
        print(f"{tok.type:<8} {tok.value!r:<12} 行{tok.line} 列{tok.col}")
    if errors:
        print("\n错误:")
        for e in errors:
            print(e)
运行方式
python lexer.py验证方法
运行后观察输出:应得到6个词法单元,类型依次为 IDENT、OP、NUMBER、IDENT、OP、NUMBER,且每个单元的行列位置与源码实际位置一致。若输入包含无法匹配的字符(如 @),框架应报告包含行号、列号及具体字符的错误信息,并跳过该字符继续扫描。
验证要点
- 最长匹配:输入
abc123时,若同时注册了IDENT([A-Za-z_]\w*)和NUMBER(\d+),应整体识别为IDENT,而非先识别abc再识别123。 - 位置追踪:多行输入时,换行后行号递增,列号从1重新计算。
- 错误恢复:遇到非法字符时报告错误并继续,不中断整个扫描过程。