3. 词法分析器
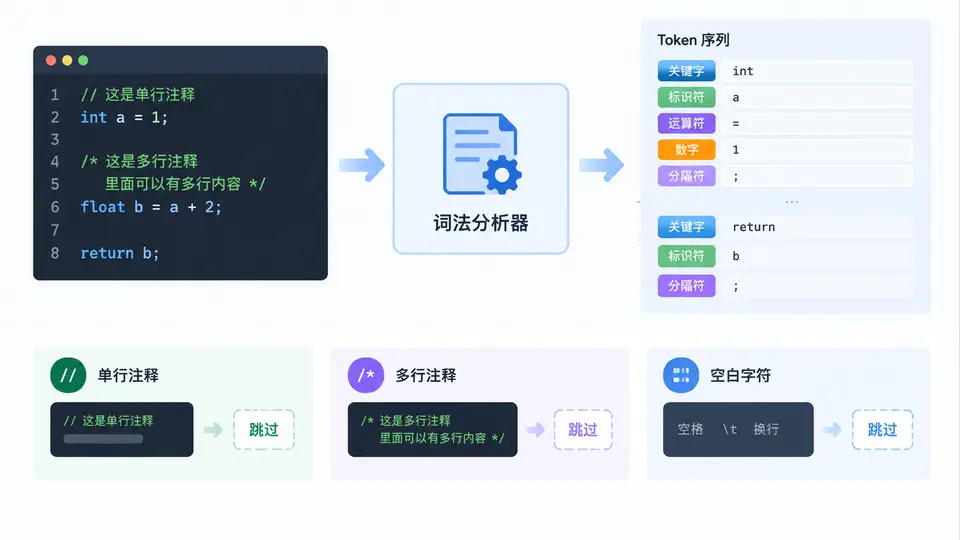
任务目标
在词法分析器中实现三类跳过逻辑:空白字符(空格、制表符、换行)、单行注释(// ...)和多行注释(/* ... */)。要求词法分析器在读取下一个有效 前,能正确跳过这些无意义输入,且多行注释支持跨行与嵌套场景的明确处理策略。
实现方案
采用手工递归下降词法分析器的最小可复现实现。核心是 skipTrivia() 函数:循环检查当前字符,遇到空白则前进;遇到 / 时向前看一个字符,若为 / 则跳过至行尾,若为 * 则进入多行注释跳过逻辑,否则回退并结束跳过。多行注释采用非嵌套语义(遇到第一个 */ 即结束),这是 C/C++ 标准行为,需在注释中明确说明。
词法分析器主体只识别最简单的标识符与数字 ,用于验证跳过逻辑确实生效——即注释与空白被正确忽略后,分析器能连续产出有效 。
完整代码
#include <stdio.h>
#include <ctype.h>
#include <string.h>

typedef enum {
    TOK_EOF = 0,
    TOK_IDENT,
    TOK_NUMBER,
    TOK_UNKNOWN
} TokenType;

typedef struct {
    TokenType type;
    char lexeme[64];
} ;

typedef struct {
    const char *src;
    int pos;
} Lexer;

static void skipTrivia(Lexer *lx) {
    while (lx->src[lx->pos] != '\0') {
        char c = lx->src[lx->pos];
        // 空白字符
        if (c == ' ' || c == '\t' || c == '\n' || c == '\r') {
            lx->pos++;
            continue;
        }
        // 注释:以 / 开头
        if (c == '/' && lx->src[lx->pos + 1] == '/') {
            // 单行注释:跳到行尾
            while (lx->src[lx->pos] != '\0' && lx->src[lx->pos] != '\n')
                lx->pos++;
            continue;
        }
        if (c == '/' && lx->src[lx->pos + 1] == '*') {
            // 多行注释:非嵌套,遇到第一个 */ 结束
            lx->pos += 2;  // 跳过 /*
            while (lx->src[lx->pos] != '\0') {
                if (lx->src[lx->pos] == '*' && lx->src[lx->pos + 1] == '/') {
                    lx->pos += 2;
                    break;
                }
                lx->pos++;
            }
            continue;
        }
        break;  // 非空白、非注释,结束跳过
    }
}

static  nextToken(Lexer *lx) {
     tok = {TOK_UNKNOWN, ""};
    skipTrivia(lx);

    char c = lx->src[lx->pos];
    if (c == '\0') {
        tok.type = TOK_EOF;
        return tok;
    }

    // 标识符:字母或下划线开头
    if (isalpha(c) || c == '_') {
        int len = 0;
        while (isalnum(lx->src[lx->pos]) || lx->src[lx->pos] == '_') {
            if (len < 63)
                tok.lexeme[len++] = lx->src[lx->pos];
            lx->pos++;
        }
        tok.lexeme[len] = '\0';
        tok.type = TOK_IDENT;
        return tok;
    }

    // 数字:仅支持整数
    if (isdigit(c)) {
        int len = 0;
        while (isdigit(lx->src[lx->pos])) {
            if (len < 63)
                tok.lexeme[len++] = lx->src[lx->pos];
            lx->pos++;
        }
        tok.lexeme[len] = '\0';
        tok.type = TOK_NUMBER;
        return tok;
    }

    // 未知字符:前进一位避免死循环
    tok.lexeme[0] = c;
    tok.lexeme[1] = '\0';
    lx->pos++;
    return tok;
}

int main() {
    const char *input =
        "  // 单行注释\n"
        "  alpha  /* 多行\n"
        "     注释 */  beta\n"
        "  /* 未闭合注释";
    Lexer lx = {input, 0};

     t;
    while ((t = nextToken(&lx)).type != TOK_EOF) {
        printf("type=%d lexeme='%s'\n", t.type, t.lexeme);
    }
    printf("type=%d lexeme='%s'\n", TOK_EOF, "(eof)");
    return 0;
}
编译与运行
gcc -o lexer lexer.c && ./lexer验证方法
程序输入包含:单行注释、跨行多行注释、未闭合多行注释(用于验证不会死循环)。运行后观察输出,满足以下条件即判定通过:
- 输出中不包含任何注释内容或空白字符对应的 ;
- 依次输出
alpha(标识符)、beta(标识符)两个有效 ; - 未闭合的多行注释被安全跳过至字符串末尾,随后输出
TOK_EOF,程序正常退出。
预期输出(与代码逻辑严格对应):
type=1 lexeme='alpha'
type=1 lexeme='beta'
type=0 lexeme='(eof)'
其中 type=1 对应 TOK_IDENT,type=0 对应 TOK_EOF。
关键说明
多行注释采用非嵌套语义,即 /* /* */ 在第一个 */ 处结束。若需支持嵌套注释(如某些脚本语言),需引入计数器记录 /* 深度,当前实现不包含该逻辑。单行注释以 \n 或文件末尾为终止边界,不处理 Windows 的 \r\n 中的 \r 作为独立终止符——但 \r 本身在空白处理中会被跳过,因此不影响正确性。