1. 词法分析器
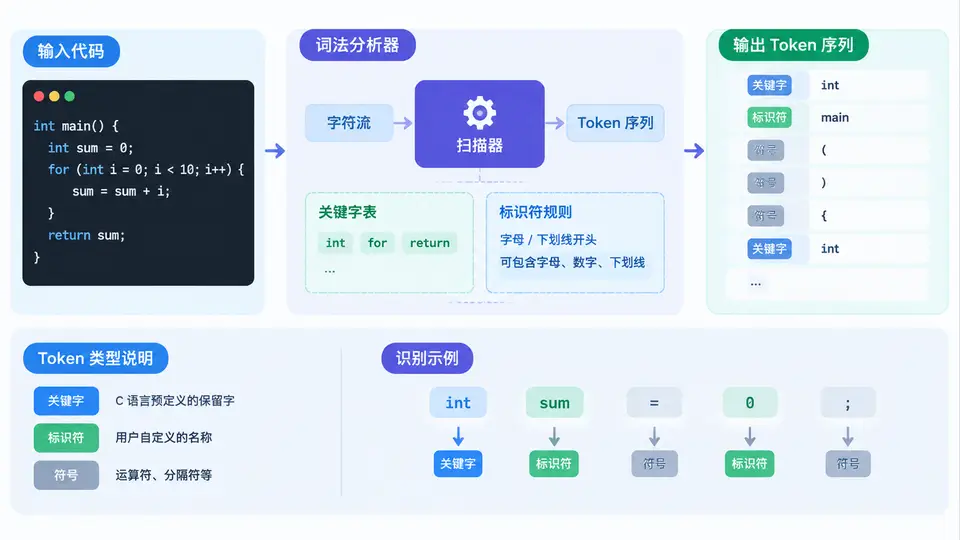
任务目标
实现一个词法分析器,从输入字符串中识别C语言关键字与标识符,输出带类型的序列。输入为单行源码文本,输出为(类型, 值)形式的列表。
实现方案
采用手工扫描方式:逐字符读取输入,跳过空白;若当前字符为字母或下划线,则连续读取字母、数字、下划线构成完整词素,再查关键字表决定类型。关键字表覆盖C语言32个标准关键字。非标识符字符(如运算符、数字开头)直接跳过,不在本案例处理范围内。
完整代码
#include <stdio.h>
#include <ctype.h>
#include <string.h>

const char* keywords[] = {
    "auto", "break", "case", "char", "const", "continue",
    "default", "do", "double", "else", "enum", "extern",
    "float", "for", "goto", "if", "inline", "int",
    "long", "register", "restrict", "return", "short",
    "signed", "sizeof", "static", "struct", "switch",
    "typedef", "union", "unsigned", "void", "volatile", "while"
};
#define KEYWORD_COUNT (sizeof(keywords)/sizeof(keywords[0]))

int is_keyword(const char* word) {
    for (int i = 0; i < KEYWORD_COUNT; i++) {
        if (strcmp(word, keywords[i]) == 0) return 1;
    }
    return 0;
}

void lex(const char* input) {
    int i = 0;
    while (input[i] != '\0') {
        if (isspace(input[i])) { i++; continue; }
        if (isalpha(input[i]) || input[i] == '_') {
            int start = i;
            while (isalnum(input[i]) || input[i] == '_') i++;
            char word[64];
            int len = i - start;
            if (len < 64) {
                strncpy(word, input + start, len);
                word[len] = '\0';
                if (is_keyword(word))
                    printf("(KEYWORD, %s)\n", word);
                else
                    printf("(IDENTIFIER, %s)\n", word);
            }
        } else {
            i++;  // 跳过运算符、数字等非标识符字符
        }
    }
}

int main() {
    const char* code = "int main() { int count = 10; return count; }";
    printf("输入: %s\n\n", code);
    printf("输出序列:\n");
    lex(code);
    return 0;
}
运行与验证
- 将代码保存为
lexer.c,执行gcc lexer.c -o lexer编译。 - 运行
./lexer,观察输出。
预期输出(由代码逻辑直接推出):
输入: int main() { int count = 10; return count; }

输出序列:
(KEYWORD, int)
(IDENTIFIER, main)
(KEYWORD, int)
(IDENTIFIER, count)
(KEYWORD, return)
(IDENTIFIER, count)通过条件:程序输出与上述预期完全一致,即所有C关键字被标记为KEYWORD,其余合法标识符被标记为IDENTIFIER,且10、(、)、{、}、=、;等非标识符字符被正确跳过。
验证方法说明
修改main中的code字符串可测试其他输入。例如输入"float x_1 = 2.5;",预期输出为(KEYWORD, float)和(IDENTIFIER, x_1)。若输入包含"2abc",由于以数字开头,整个词素不会被识别为标识符,符合C语言词法规则。