1. YOLO目标检测环境搭建与图像检测入门
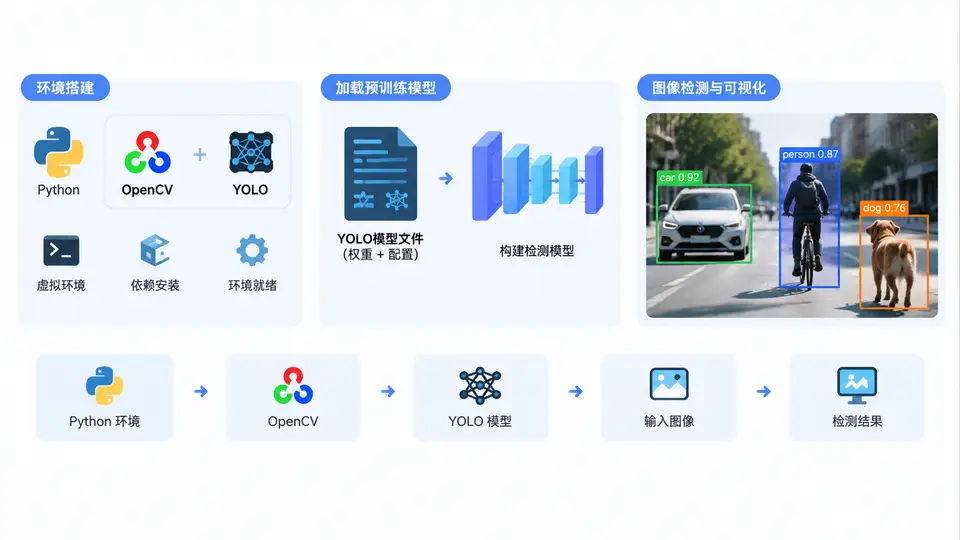
任务目标
本案例完成OpenCV与YOLO目标检测的最小可复现环境搭建:使用OpenCV的DNN模块加载YOLOv4预训练模型,对单张输入图像执行目标检测,并在图像中绘制检测框与类别标签。最终通过命令行运行脚本,输出带标注的结果图像。
环境依赖
- Python 3.8+
- OpenCV:
pip install opencv-python opencv-python-headless numpy - 模型文件(放入项目目录
model/下):yolov4.weights:预训练权重(约245MB),下载地址:https://github.com/AlexeyAB/darknet/releases/download/yolov4/yolov4.weightsyolov4.cfg:网络配置文件,下载地址:https://raw.githubusercontent.com/AlexeyAB/darknet/master/cfg/yolov4.cfgcoco.names:80个类别名称文件,每行一个类别名,可从https://github.com/pjreddie/darknet/blob/master/data/coco.names获取
- 测试图像:任意包含常见物体(人、车、猫等)的JPG图片,路径记为
input.jpg
完整实现代码
将以下代码保存为 yolo_detect.py:
import cv2
import numpy as np

# 配置参数
CONF_THRESH = 0.5   # 置信度阈值
NMS_THRESH = 0.4    # 非极大值抑制阈值
INPUT_SIZE = (416, 416)

# 加载类别名称
with open("model/coco.names", "r") as f:
    classes = [line.strip() for line in f.readlines()]

# 加载YOLO网络
net = cv2.dnn.readNet("model/yolov4.weights", "model/yolov4.cfg")
layer_names = net.getLayerNames()
output_layers = [layer_names[i - 1] for i in net.getUnconnectedOutLayers()]

# 读取并预处理图像
image = cv2.imread("input.jpg")
h, w = image.shape[:2]
blob = cv2.dnn.blobFromImage(image, 1/255.0, INPUT_SIZE, swapRB=True, crop=False)
net.setInput(blob)
detections = net.forward(output_layers)

# 解析检测结果
boxes, confidences, class_ids = [], [], []
for output in detections:
    for detection in output:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]
        if confidence > CONF_THRESH:
            center_x, center_y = int(detection[0]*w), int(detection[1]*h)
            bw, bh = int(detection[2]*w), int(detection[3]*h)
            x, y = int(center_x - bw/2), int(center_y - bh/2)
            boxes.append([x, y, bw, bh])
            confidences.append(float(confidence))
            class_ids.append(class_id)

# NMS去重
indices = cv2.dnn.NMSBoxes(boxes, confidences, CONF_THRESH, NMS_THRESH)

# 绘制检测结果
colors = np.random.randint(0, 255, size=(len(classes), 3), dtype=np.uint8)
for i in indices.flatten():
    x, y, bw, bh = boxes[i]
    label = f"{classes[class_ids[i]]}: {confidences[i]:.2f}"
    color = colors[class_ids[i]].tolist()
    cv2.rectangle(image, (x, y), (x+bw, y+bh), color, 2)
    cv2.putText(image, label, (x, y-5), cv2.FONT_HERSHEY_SIMPLEX, 0.5, color, 1)

# 保存结果
cv2.imwrite("output.jpg", image)
print(f"检测完成,共检测到 {len(indices)} 个目标,结果已保存至 output.jpg")
运行方式
- 确保项目目录结构为:
. ├── yolo_detect.py ├── input.jpg └── model/ ├── yolov4.weights ├── yolov4.cfg └── coco.names - 在项目目录执行:
python yolo_detect.py
验证方法与通过标准
- 运行无报错:程序正常结束,终端输出检测目标数量。
- 结果文件生成:项目目录下出现
output.jpg。 - 检测效果正确:打开
output.jpg,图像中可见物体被矩形框标注,框上方显示类别名称和置信度(如person: 0.92)。若输入图像包含行人、车辆等常见目标,应至少正确框出1个目标。 - 预期输出示例(假设输入图像中有2个人和1辆车):
检测完成,共检测到 3 个目标,结果已保存至 output.jpg。实际数量取决于输入图像内容与阈值设置。
常见问题
- 模型加载失败:检查
model/目录下三个文件是否存在且文件名与代码一致。 - 检测不到目标:可适当降低
CONF_THRESH至0.3,或确认输入图像中物体清晰可见。 - 运行速度慢:CPU推理约需2-5秒/张属正常现象,可改用GPU版OpenCV加速。