3. 量化感知训练入门
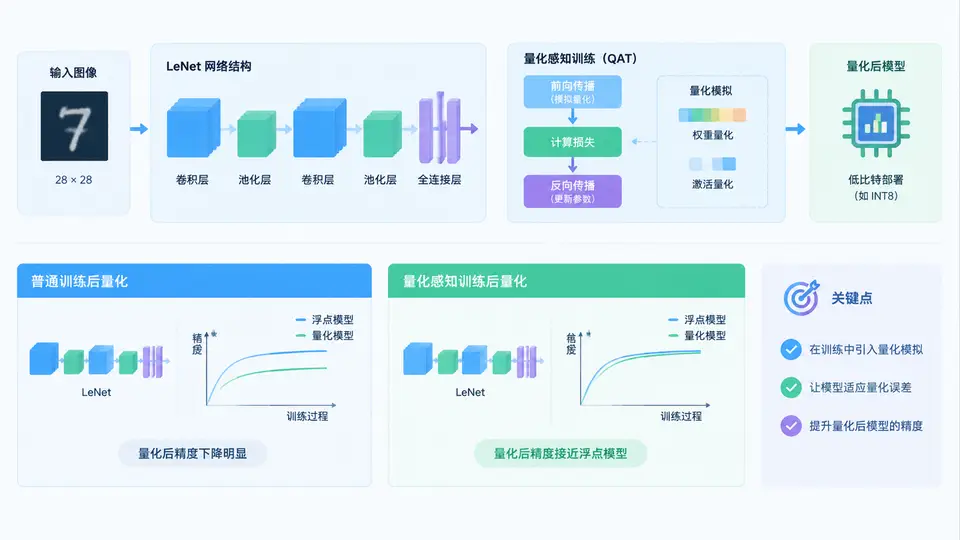
任务目标
在PyTorch中实现量化感知训练(QAT),训练一个LeNet模型用于MNIST分类,并对比普通训练后直接量化与QAT后量化的精度差异。通过本案例,你将理解QAT如何让模型在低比特量化下保持精度。
环境依赖
- Python 3.8+
- PyTorch 2.0+(含torchvision)
- torch.ao.quantization(PyTorch原生量化API)
核心实现
以下代码完整实现了:普通训练、QAT训练、两种模型的INT8量化及精度对比。关键点在于:QAT在训练过程中插入伪量化节点(Observer + FakeQuantize),使模型权重和激活分布适应量化误差。
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
from torch.ao.quantization import (
    QuantStub, DeQuantStub, prepare_qat, convert, get_default_qat_qconfig
)

# ---------- 1. LeNet模型定义(含量化桩) ----------
class LeNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.quant = QuantStub()
        self.features = nn.Sequential(
            nn.Conv2d(1, 6, 5, padding=2), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(6, 16, 5), nn.ReLU(),
            nn.MaxPool2d(2),
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(16 * 5 * 5, 120), nn.ReLU(),
            nn.Linear(120, 84), nn.ReLU(),
            nn.Linear(84, 10),
        )
        self.dequant = DeQuantStub()

    def forward(self, x):
        x = self.quant(x)
        x = self.features(x)
        x = self.classifier(x)
        x = self.dequant(x)
        return x

# ---------- 2. 训练/评估工具 ----------
def train_one_epoch(model, loader, optimizer, criterion):
    model.train()
    total_loss, correct, total = 0, 0, 0
    for data, target in loader:
        optimizer.zero_grad()
        output = model(data)
        loss = criterion(output, target)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
        correct += (output.argmax(1) == target).sum().item()
        total += target.size(0)
    return total_loss / len(loader), correct / total

@torch.no_grad()
def evaluate(model, loader):
    model.eval()
    correct, total = 0, 0
    for data, target in loader:
        output = model(data)
        correct += (output.argmax(1) == target).sum().item()
        total += target.size(0)
    return correct / total

# ---------- 3. 数据加载 ----------
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))
])
train_loader = torch.utils.data.DataLoader(
    datasets.MNIST('./data', train=True, download=True, transform=transform),
    batch_size=128, shuffle=True)
test_loader = torch.utils.data.DataLoader(
    datasets.MNIST('./data', train=False, download=True, transform=transform),
    batch_size=256)

# ---------- 4. 普通训练 ----------
def train_vanilla():
    model = LeNet()
    optimizer = optim.Adam(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()
    for epoch in range(3):
        train_one_epoch(model, train_loader, optimizer, criterion)
    return model

# ---------- 5. 量化感知训练 ----------
def train_qat():
    model = LeNet()
    # 配置QAT:使用默认的8位对称量化配置
    model.qconfig = get_default_qat_qconfig('fbgemm')
    prepare_qat(model, inplace=True)
    optimizer = optim.Adam(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()
    for epoch in range(3):
        train_one_epoch(model, train_loader, optimizer, criterion)
    # 将QAT模型转换为推理形态(融合BN并冻结量化参数)
    model.eval()
    convert(model, inplace=True)
    return model

# ---------- 6. 后训练静态量化(用于对比) ----------
def post_training_quantize(model):
    model.eval()
    model.qconfig = get_default_qat_qconfig('fbgemm')
    # 准备校准数据(取100个batch)
    calib_data = []
    for i, (data, _) in enumerate(train_loader):
        if i >= 100:
            break
        calib_data.append(data)
    from torch.ao.quantization import prepare
    prepare(model, inplace=True)
    with torch.no_grad():
        for batch in calib_data:
            model(batch)
    convert(model, inplace=True)
    return model

# ---------- 7. 主流程:训练与对比 ----------
if __name__ == '__main__':
    # 普通训练 + 后训练量化
    print("训练普通模型...")
    vanilla_model = train_vanilla()
    vanilla_acc = evaluate(vanilla_model, test_loader)
    print(f"普通模型精度: {vanilla_acc:.4f}")

    quantized_ptq = post_training_quantize(vanilla_model)
    ptq_acc = evaluate(quantized_ptq, test_loader)
    print(f"后训练量化精度: {ptq_acc:.4f}")

    # 量化感知训练
    print("训练QAT模型...")
    qat_model = train_qat()
    qat_acc = evaluate(qat_model, test_loader)
    print(f"QAT量化模型精度: {qat_acc:.4f}")

    # 对比结果
    print(f"\n精度对比: 普通={vanilla_acc:.4f} | PTQ={ptq_acc:.4f} | QAT={qat_acc:.4f}")
    print(f"量化损失: PTQ={vanilla_acc - ptq_acc:.4f} | QAT={vanilla_acc - qat_acc:.4f}")
运行方式
# 安装依赖(如未安装)
pip install torch torchvision

# 运行脚本(首次运行会自动下载MNIST数据集)
python qat_lenet.py
验证方法与通过标准
- 预期输出特征:普通模型精度约99%,后训练量化(PTQ)精度可能下降至97-98%,而QAT量化模型精度应接近普通模型(通常差距<0.5%)。
- 判定通过:QAT量化模型的精度显著高于PTQ模型(例如高0.5个百分点以上),且与普通模型精度差距在1%以内,说明量化感知训练有效缓解了量化精度损失。
- 附加检查:打印模型结构时,QAT模型应包含
QuantizedConv2d等量化层,而普通模型为浮点层。
常见问题
- QAT训练不收敛:确认已调用
prepare_qat且模型包含QuantStub/DeQuantStub;学习率可适当调低(如5e-4)。 - 量化后推理报错:确保在
convert前调用model.eval(),且输入数据为浮点张量(量化桩会自动处理)。 - 精度反而下降:检查是否在QAT训练时使用了过大的学习率或过少的epoch;QAT通常需要比普通训练更长的训练周期。