1. 基于TensorFlow的MNIST模型后训练动态范围量化
任务目标
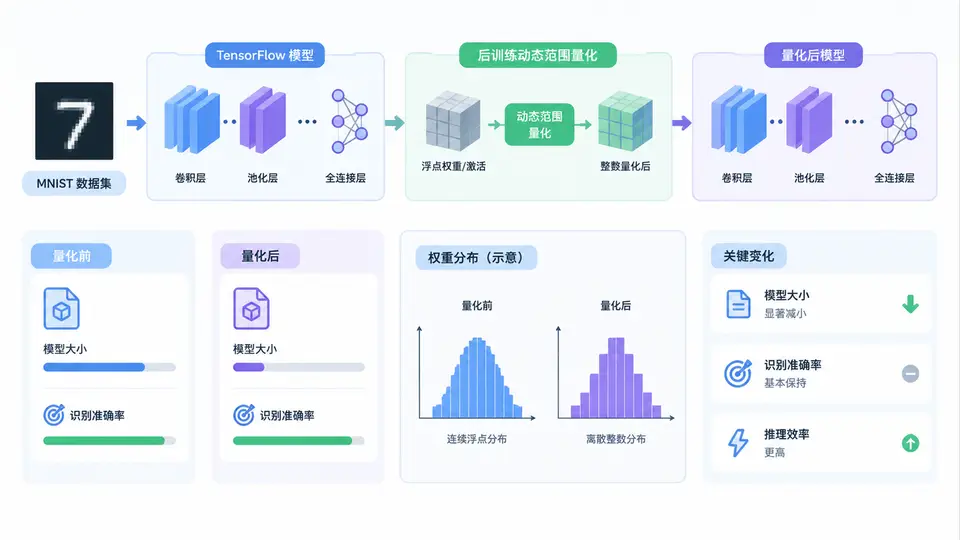
使用TensorFlow 2.x训练一个MNIST手写数字识别模型,通过后训练动态范围量化(Post-Training Dynamic Range Quantization)将权重从FP32压缩为INT8,并对比量化前后的模型文件大小与推理准确率。
环境依赖
- Python 3.8+
- TensorFlow 2.13+(含TFLite Converter)
- NumPy
完整实现代码
import tensorflow as tf
import numpy as np
import os
import tempfile

# 1. 加载MNIST数据
(x_train, y_train), (x_test, y_test) = tf.keras.datasets.mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

# 2. 训练简单CNN模型
model = tf.keras.Sequential([
    tf.keras.layers.Reshape((28, 28, 1), input_shape=(28, 28)),
    tf.keras.layers.Conv2D(8, (3, 3), activation='relu'),
    tf.keras.layers.MaxPooling2D((2, 2)),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])

model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

# 3. 训练(为节省时间仅训练2个epoch)
model.fit(x_train, y_train, epochs=2, validation_data=(x_test, y_test), verbose=2)

# 4. 保存原始Keras模型
_, keras_path = tempfile.mkstemp(suffix='.h5')
model.save(keras_path)
original_size = os.path.getsize(keras_path)

# 5. 转换为TFLite并应用动态范围量化
converter = tf.lite.TFLiteConverter.from_keras_model(model)
converter.optimizations = [tf.lite.Optimize.DEFAULT]  # 动态范围量化
tflite_quant_model = converter.convert()

# 6. 保存量化模型
_, tflite_path = tempfile.mkstemp(suffix='.tflite')
with open(tflite_path, 'wb') as f:
    f.write(tflite_quant_model)
quantized_size = os.path.getsize(tflite_path)

# 7. 评估量化前后准确率
def evaluate_tflite_model(interpreter, x_test, y_test):
    input_details = interpreter.get_input_details()
    output_details = interpreter.get_output_details()
    interpreter.allocate_tensors()

    correct = 0
    for i in range(len(x_test)):
        input_data = np.expand_dims(x_test[i], axis=0).astype(np.float32)
        interpreter.set_tensor(input_details[0]['index'], input_data)
        interpreter.invoke()
        output = interpreter.get_tensor(output_details[0]['index'])
        if np.argmax(output) == y_test[i]:
            correct += 1
    return correct / len(x_test)

# 原始模型准确率
original_loss, original_acc = model.evaluate(x_test, y_test, verbose=0)

# 量化模型准确率
interpreter = tf.lite.Interpreter(model_path=tflite_path)
quantized_acc = evaluate_tflite_model(interpreter, x_test, y_test)

# 8. 输出对比结果
print(f"原始模型大小: {original_size / 1024:.2f} KB")
print(f"量化模型大小: {quantized_size / 1024:.2f} KB")
print(f"大小压缩比: {original_size / quantized_size:.2f}x")
print(f"原始模型准确率: {original_acc:.4f}")
print(f"量化模型准确率: {quantized_acc:.4f}")
print(f"准确率变化: {quantized_acc - original_acc:+.4f}")
运行方式
- 安装依赖:
pip install tensorflow numpy - 将上述代码保存为
mnist_quantization.py - 执行:
python mnist_quantization.py
验证方法与判定标准
- 模型大小:量化后的.tflite文件应明显小于原始.h5文件(通常压缩比在3~5倍之间)。
- 准确率:量化前后准确率差异应小于1%(即
quantized_acc与original_acc之差值小于0.01)。 - 运行输出:程序正常结束并打印上述5项指标,无报错。
关键说明
- 动态范围量化仅将权重量化为INT8,激活值在推理时动态量化,因此无需校准数据集。
- 本案例使用2个epoch训练仅为演示流程,实际部署建议训练至收敛(约5~10个epoch)以获得更高基准准确率。
- 若需进一步压缩,可结合全整型量化(需代表性数据集校准),但动态范围量化是零成本的最简方案。