3. 第一个TensorRT-LLM推理程序
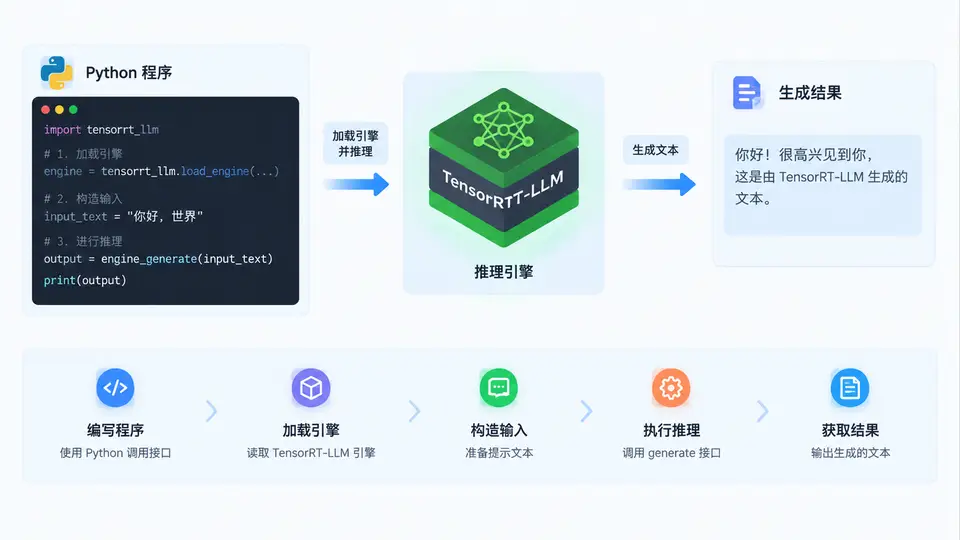
任务目标
编写一个Python程序,使用TensorRT-LLM的Python API加载已构建的引擎文件,对输入提示词执行一次自回归文本生成,并输出生成的序列。
前置条件
- 已安装TensorRT-LLM(版本≥0.10.0),且环境变量
TRT_LLM_ROOT指向其安装目录。 - 已通过
trtllm-build命令生成引擎文件llama_engine.trt(以LLaMA-7B为例)。若尚未构建,可参考案例2完成构建。 - 模型词表文件
tokenizer.model(与构建引擎时使用的分词器一致)。
完整实现代码
import argparse
from pathlib import Path
import torch
from transformers import LlamaTokenizer
from tensorrt_llm.runtime import ModelRunnerCpp

def parse_args():
    parser = argparse.ArgumentParser(description="TensorRT-LLM单次推理示例")
    parser.add_argument("--engine_dir", type=str, required=True,
                        help="包含引擎文件的目录")
    parser.add_argument("--tokenizer_dir", type=str, required=True,
                        help="分词器目录(含tokenizer.model)")
    parser.add_argument("--prompt", type=str, default="The capital of France is",
                        help="输入提示词")
    parser.add_argument("--max_new_tokens", type=int, default=32,
                        help="最大生成数")
    return parser.parse_args()

def main():
    args = parse_args()
    engine_dir = Path(args.engine_dir)
    tokenizer_dir = Path(args.tokenizer_dir)

    # 1. 初始化分词器
    tokenizer = LlamaTokenizer.from_pretrained(str(tokenizer_dir))

    # 2. 初始化推理Runner(C++后端,性能最优)
    runner = ModelRunnerCpp.from_dir(
        engine_dir=str(engine_dir),
        lora_dir=None,
        rank=0,
        debug_mode=False,
        gpu_weights_per_partition=False
    )

    # 3. 编码输入
    input_ids = tokenizer(args.prompt, return_tensors="pt").input_ids
    input_lengths = torch.tensor([input_ids.shape[1]], dtype=torch.int32)

    # 4. 执行推理
    outputs = runner.generate(
        batch_input_ids=input_ids,
        max_new_tokens=args.max_new_tokens,
        end_id=tokenizer.eos__id,
        pad_id=tokenizer.pad__id,
        temperature=0.7,
        top_k=50,
        top_p=0.9,
        repetition_penalty=1.0,
        stop_words_list=None,
    )

    # 5. 解码输出
    output_ids = outputs["output_ids"].cpu().tolist()
    generated_text = tokenizer.decode(output_ids[0], skip_special_tokens=True)
    print(f"输入: {args.prompt}")
    print(f"生成: {generated_text}")

if __name__ == "__main__":
    main()
运行方式
python trt_llm_infer.py \
    --engine_dir ./llama_engine \
    --tokenizer_dir ./llama_tokenizer \
    --prompt "The capital of France is" \
    --max_new_tokens 32
验证方法与通过标准
- 程序正常退出:无CUDA错误、无段错误,退出码为0。
- 输出合理性:对于示例提示词,生成文本应包含"Paris"或语义等价的法语城市名(如"Lyon"),且长度不超过
max_new_tokens。 - 性能参考:在单张A100上,LLaMA-7B生成32个的耗时通常在0.5~2秒量级(具体取决于GPU型号)。若耗时超过10秒,检查GPU利用率或引擎是否使用了FP16。
- 可重复性:连续运行两次,在相同输入和随机种子下(当前未固定seed,若需复现可设置
torch.manual_seed(42)),输出应基本一致(受采样影响可能有微小差异)。
关键说明
ModelRunnerCpp是TensorRT-LLM推荐的C++后端封装,相比Python版ModelRunner具有更低延迟。若需使用Python后端,可替换为from tensorrt_llm.runtime import ModelRunner并调整初始化参数。- 引擎文件必须与当前GPU架构匹配(如Ampere架构的引擎不能在Hopper上运行)。若出现
engine could not be loaded错误,请重新构建引擎。 - 分词器必须与构建引擎时使用的完全一致,否则 ID映射错误会导致乱码输出。
- 若提示词过长超出引擎的
max_input_len,程序会报错。可通过trtllm-build --max_input_len参数调整。
常见问题排查
| 现象 | 可能原因 | 解决方案 |
|---|---|---|
| ImportError: libnvinfer.so | TensorRT库路径未加入LD_LIBRARY_PATH | export LD_LIBRARY_PATH=$TRT_LLM_ROOT/lib:$LD_LIBRARY_PATH |
| RuntimeError: out of memory | GPU显存不足 | 减小max_new_tokens,或使用更小的batch size(当前为1) |
生成结果全为<unk> | 分词器与引擎不匹配 | 确认tokenizer_dir与构建引擎时使用的分词器路径一致 |