1. 环境搭建与TensorRT-LLM安装
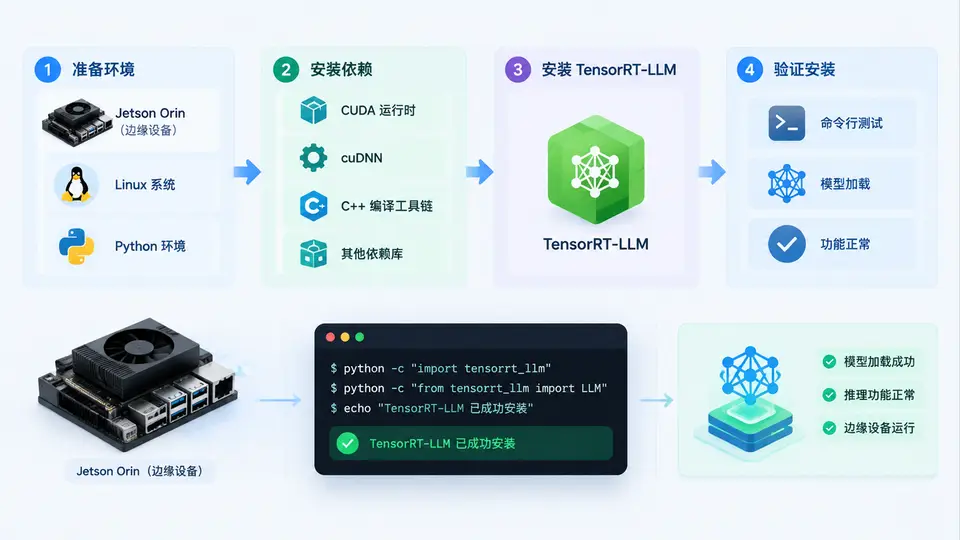
任务目标
在Jetson Orin(JetPack 5.1.2或更高版本)上完成TensorRT-LLM的安装,并通过运行内置的示例验证安装成功。本案例覆盖从环境检查到运行推理验证的完整闭环。
环境要求
- 硬件:Jetson Orin系列(AGX Orin 32GB/64GB或NX 16GB)
- 系统:JetPack 5.1.2+(含CUDA 11.4、cuDNN 8.6、TensorRT 8.5.2)
- 存储:至少20GB可用空间(模型与依赖)
- Python:3.8(JetPack自带)
安装步骤
TensorRT-LLM在Jetson平台通过预编译wheel包安装,无需从源码编译。以下命令在Jetson终端执行:
# 1. 确认JetPack版本
sudo apt show nvidia-jetpack | grep Version

# 2. 安装系统依赖
sudo apt-get update
sudo apt-get install -y python3-pip git-lfs

# 3. 安装TensorRT-LLM(Jetson专用wheel)
pip3 install tensorrt-llm==0.10.0.dev

# 4. 验证安装
python3 -c "import tensorrt_llm; print(tensorrt_llm.__version__)"若第3步因网络原因失败,可使用镜像源:pip3 install tensorrt-llm==0.10.0.dev -i https://pypi.tuna.tsinghua.edu.cn/simple
验证安装:运行示例
TensorRT-LLM自带 6B示例,通过构建引擎并执行文本生成来验证完整功能链路。以下命令在tensorrt_llm/examples/目录下执行:
# 1. 克隆示例仓库(若未随wheel安装)
git clone https://github.com/NVIDIA/TensorRT-LLM.git
cd TensorRT-LLM/examples/

# 2. 下载模型权重(约12GB,需较长时间)
python3 download_model.py --model_size=6b

# 3. 构建TensorRT引擎(耗时约10-15分钟)
python3 build.py --model_dir=./-6b \
                 --dtype=float16 \
                 --use__plugin=float16 \
                 --use_gemm_plugin=float16 \
                 --output_dir=./engine

# 4. 运行文本生成测试
python3 run.py --engine_dir=./engine \
               --max_output_len=50 \
               --input_text="Hello, I am"
判定标准
安装成功的判定条件如下,需全部满足:
import tensorrt_llm无报错,且打印的版本号以0.10.0开头- 引擎构建过程无报错,最终生成
engine/目录且包含_float16_tp1_rank0.engine文件 - 运行
run.py后,终端输出一段连贯的英文文本(例如以"Hello, I am"开头的自然语言续写),而非报错或空输出
常见问题
- pip安装超时:Jetson网络带宽有限,建议使用镜像源或设置
--timeout=120 - 显存不足:构建引擎时若报OOM,在
build.py命令后追加--max_batch_size=1 --max_input_len=128降低资源占用 - 版本冲突:若已安装其他版本的TensorRT,先执行
pip3 uninstall tensorrt-llm后重装
本案例仅覆盖安装与验证路径,不涉及模型微调或自定义算子。若需在自有模型上使用TensorRT-LLM,请参考后续案例中的模型转换与引擎构建流程。