1. 环境搭建与基础验证
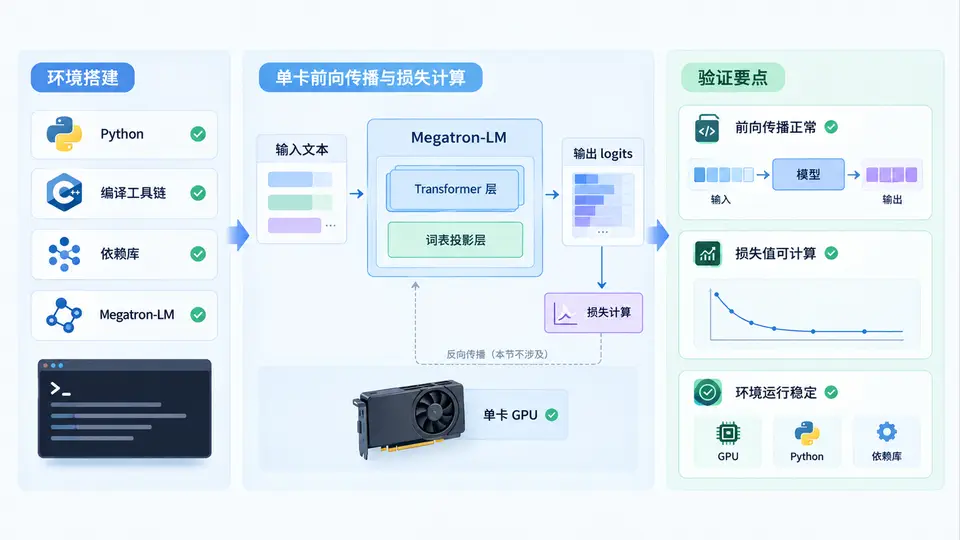
任务目标
本案例完成Megatron-LM最小运行环境的搭建,并在单张GPU上执行一次前向传播与损失计算,验证框架安装正确、模型可初始化且损失值为有限数值。
环境依赖
- Python 3.8+,PyTorch 1.13+(建议2.x),CUDA 11.8+
- NVIDIA GPU(显存≥8GB),驱动已正确安装
- Megatron-LM核心代码(非官方megatron-lm包,需从源码安装)
# 安装Megatron-LM(核心依赖为pybind11与ninja)
git clone https://github.com/NVIDIA/Megatron-LM.git
cd Megatron-LM
pip install -e .
# 验证GPU可用
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.get_device_name(0))"
关键完整代码
以下代码为最小可复现实现:初始化一个6层、隐藏维度128的模型,构造随机输入,执行前向传播并计算交叉熵损失。代码直接调用Megatron-LM的模型构建接口,不依赖额外配置文件。
import torch
import torch.nn.functional as F
from megatron.core.models.
from megatron.core.transformer.spec_utils import ModuleSpec
from megatron.core.models._layer_specs import get__local_spec
from megatron.core import parallel_state, tensor_parallel
from megatron.core.transformer.custom_layers.transformer_engine import (
    TELayerNormColumnParallelLinear,
    TERowParallelLinear,
    TEDotProductAttention,
    TETransformerMLP,
)

def init_megatron_env():
    """初始化Megatron所需的分布式环境(单卡场景)"""
    torch.distributed.init_process_group(
        backend="nccl",
        init_method="tcp://localhost:29500",
        world_size=1,
        rank=0,
    )
    parallel_state.initialize_model_parallel(
        tensor_model_parallel_size=1,
        pipeline_model_parallel_size=1,
    )

def build_model():
    """构建最小模型(6层,hidden=128,词表=1000)"""
    spec = ModuleSpec(
        module=,
        submodules={
            "language_model": ModuleSpec(
                module=,
                submodules={
                    "encoder": ModuleSpec(
                        module=,
                        submodules={
                            "layers": get__local_spec(),
                        },
                    ),
                },
            ),
        },
    )
    # 简化:直接使用的standard初始化路径
    model = (
        config={
            "num_layers": 6,
            "hidden_size": 128,
            "num_attention_heads": 8,
            "seq_length": 64,
            "vocab_size": 1000,
            "ffn_hidden_size": 512,
            "num_tokentypes": 0,
            "parallel_output": True,
            "layernorm_epsilon": 1e-5,
            "init_method_std": 0.02,
            "use_cpu_initialization": False,
            "perform_initialization": True,
            "fp16": False,
            "bf16": False,
            "params_dtype": torch.float32,
        },
        transformer_layer_spec=get__local_spec(),
        vocab_size=1000,
        max_sequence_length=64,
    )
    return model

def main():
    init_megatron_env()
    torch.cuda.set_device(0)

    model = build_model().cuda()
    model.eval()

    # 构造随机输入:batch=2, seq_len=64
    input_ids = torch.randint(0, 1000, (2, 64)).cuda()
    position_ids = torch.arange(64).unsqueeze(0).expand(2, -1).cuda()
    attention_mask = torch.ones(2, 1, 64, 64).cuda()

    with torch.no_grad():
        logits = model(input_ids, position_ids, attention_mask)
        # logits shape: [batch, seq, vocab]
        loss = F.cross_entropy(
            logits.view(-1, logits.size(-1)),
            input_ids.view(-1),
            ignore_index=-1,
        )

    print(f"Logits shape: {list(logits.shape)}")
    print(f"Loss value: {loss.item():.4f}")
    assert torch.isfinite(loss), "Loss must be finite"
    assert loss.item() > 0, "Loss should be positive for random init"
    print("Single-card forward & loss verification PASSED")

if __name__ == "__main__":
    main()
运行方式
# 单卡运行(需在Megatron-LM仓库根目录下执行)
python verify_single_card.py
验证方法与判定标准
- 通过条件1:程序无异常退出,输出Logits shape为
[2, 64, 1000] - 通过条件2:Loss值为有限正数(随机初始化时通常为
log(1000)≈6.9附近),且断言isfinite通过 - 通过条件3:若出现
ImportError或CUDA out of memory,说明环境配置不完整或GPU显存不足
常见问题
- 分布式初始化失败:确认
torch.distributed.init_process_group的端口未被占用,或改用env://方式并设置MASTER_ADDR/PORT环境变量 - Transformer Engine依赖:若未安装TE,可将
get__local_spec()替换为get__with_transformer_engine_spec()并安装transformer-engine;本案例默认使用纯PyTorch实现路径 - 显存不足:将
seq_length降至32或hidden_size降至64