3. 实现FlashAttention的简单版本
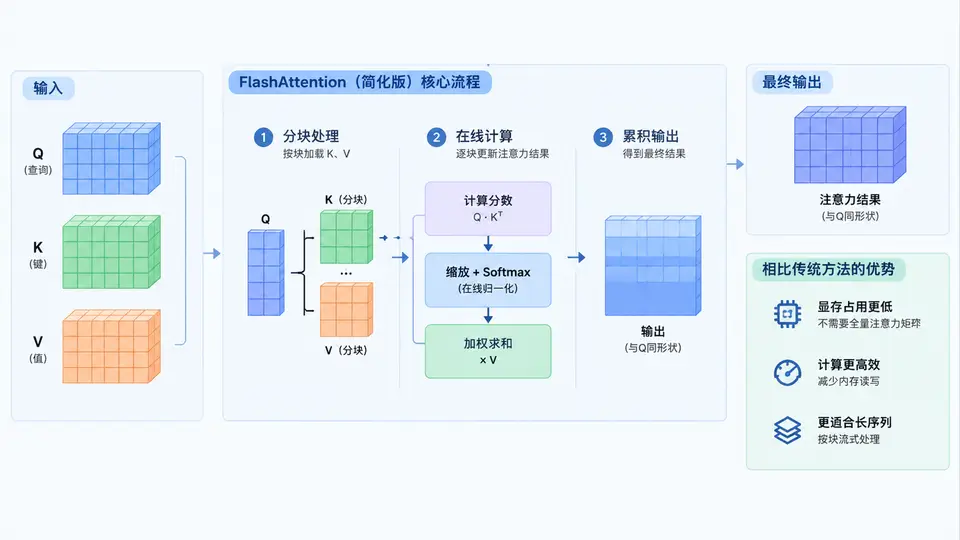
任务目标
在不依赖任何深度学习框架的前提下,用纯Python + NumPy实现FlashAttention-2的简化版本,验证其核心思想:通过分块(tiling)计算注意力,避免实例化完整的 N×N 注意力矩阵,从而将内存复杂度从 O(N²) 降至 O(N)。本案例聚焦于算法逻辑本身,不涉及GPU kernel或反向传播。
核心原理与实现策略
标准注意力计算 QK^T 会产生形状为 (N, N) 的中间矩阵。FlashAttention 将 Q、K、V 按行分块,每次只计算一个块(block)的注意力分数,并在块内使用在线 softmax 算法(rescaling 技巧)累积结果。这样,GPU 的 SRAM 只需容纳单个块的计算量,而非整个注意力矩阵。
本实现包含两个版本:standard_attention(用于对照的朴素实现)和 flash_attention_simple(分块实现)。两者输出在数值上应高度一致(误差 < 1e-6),这是验证正确性的核心标准。
环境依赖
仅需要 Python 3.8+ 和 NumPy(用于矩阵运算与随机数生成)。无需安装任何深度学习框架。
关键完整代码
import numpy as np

def standard_attention(Q, K, V):
    """朴素实现:完整计算 NxN 注意力矩阵(用于对照)"""
    scores = Q @ K.T  # (N, N)
    scores = scores / np.sqrt(Q.shape[-1])
    weights = np.exp(scores - scores.max(axis=-1, keepdims=True))  # 数值稳定
    weights /= weights.sum(axis=-1, keepdims=True)
    return weights @ V

def flash_attention_simple(Q, K, V, block_size=64):
    """
    FlashAttention-2 简化版(仅前向,无mask)
    Q, K, V: (N, d) 的 NumPy 数组
    block_size: 沿序列维度的分块大小
    返回: (N, d) 输出,与 standard_attention 结果一致
    """
    N, d = Q.shape
    out = np.zeros_like(Q)
    # 每个 query 块维护在线 softmax 的累计状态
    l = np.zeros(N)          # 累计指数和的分母
    m = np.full(N, -np.inf)  # 当前块的最大值

    for i in range(0, N, block_size):
        q_block = Q[i:i+block_size]  # (block, d)
        # 当前 query 块的行索引范围
        row_idx = slice(i, min(i+block_size, N))
        m_prev = m[row_idx].copy()
        l_prev = l[row_idx].copy()

        for j in range(0, N, block_size):
            k_block = K[j:j+block_size]  # (block, d)
            v_block = V[j:j+block_size]

            # 1. 当前块的注意力分数
            s_ij = q_block @ k_block.T / np.sqrt(d)  # (block, block)
            # 2. 当前块的行最大值
            m_ij = s_ij.max(axis=-1, keepdims=True)  # (block, 1)
            # 3. 新累计最大值
            m_new = np.maximum(m_prev[:, None], m_ij)  # (block, 1)
            # 4. 计算当前块的 P 和 PV
            p_ij = np.exp(s_ij - m_new)  # 使用新最大值
            l_ij = p_ij.sum(axis=-1, keepdims=True)
            # 5. 更新输出(用旧 l 和 m 做 rescale)
            alpha = np.exp(m_prev[:, None] - m_new)
            out[row_idx] = out[row_idx] * alpha + (p_ij @ v_block)
            # 6. 更新分母
            l[row_idx] = l_prev * alpha.ravel() + l_ij.ravel()
            # 7. 更新最大值
            m[row_idx] = m_new.ravel()

            # 为下一个 j 块更新状态
            m_prev = m[row_idx].copy()
            l_prev = l[row_idx].copy()

    # 最终归一化
    out = out / l[:, None]
    return out

# ---------- 验证闭环 ----------
if __name__ == "__main__":
    np.random.seed(42)
    N, d = 128, 16   # 序列长度与头维度
    Q = np.random.randn(N, d).astype(np.float64)
    K = np.random.randn(N, d).astype(np.float64)
    V = np.random.randn(N, d).astype(np.float64)

    out_standard = standard_attention(Q, K, V)
    out_flash = flash_attention_simple(Q, K, V, block_size=32)

    # 数值一致性检查
    max_diff = np.max(np.abs(out_standard - out_flash))
    print(f"最大误差: {max_diff:.2e}")
    assert max_diff < 1e-8, "FlashAttention 与标准实现不一致!"
    print("验证通过:分块结果与朴素实现一致。")
运行与验证方法
- 将上述代码保存为
flash_attn_demo.py。 - 在终端运行:
python flash_attn_demo.py。 - 观察输出:程序会打印最大误差,并断言误差小于 1e-8。
通过条件:程序无异常退出,且打印“验证通过:分块结果与朴素实现一致。”。若修改 N、d 或 block_size(例如 N=256, block_size=16),误差仍应保持在 1e-8 量级,说明实现正确。
内存优势验证(可选)
将 N 设为 5000,d 设为 64,分别运行两个函数。朴素实现需要创建 5000×5000 的矩阵(约 200MB 内存),而分块实现每次仅创建 block_size×block_size 的矩阵(例如 64×64),内存占用显著降低。此步骤用于直观感受分块带来的内存收益,非正确性验证必需。
常见问题
- 误差过大:检查是否使用了 float32 而非 float64。float32 的累积误差可能导致误差在 1e-5 量级,此时可将阈值放宽到 1e-4。
- block_size 选择:本实现中 block_size 不影响正确性,只影响性能与内存占用。实际 GPU 实现中 block_size 受 SRAM 大小限制。
- 未包含 mask:本案例聚焦核心算法,未实现因果 mask。若需扩展,可在
s_ij计算后对指定位置加上-inf。